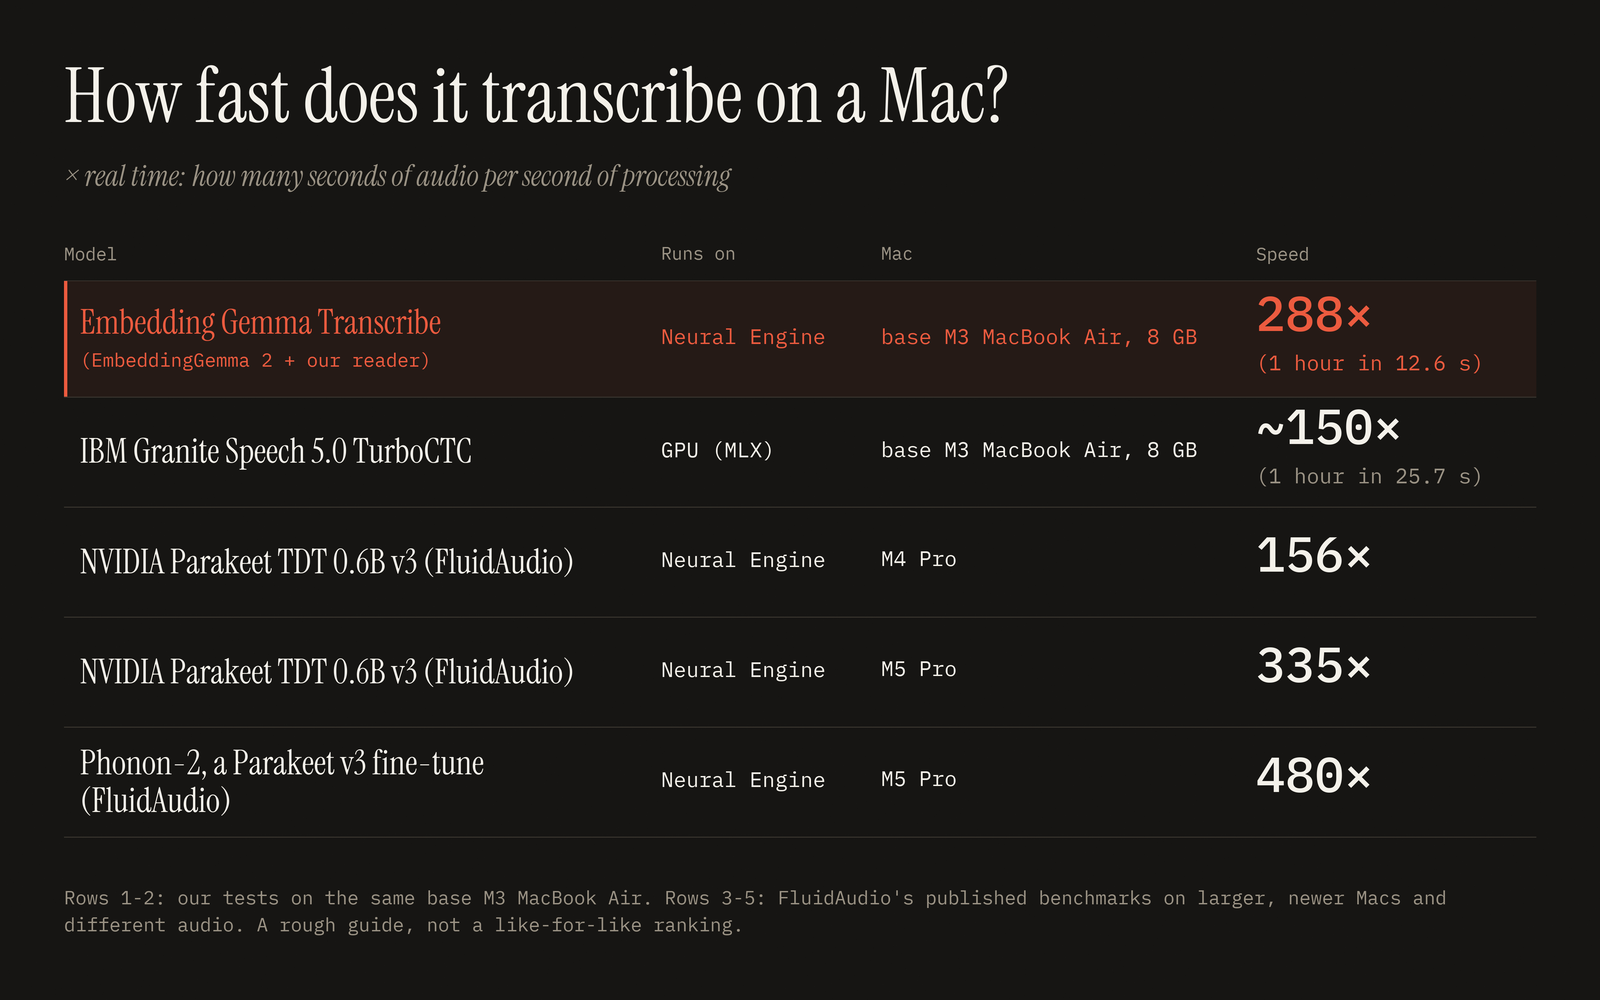
임베딩 모델이 받아쓰기를 한다고?
임베딩 모델은 원래 글을 숫자 벡터로 바꾸는 일만 하는 모델이에요. 벡터는 문장의 의미를 좌표로 찍어둔 거라고 생각하면 돼요. 의미가 비슷한 문장끼리는 좌표도 가깝게 찍히죠. 그래서 검색이나 RAG(검색 증강 생성), 비슷한 문서 찾기에 주로 쓰여요.
그런데 이 임베딩 모델을 음성 인식(STT, Speech-to-Text) 모델로 바꿨다는 실험이 공개됐어요. 뼈대로 쓴 모델은 Google의 경량 임베딩 모델 EmbeddingGemma의 후속작인 EmbeddingGemma 2예요. 문장을 이해하기만 하던 모델에 귀를 달아서 말소리를 받아 적게 만든 거예요. 작은 모델을 휴대폰이나 노트북에서 직접 돌리는 온디바이스 AI가 점점 중요해지고 있어서 더 눈여겨볼 만한 시도예요.
배경: EmbeddingGemma는 어떤 모델인가
1세대 EmbeddingGemma는 2025년 9월에 나왔어요. 파라미터가 약 3억 개(308M)인 아주 작은 모델인데, 100개가 넘는 언어를 다루고 양자화하면 200MB 남짓한 메모리로도 돌아가요. 출력 벡터 길이를 768에서 128까지 줄여도 성능이 크게 떨어지지 않도록 학습했다는 점(마트료시카 표현 학습)도 특징이었어요. 2세대도 작으면서 여러 언어에 강하다는 이 성격을 이어받았어요.
여기서 짚고 갈 점이 하나 있어요. ChatGPT 같은 생성형 모델은 왼쪽에서 오른쪽으로 토큰을 하나씩 써 내려가요. 반면 임베딩 모델은 문장 전체를 앞뒤로 한꺼번에 보고(양방향 어텐션) 의미를 요약해요. 원래는 말을 만들어내는 법을 모르는 모델인 거예요. 그래서 이 모델을 받아쓰기 모델로 바꿨다는 게 신선하게 들리는 거예요.
어떻게 바꿀 수 있을까
이 프로젝트의 정확한 구조, 학습 데이터, 오류율 수치는 원문 페이지에서 직접 확인해보세요. 여기서는 이런 용도 변경이 보통 어떤 원리로 이뤄지는지 풀어볼게요.
먼저 음성을 멜 스펙트로그램이라는 '소리의 사진'으로 바꿔요. 시간에 따라 어떤 주파수가 얼마나 센지 그린 이미지예요. 작은 오디오 인코더가 이 이미지를 짧은 구간(프레임)마다 벡터로 만들어요. 그다음 어댑터라는 얇은 층이 그 벡터를 언어 모델이 알아듣는 크기와 모양으로 맞춰줘요. 해외여행 갈 때 챙기는 변환 플러그 같은 역할이에요.
다음으로 트랜스포머가 앞뒤 맥락을 모두 보면서 각 프레임을 해석해요. 마지막에는 CTC(Connectionist Temporal Classification) 같은 출력층으로 글자를 뽑아내는 방식을 많이 써요. CTC가 뭐냐면, 음성 프레임 수가 글자 수보다 훨씬 많다는 문제를 푸는 기법이에요. 프레임마다 '글자'나 '빈칸'을 예측한 다음, 연속으로 반복된 글자는 하나로 합치고 빈칸은 지워요. 예를 들어 hh_e_ll_l_oo는 hello가 돼요. 빈칸으로 나뉜 l은 두 개 다 남는 거죠.
양방향 모델과 CTC는 궁합이 좋아요. 문장 전체를 한 번에 보고 모든 위치를 동시에 예측하니까 계산 한 번으로 받아쓰기가 끝나거든요. 토큰을 하나씩 생성하는 방식보다 빠르고, 없는 말을 지어내는 '환각'도 구조상 덜해요. 이미 언어를 잘 아는 모델 위에 쌓으니 처음부터 학습할 때보다 적은 음성 데이터로도 학습할 수 있다는 장점도 있고요.
업계 흐름에서 보면
오픈소스 STT의 기준점은 여전히 OpenAI의 Whisper예요. 인코더-디코더 구조라 정확하지만, 토큰을 하나씩 생성하다 보니 느리고 무음 구간에서 없는 문장을 지어내기도 해요. NVIDIA의 Parakeet 계열은 CTC 같은 비생성형 출력으로 속도를 크게 높였어요. Moonshine처럼 엣지 기기를 겨냥한 작은 모델도 나왔고요. 한편 Gemma 3n이나 Voxtral처럼 생성형 LLM에 오디오 입력을 붙이는 흐름도 있어요.
이번 실험은 그 사이 빈자리를 노려요. 거대한 생성형 LLM 대신 작고 빠른 다국어 임베딩 모델을 뼈대로 삼았거든요. 모델을 용도마다 새로 만들지 않고 잘 만든 부품을 조립해서 쓰는 방식이 점점 늘어나고 있다는 걸 보여주는 사례예요.
한국 개발자에게 주는 시사점
온디바이스 STT 선택지가 늘어나요. 회의록, 콜센터, 키오스크처럼 음성이 외부로 나가면 곤란한 서비스라면 로컬에서 돌아가는 작은 모델이 매력적이에요.
한국어 성능은 직접 확인해야 해요. 뼈대 모델이 다국어를 지원해도 STT 성능은 결국 음성 학습 데이터에 달려 있어요. AI Hub에 공개된 한국어 음성 데이터로 파인튜닝해보는 실험도 해볼 만해요.
배워둘 개념이 많아요. 어댑터로 모달리티(텍스트, 음성 같은 데이터 종류)를 잇는 방법, CTC 디코딩, 사전학습 모델을 재활용하는 패턴은 음성이 아닌 문제에도 그대로 써먹을 수 있어요. 실서비스에 넣기 전에는 오류율을 직접 측정하고 Gemma 이용약관도 꼭 확인하세요.
마무리
한 줄 정리: 문장을 이해하기만 하던 작은 임베딩 모델에 귀를 달아 빠르고 가벼운 받아쓰기 모델로 바꾼 실험이에요.
STT를 고를 때 Whisper 같은 큰 범용 모델이 편한가요, 아니면 작고 빠른 특화 모델을 직접 다듬어 쓰는 쪽이 낫다고 보시나요?
🔗 출처: Hacker News