지난 몇 년간 AI 성능이 비약적으로 발전한 배경에는 방대한 학습 데이터가 있었다. 2020년 GPT-3 공개 직후 Gwern이 쓴 에세이 '스케일링 가설'은 최근의 진보가 결국 규모의 산물이라고 주장했다. 더 큰 모델, 더 큰 데이터셋, 더 많은 학습 연산이 쌓이면서 신경망이 점점 더 똑똑해졌다는 것이다. 익명의 연구자 Nostalgebraist도 2024년에 "지금의 지형 전체는 더 많은 데이터로 학습할수록 모델이 꾸준하고 예측 가능하게 좋아진다는 깨달음에서 비롯됐다"고 정리했다. Epoch AI에 따르면 2010년대 초 이후 언어모델 학습 데이터셋 크기는 약 6개월마다 두 배로 늘었고, 오늘날 최대 규모 모델은 수십조 토큰으로 학습된다.
문제는 AI를 로봇에 적용하려 할 때 이 공식이 그대로 통하지 않는다는 점이다. 언어모델은 인터넷에서 긁어모은 기존 텍스트 말뭉치로 학습할 수 있었다. GPT-3는 약 3천억 토큰으로 훈련됐고, Epoch AI는 2024년 기준 접근 가능한 양질의 텍스트 총량을 약 300조 토큰으로 추정했다. 그러나 로봇에는 이에 상응하는 공개된 양질의 학습 데이터 더미가 존재하지 않는다. 데이터를 어디서, 얼마나 확보할 것인가가 로보틱스 분야의 핵심 난제로 떠오른 이유다.
실제 로봇으로 데이터를 만드는 길
모델 학습은 근본적으로 '올바르게 수행된 사례'를 대량으로 보여주는 과정이다. 텍스트는 글 한 덩어리의 앞부분을 주고 다음을 예측시키는 식으로 한 문서에서 여러 학습 예시를 뽑아낼 수 있다. 반면 로봇의 학습 예시는 어떤 작업을 수행하거나 시도한 기록이어야 한다. 가장 전통적인 방식은 '원격조작(teleoperation)'이다. 사람이 로봇과 직접 연결된 컨트롤러를 조작해 셔츠 개기, 물 따르기 같은 작업을 수행하면, 로봇의 상태 데이터와 카메라 영상이 함께 기록돼 학습 예시가 된다. 전문가(사람)의 시연을 모델이 모방하도록 하는 이 전략을 행동 복제(behavioral cloning), 넓게는 모방 학습이라 부른다.
원격조작의 장점은 실제 학습 대상 로봇에서 데이터가 나오기 때문에 로봇의 실제 운동 능력과 아주 잘 맞아떨어진다는 데 있다. 하지만 비용이 가장 큰 걸림돌이다. 실제 로봇과 그것을 조작할 사람이 반드시 필요해 대량 생산이 어렵다. 게다가 사람이 조작할 때 물체에서 오는 촉각 피드백을 받지 못해 정교한 조작 데이터를 얻기 힘들고, 전체 수집 데이터 중 실제 학습에 쓸 만한 것은 일부에 불과하다고 알려져 있다. 로봇이 스스로 움직이게 하고 성공 여부를 채점하는 강화학습도 있다. 구글은 2016년 무렵 로봇팔들이 자율적으로 물체를 집는지로 성공을 판정하는 '암 팜(arm farm)'을 운영했다.
시뮬레이션과 사람 영상이라는 대안
업계가 자주 말하는 이상적 구조는 '데이터 플라이휠'이다. 현실에 배치된 로봇의 데이터로 더 나은 모델을 만들고, 그것이 더 많은 배치로 이어지는 선순환이다. 로봇 AI 기업 피지컬 인텔리전스(Physical Intelligence)는 사무실 근처 초콜릿 공장에서 이런 초기 플라이휠을 실험하고 있다. 다만 지금은 실제 업무에 투입된 AI 로봇 수가 극히 적고, 현실 데이터는 같은 작업을 비슷한 조건에서 반복하는 경향이 강해 학습 가치가 떨어진다. 그래서 당분간 데이터 대부분은 다른 출처에서 와야 한다.
그 유력한 대안이 시뮬레이션이다. 물리 로봇 대신 가상 세계에서 디지털 로봇을 돌리는 방식으로, 수천 대를 동시에 시뮬레이션해 저렴하고 빠르게 대량의 데이터를 얻는다. 피규어 AI(Figure AI)는 수천 대의 가상 로봇 강화학습으로 휴머노이드의 보행을 가르쳤고, 오픈AI는 로봇 손이 1만 3천 년에 해당하는 가상 경험으로 루빅큐브를 풀도록 훈련했다. 웨이모는 2019년까지 현실에서 1천만 마일을 주행하는 동안 시뮬레이션에서는 100억 마일을 달렸다. 교사 모델이 가상 환경의 모든 정보를 보고, 카메라 영상과 내부 상태만 보는 학생 모델이 이를 모방하게 하는 교사/학생 패러다임도 쓰인다.
시뮬레이션의 약점은 데이터 품질이 시뮬레이션 정확도에 좌우된다는 것이다. 지형 보행이나 비행처럼 비교적 잘 규명된 운동은 현실과 근사하게 재현되지만, 부드럽거나 변형되는 물체의 조작은 정확히 모사하기 어렵다. 이것이 '심투리얼 갭(sim-to-real gap)'이다. 이를 메우려 마찰 같은 파라미터를 무작위로 변화시키는 '도메인 랜덤화'가 쓰이고, 오픈AI는 환경 난도를 끝없이 키우는 자동 도메인 랜덤화(ADR)까지 개발했다. 그럼에도 가장 어려운 초기 배열에서 루빅큐브 성공률은 20%에 그쳤는데, 이 점이 조작 훈련에서 해당 기법이 널리 쓰이지 않는 이유로 보인다. 반면 보행 훈련에서 마찰계수를 무작위로 바꾸는 식의 환경 파라미터 랜덤화는 상당히 표준적이다.
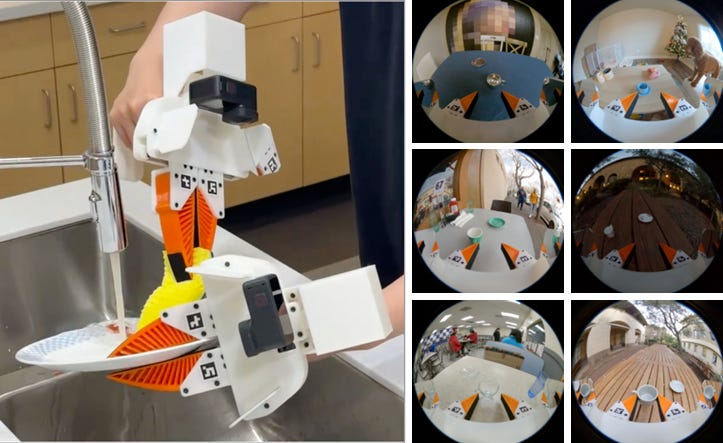
마지막 길은 사람의 작업을 기록해 로봇 동작으로 변환하는 방식이다. 사람에게 머리 장착형 카메라를 씌워 손으로 작업하는 모습을 1인칭(에고센트릭) 영상으로 찍고, 이를 로봇 동작으로 해석해 학습 예시를 만든다. 로보틱스에서 휴머노이드 형태가 인기 있는 한 이유도 사람의 작업이 꽤 쓸 만한 데이터원이 되기 때문이다. 엔비디아는 아이작 GR00T 플랫폼으로 원격조작 데이터를 입력 삼아 합성 학습 데이터를 생성하는 방법을 제시했고, 합성 데이터는 자율주행차 훈련에서도 널리 쓰인다. 피규어 AI는 사람들에게 카메라를 보내 작업을 녹화하게 하는 'Index' 프로그램을, 시프트(Shift) 같은 기업도 유사한 수집을 진행 중이다. 결국 어떤 단일 출처도 완전하지 않으며, 로봇 분야의 다음 경쟁은 이 여러 데이터 파이프라인을 얼마나 영리하게 조합하느냐에 달려 있다.