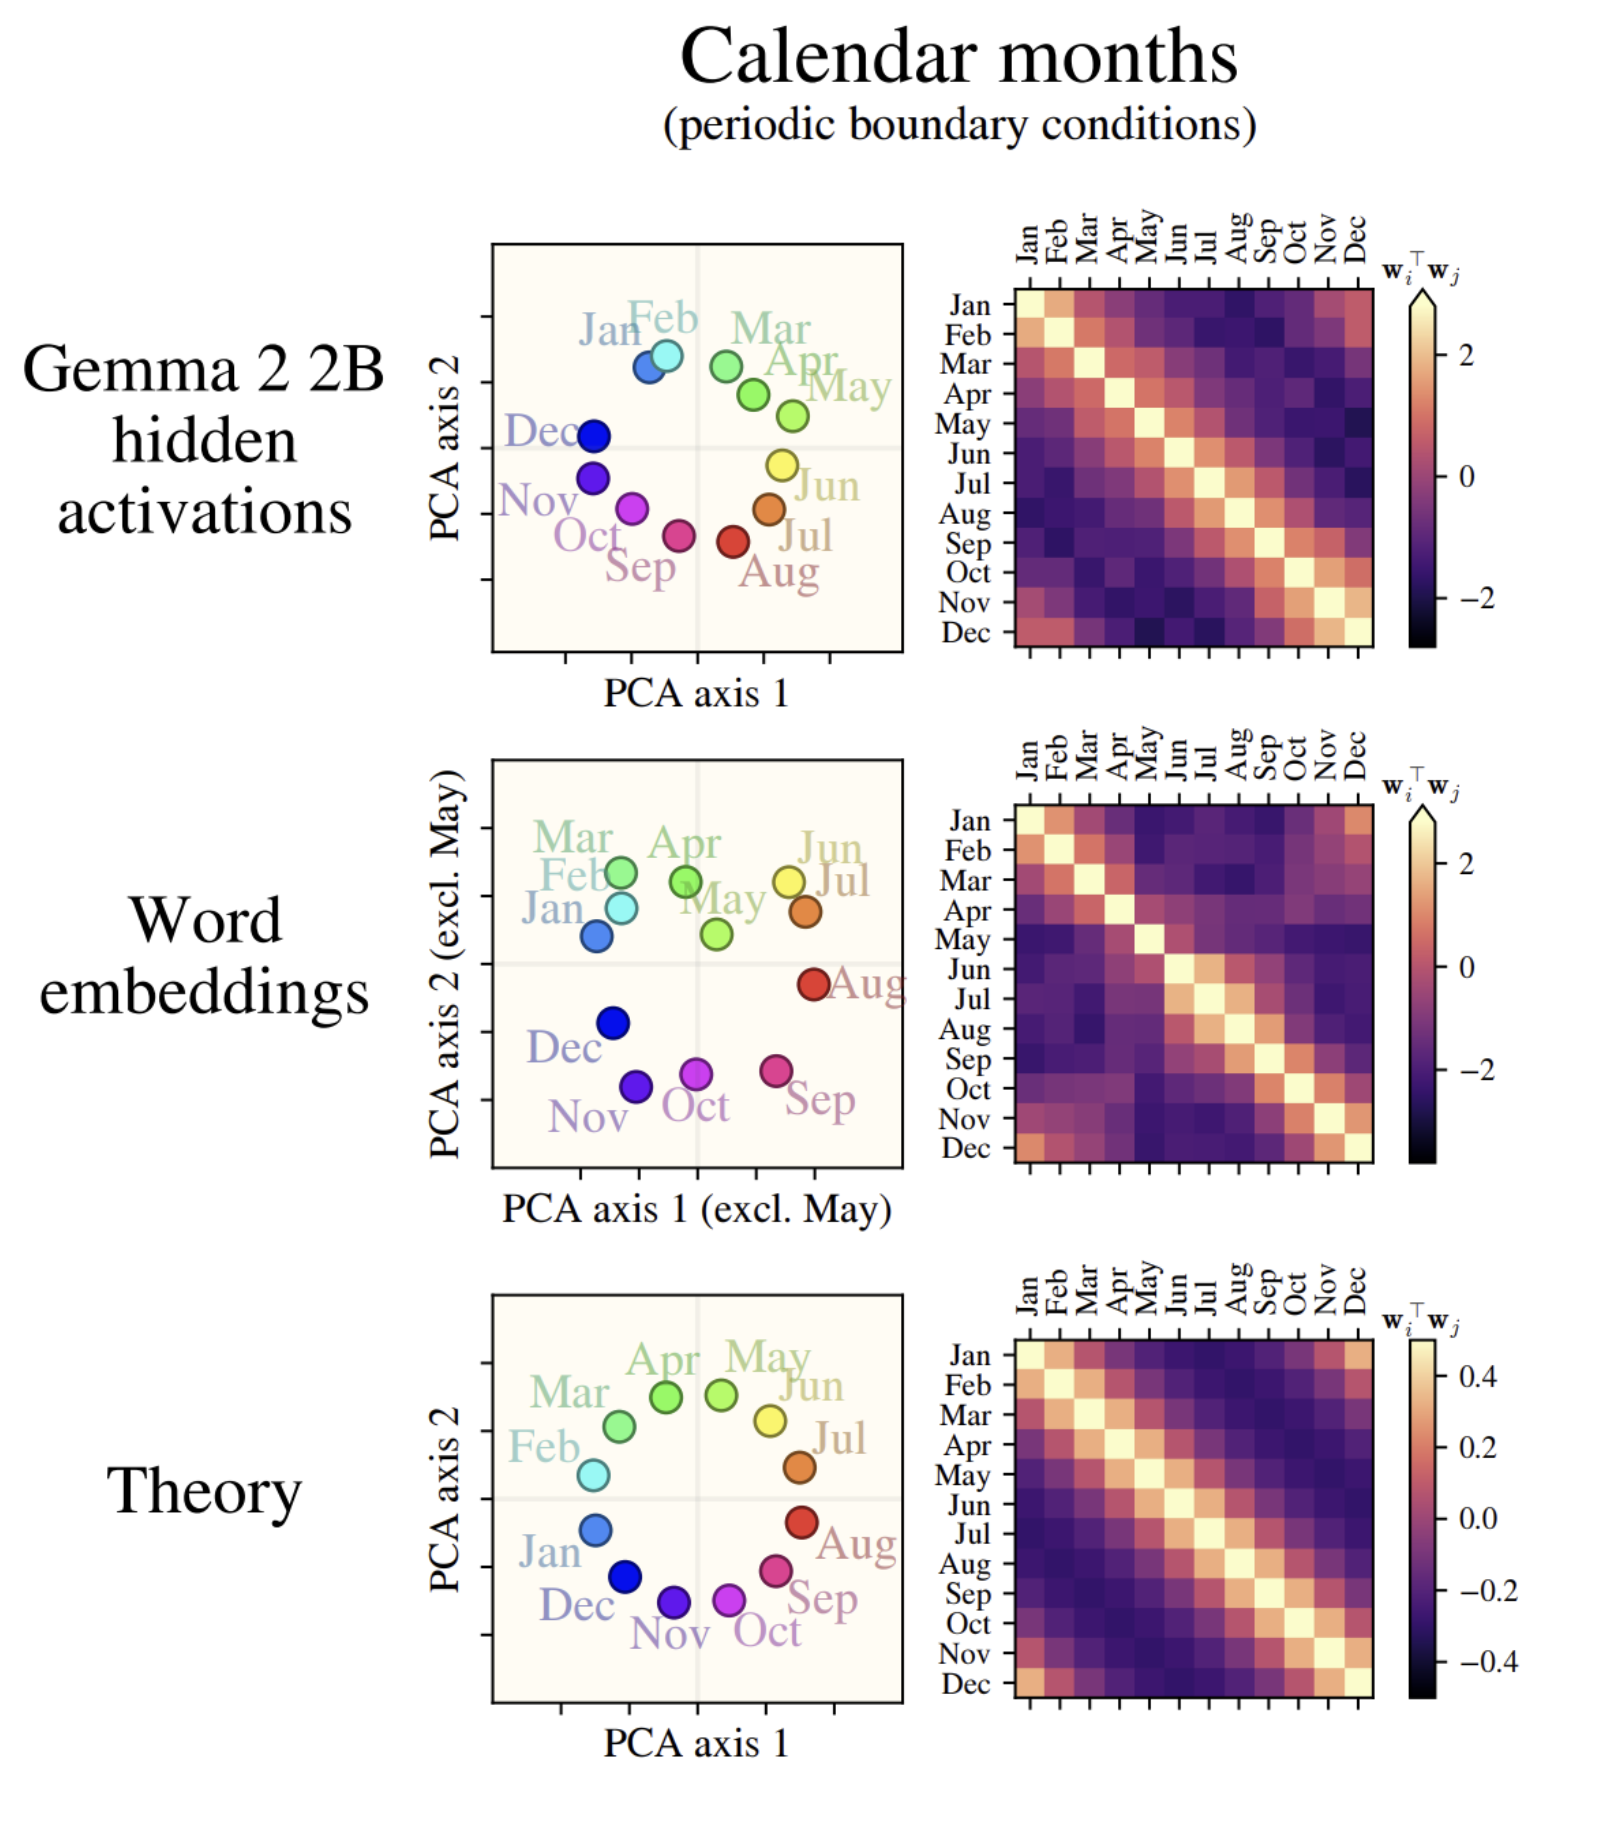
머신러닝 임베딩을 다뤄본 사람이라면 단어 벡터를 저차원으로 투영했을 때 나타나는 기하학적 패턴에 매료된 경험이 있을 것이다. 최근 트위터에서 화제가 된 드루바 카르카다(Dhruva Karkada)의 데이터 통계 논문도 그런 사례다. 논문은 어휘 집합에서 각 단어를 d차원 벡터로 사상하는 모델을 다루면서, 1월부터 12월까지 열두 달의 이름에 대응하는 임베딩 벡터 12개를 뽑아 이를 시각화했다. 그 결과 달들이 깔끔한 원(circle)을 그리고, 이들 사이의 관계가 순환 행렬(circulant matrix) 구조를 이룬다는 점을 보여준다. 데이터 통계와 표현 기하학(representational geometry)을 단순한 수학 이론으로 연결했다는 점에서 주목받았고, 저자 본인도 지금까지 본 과학 도표 중 가장 아름다운 축에 든다고 평가했다.
원문 필자는 이 아름다운 결과에 일부러 구멍을 내보고 싶어졌다. 그는 카르카다에게 맥주 한 잔을 걸고, 서로 아무 관련 없어 보이는 단어들을 모아도 똑같이 원과 순환 행렬 형태를 만들어낼 수 있다고 장담했다. 대부분의 사람은 이를 터무니없다고 여겼다. 열두 달이 원을 그리는 이유는 단어들 사이의 특별한 의미적 관계에서 비롯된 것처럼 보였기 때문이다. 내기 조건은 명확했다. 무작위처럼 보이는 단어 열 개를 골라, 그 word2vec 임베딩을 같은 방식으로 그렸을 때 분명하고 설득력 있는 원이 나오게 하는 것이었다.
왜 가능하다고 봤는가
필자의 계산은 조합론에 기대고 있다. 어휘가 2만 5,000개라면, 여기서 단어 열 개를 고르는 경우의 수는 약 3×10^37가지에 이른다. 이렇게 많은 조합을 던지다 보면 그중 최소 한 번은 원 모양이 나올 수밖에 없다는 직관이다. 정보이론의 관점에서 보면 이 선택지는 약 124비트의 정보량에 해당하는데, 그 정도 해상도면 그럴듯한 10점짜리 원 하나를 만들어내기에 충분하다는 것이다. 문제는 존재 여부가 아니라, 이 방대한 건초더미에서 '좋은' 단어 열 개를 어떻게 찾아내느냐였다. 결국 그는 코딩 에이전트를 활용해 하루 오후 만에 원을 이루는 무작위풍 단어 조합을 찾아냈고, 내기에서 이겼다. 흥미로운 대목은 임베딩 차원 d가 1만이나 되는데도 이 값이 탐색 과정에 전혀 관여하지 않았다는 점이다.
실무자가 새겨야 할 교훈
이 결과의 핵심은 단순한 장난이 아니다. 저차원 PCA 투영에서 특정 기하 구조를 '추적 매칭(pursuit-matching)'하듯 뒤지다 보면, 그것이 데이터의 본질적 구조가 아니라 순전히 우연의 산물일 수 있다는 경고다. 조합 공간이 충분히 크면, 아무 의미 없는 단어들도 그럴듯한 원이나 대칭 패턴을 만들어낸다. 다시 말해 관측된 기하 패턴이 통계적으로 유의미하려면, 그 패턴이 우연히 나타날 수 없을 만큼 충분한 제약 조건이 목표에 걸려 있어야 한다. 제약이 없다면 원을 발견했다는 사실 자체는 아무것도 증명하지 못한다.
이는 임베딩이나 잠재 표현을 분석하는 모든 실무자가 마주하는 '다중 검정' 문제와 본질적으로 같다. 후보 조합이 폭발적으로 많은 상황에서 '보기 좋은' 구조를 사후에 골라내면, 통계적으로는 거의 무엇이든 찾을 수 있다. 시각화가 설득력 있게 보인다는 점이 오히려 위험 요소가 된다. 사람의 눈은 원이나 대칭에 강하게 반응하기 때문에, 우연한 패턴을 의미 있는 발견으로 착각하기 쉽다.
필자는 몇 가지 단서도 함께 달았다. 이 실험이 카르카다의 원래 결과를 반증하는 것은 아니다. 열두 달의 원은 데이터 통계와 표현 기하를 잇는 이론적 근거가 뒷받침하는 반면, 필자가 만든 원은 방대한 탐색 끝에 우연히 건진 사례이기 때문이다. 두 상황을 가르는 것은 결과물의 겉모습이 아니라, 그 배후에 검증 가능한 통계적 제약이 존재하느냐다.
그럼에도 이 사례는 확장 가능한 해석 가능성(scalable interpretability) 같은 연구 방향에 실질적 시사점을 준다. 표현 공간에서 특정 기하 구조를 자동으로 탐색해 특징(feature)을 발견하려는 알고리즘은, 충분한 통계적 제약을 걸지 않는 한 우연한 패턴에 속을 수밖에 없다는 점이 드러났기 때문이다. 대규모 모델의 내부를 자동으로 해부하려는 시도가 늘어나는 지금, '보이는 구조'와 '실재하는 구조'를 구분하는 통계적 규율이 그 어느 때보다 중요하다는 뜻이다.