AI가 쓴 글은 왜 티가 날까요
AI가 쓴 글을 많이 읽다 보면 묘하게 익숙한 말버릇이 보여요. 영어권에서는 ‘delve’, ‘tapestry’ 같은 단어, “It’s not just X, it’s Y” 같은 문장 구조, 문장 중간에 툭툭 끼어드는 em dash(—)가 대표적이에요. 뭐든 꼭 세 개씩 묶어 나열하는 습관도 있고요. 한국어도 다르지 않아요. “~에 대해 알아보겠습니다”, “결론적으로”, “다양한”, “단순한 ~가 아닌 ~입니다”, 그리고 모든 문단을 글머리 기호와 굵은 글씨로 도배하는 스타일이요.
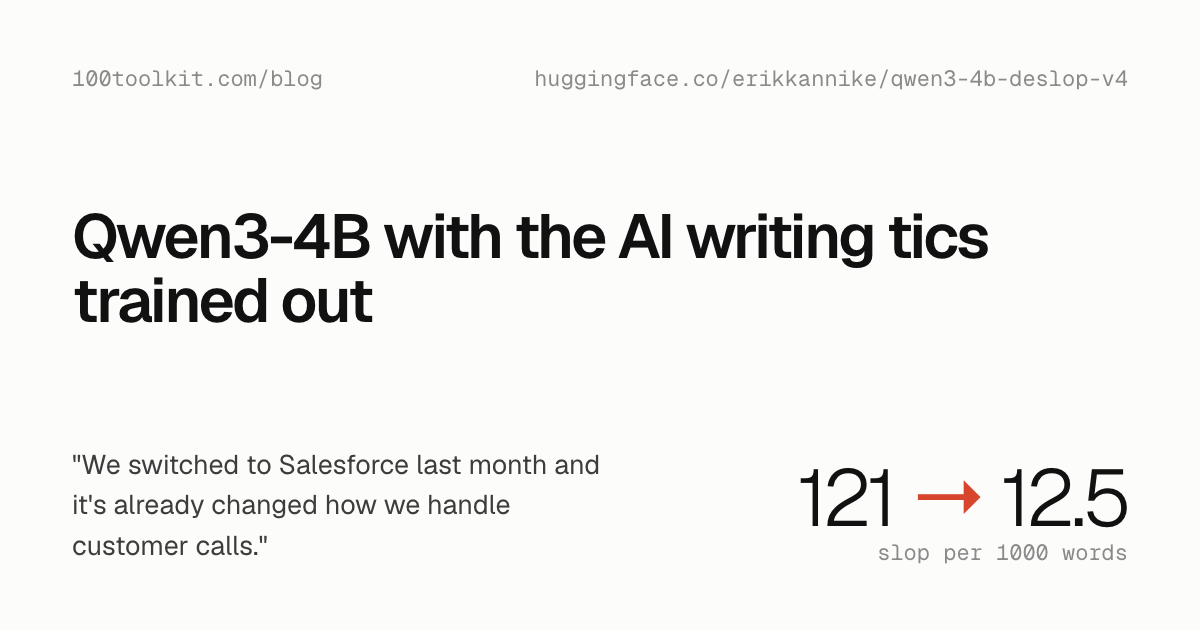
이런 걸 영어권에서는 슬롭(slop)이라고 불러요. 원래 질척한 음식 찌꺼기를 뜻하는 말인데, 영혼 없이 대량으로 찍어낸 AI 콘텐츠를 부르는 말이 됐어요. 이번에 공개된 프로젝트는 알리바바의 소형 오픈 모델 Qwen3-4B에서 바로 이 말버릇을 학습으로 빼낸 모델이에요. 파라미터가 40억 개라 양자화(모델 숫자 정밀도를 낮춰 용량을 줄이는 기법)하면 노트북에서도 돌릴 수 있는 크기예요.
말버릇은 어디서 생길까
LLM은 사전학습 뒤에 사람 피드백 기반 강화학습(RLHF) 같은 선호 학습을 거쳐요. 사람 평가자나 보상 모델이 ‘좋은 답’이라고 점수를 준 스타일을 더 자주 쓰도록 다듬는 과정이에요. 문제는 이 과정에서 모델이 점수를 잘 받는 몇 가지 표현으로 몰려버린다는 거예요. 정중하고 구조적이고 있어 보이는 표현이 계속 강화되다 보니, 결국 다들 비슷한 말투가 되는 거죠.
요즘은 AI가 만든 합성 데이터로 다른 모델을 학습시키는 일도 많아서, 한 모델의 말버릇이 다음 세대 모델로 대물림되기도 해요. 부모 말투를 아이가 따라 하는 것과 비슷해요.
말버릇을 빼는 세 가지 방법
1. 프롬프트로 금지하기
가장 쉬운 방법은 시스템 프롬프트에 “delve 쓰지 마”라고 적는 거예요. 그런데 생각보다 잘 안 먹혀요. 금지한 단어 대신 비슷한 표현으로 갈아타거나, 오히려 그 단어를 의식해서 더 쓰기도 하거든요. ‘코끼리를 생각하지 마’라고 하면 코끼리가 떠오르는 것과 비슷해요.
2. 생성 단계에서 막기
모델이 다음 토큰을 고를 때 특정 토큰의 확률을 강제로 낮추는 방법이에요. 더 나아간 방식으로 Antislop 샘플러가 있는데요, 금지된 문구가 만들어지는 순간 몇 토큰 뒤로 되감고 다른 길로 다시 생성해요. 효과는 좋지만 되감기 때문에 생성이 느려지고, 모델 자체는 그대로라는 한계가 있어요.
3. 학습으로 빼기
이번 프로젝트처럼 모델 가중치 자체를 바꾸는 방법이에요. 보통은 같은 질문에 대해 ‘말버릇 가득한 답’과 ‘깔끔한 답’을 쌍으로 만들고, DPO(직접 선호 최적화) 같은 선호 학습으로 어느 쪽이 나은지 가르쳐요. DPO가 뭐냐면, 별도 보상 모델 없이 좋은 답과 나쁜 답 쌍만 보여주면서 좋은 쪽을 고를 확률을 높이는 학습법이에요. 전체 가중치 대신 LoRA 같은 작은 어댑터만 학습하면 GPU 한 장으로도 해볼 만하고, 한번 학습해두면 추론할 때 추가 비용이 없다는 게 큰 장점이에요.
말버릇만 지우면 좋은 글일까
꼭 그렇진 않아요. 단어 목록으로 잡히는 건 표면이고, 뻔한 전개나 알맹이 없는 일반론 같은 구조적인 문제는 그대로 남을 수 있어요. ‘delve’를 지우면 다른 단어가 그 자리를 차지하는 두더지 잡기가 벌어지기도 하고요. 스타일 학습이 지시 따르기나 추론 같은 다른 능력을 떨어뜨릴 수도 있으니, 이런 모델을 쓸 땐 원본과 비교한 평가 결과를 꼭 확인하세요.
윤리 문제도 있어요. AI 탐지를 피하는 ‘휴머나이저’로 쓰일 수 있거든요. 다만 말투 기반 AI 탐지기는 원래도 정확도가 낮고, 영어가 모국어가 아닌 사람의 글을 AI가 쓴 걸로 잘못 판정하는 경향이 있다는 연구도 있어요. 말투로 AI를 가려내는 방식 자체가 오래가기 어렵다는 뜻이기도 해요.
한국 개발자에게는
LLM으로 고객 응대 메시지, 상품 설명, 사내 문서를 만드는 서비스라면 “너무 AI 같다”는 피드백을 한 번쯤 받아봤을 거예요. 그럴 땐 프롬프트를 계속 고치기 전에, 우리 서비스에서 자주 나오는 말버릇 목록부터 만들어보세요. 생성 결과에서 그 표현이 몇 번 나오는지 정규식으로 세기만 해도 꽤 쓸 만한 평가 지표가 돼요.
다음 단계로는 소형 모델에 LoRA와 DPO를 직접 적용해볼 수 있어요. Hugging Face TRL이나 Unsloth 같은 라이브러리를 쓰면 진입 장벽이 많이 낮아요. 한국어 품질이 중요하다면 Qwen3 외에 EXAONE, HyperCLOVA X SEED 같은 국산 오픈 모델도 후보인데, 모델마다 라이선스 조건이 달라서 상업적으로 써도 되는지는 꼭 확인하세요.
마무리
AI 말투는 단어 문제라기보다 학습이 남긴 습관이고, 습관은 다시 학습으로 고칠 수 있어요.
여러분은 어떤 한국어 표현을 보면 ‘이거 AI가 썼네’ 하고 바로 알아채나요? 그리고 AI 말투를 지우는 기술, 반가운 쪽인가요, 걱정되는 쪽인가요?
🔗 출처: Hacker News