왜 빨래 개는 로봇은 아직 없을까요
ChatGPT가 나온 뒤로 이런 질문을 하는 사람이 많아졌어요. “글도 쓰고 코드도 짜는 AI가 나왔는데, 왜 빨래 개는 로봇은 아직 없지?” 건설·제조 기술을 깊게 다루는 뉴스레터 Construction Physics가 'How to Train Your Robot'이라는 글에서 바로 이 주제를 다뤘어요. 로봇을 어떻게 훈련시키느냐는 거죠. 휴머노이드 스타트업에 큰돈이 몰리고 '피지컬 AI'가 유행어가 된 지금, 로봇 학습의 큰 그림을 한 번 정리해 둘 만해요.
먼저 모라벡의 역설부터 알아둘게요. 이게 뭐냐면, 사람에게 어려운 일(체스, 수학)은 컴퓨터에게 쉽고, 사람에게 쉬운 일(컵 집기, 걷기)은 오히려 컴퓨터에게 엄청 어렵다는 관찰이에요. 우리가 무심코 하는 동작에는 수억 년 동안 진화로 쌓인 감각과 제어 능력이 녹아 있거든요.
1단계: 좌표를 하나하나 찍어주던 시절
자동차 공장의 용접 로봇을 떠올려 보세요. 엔지니어가 '티칭 펜던트'라는 리모컨으로 로봇 팔을 움직여 위치를 하나씩 저장하면, 로봇은 그 경로를 수만 번 똑같이 반복해요. 빠르고 정확하지만, 부품이 1cm만 어긋나 있어도 허공에 용접을 하죠. 그래서 산업용 로봇은 고정 장치와 안전 펜스로 환경을 완벽히 통제한 곳에서만 일해 왔어요. 로봇이 환경에 적응한 게 아니라 환경을 로봇에 맞춘 거예요.
2단계: 시행착오로 배우는 강화학습
그다음 나온 게 강화학습(RL)이에요. 강아지 훈련처럼 잘하면 보상을 주고 못하면 점수를 깎아서, 로봇이 수백만 번 시도하며 스스로 요령을 익히게 하는 방식이죠. 문제는 실제 로봇이 수백만 번 넘어지면 기계가 먼저 망가진다는 거예요. 그래서 가상 세계(시뮬레이터)에서 먼저 학습시킨 뒤 실제 로봇으로 옮기는 Sim-to-Real이 표준이 됐어요.
이 방식은 '걷기'에서 크게 성공했어요. 요즘 4족 보행 로봇이나 휴머노이드가 계단을 오르고 발로 차여도 버티는 건 대부분 시뮬레이션 강화학습 덕분이에요. 그런데 손으로 물건을 다루는 건 얘기가 달라요. 천이 구겨지는 모양이나 물체끼리 미끄러지는 마찰 같은 접촉 물리는 시뮬레이터가 정확히 흉내 내기 어렵거든요. 그래서 이 영역에서는 가상과 현실의 차이, 이른바 Sim-to-Real Gap이 크게 벌어져요.
3단계: 사람이 시범을 보여주는 모방 학습
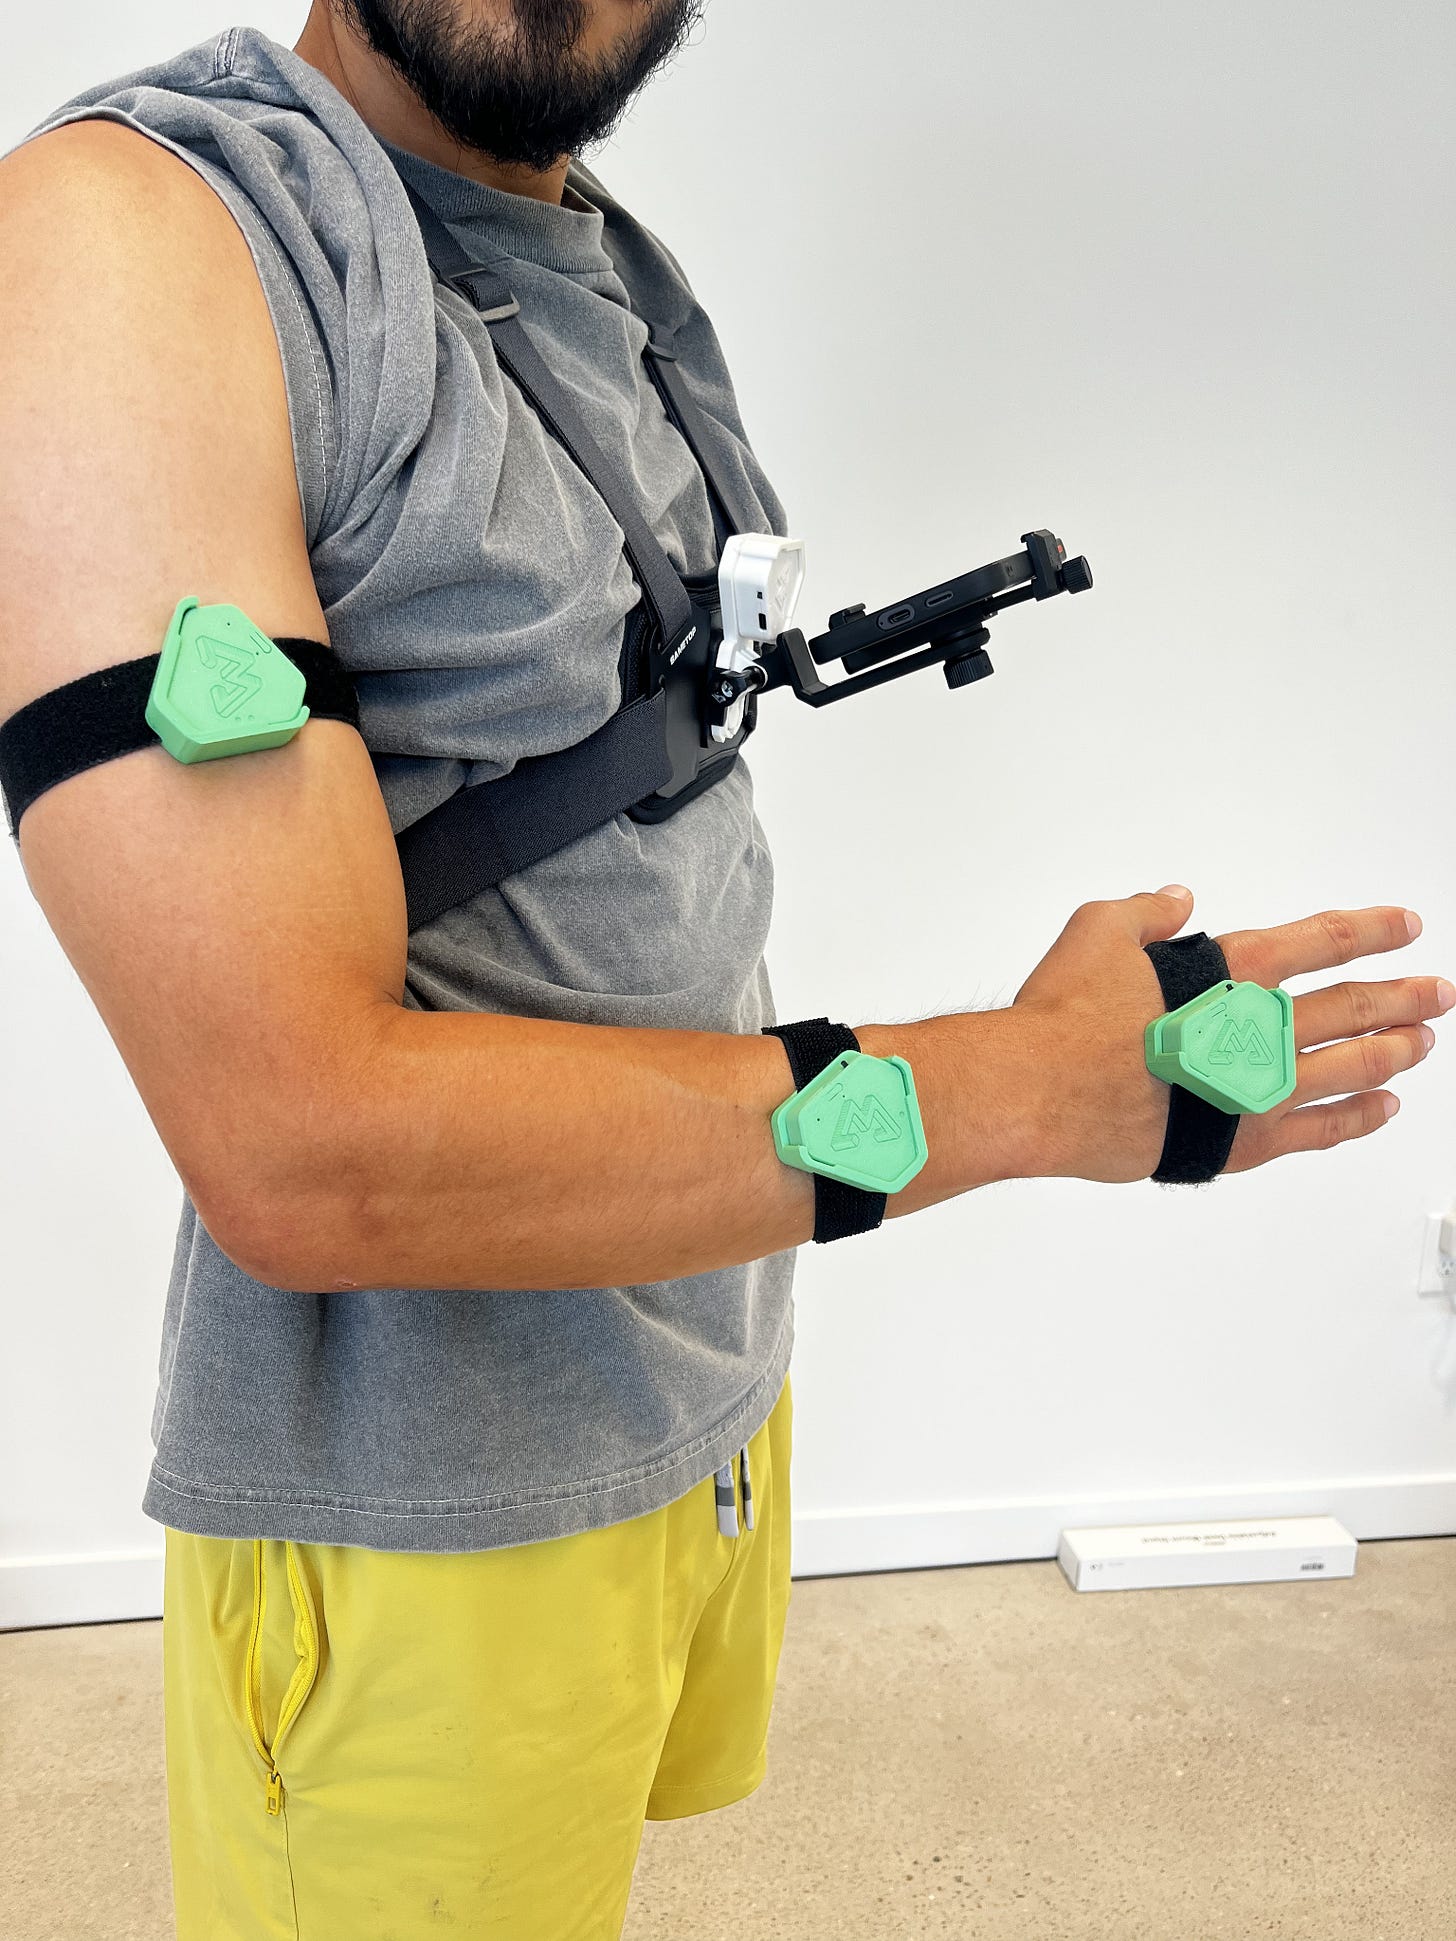
그래서 요즘 대세는 모방 학습이에요. 사람이 조종용 팔이나 VR 장비로 로봇을 원격 조종(텔레오퍼레이션)하면서 시범을 보이고, 그때의 카메라 영상과 관절 움직임을 기록해서 신경망이 따라 하게 만드는 방식이에요. 스탠퍼드의 저가형 양팔 로봇 ALOHA와 후속작 Mobile ALOHA가 과제당 50번 남짓 시범만 보고 새우 볶기 같은 작업을 해내면서 이 흐름이 크게 퍼졌어요.
4단계: 로봇에게도 파운데이션 모델을
LLM이 인터넷 텍스트로 상식을 배운 것처럼 로봇에게도 범용 두뇌를 만들어 주자는 시도가 있는데, 그게 VLA(Vision-Language-Action) 모델이에요. 이미지와 언어를 이해하는 거대 모델에 '행동' 출력을 붙여서, “빨간 컵을 싱크대에 넣어줘” 같은 말을 바로 모터 명령으로 바꾸는 구조예요. 구글 딥마인드의 RT-2와 Gemini Robotics, Physical Intelligence의 π0, 엔비디아의 GR00T, Figure의 Helix가 다 이 계열이에요.
진짜 병목은 결국 데이터
여기서 핵심 문제가 보여요. LLM을 학습시킬 때는 인터넷에 이미 수조 개의 토큰이 쌓여 있었지만, 로봇 행동 데이터는 누군가 로봇을 직접 움직이면서 한 건씩 모아야 해요. 여러 연구기관이 함께 만든 Open X-Embodiment 데이터셋이 22종 로봇에서 약 100만 건의 에피소드를 모았는데, 텍스트 데이터에 비하면 아직 한참 작은 규모예요.
그래서 업계는 우회로를 찾고 있어요. 사람이 머리에 카메라를 달고 찍은 1인칭 영상으로 학습하기도 하고, 로봇 없이 그리퍼 모양 도구만 들고 다니며 데이터를 모으는 UMI 같은 장비를 쓰기도 하고, 엔비디아 Isaac Sim 같은 시뮬레이터로 합성 데이터를 대량으로 만들기도 해요. 자율주행이 그랬듯이 로봇도 먼저 현장에 배치해서 운영 데이터를 계속 빨아들이는 쪽, 그러니까 데이터 플라이휠을 먼저 돌리는 쪽이 유리해질 가능성이 커요.
한국 개발자에게 주는 시사점
한국은 제조업 노동자 1만 명당 로봇 대수가 세계 최고 수준인 나라예요. 현대차그룹의 보스턴 다이나믹스, 삼성전자가 최대주주가 된 레인보우로보틱스, 두산로보틱스까지 플레이어도 많고요. 그런데 이 산업의 무게중심이 '하드웨어 제어'에서 '데이터와 모델'로 옮겨가고 있어요. 소프트웨어 개발자에게 들어갈 문이 넓어지고 있다는 뜻이죠.
진입 장벽도 많이 낮아졌어요. 허깅페이스의 오픈소스 라이브러리 LeRobot을 쓰면 수십만 원대 부품으로 조립하는 SO-100 로봇 팔로 데이터 수집부터 모방 학습까지 직접 해볼 수 있어요. 물리 시뮬레이터 MuJoCo도 오픈소스로 공개돼 있고요. 데이터 파이프라인 구축, 대용량 영상 데이터 관리, 지연 시간이 짧은 모델 추론은 웹·백엔드 개발자가 이미 가진 역량이기도 해요.
마무리
한 줄 정리: 로봇 학습의 승부처가 알고리즘에서 ‘누가 좋은 데이터를 더 싸게 모으느냐’로 옮겨가고 있어요.
집에서 로봇이 빨래를 개는 날이 몇 년 안에 올 거라고 보시나요? 아니면 자율주행처럼 늘 ‘5년 뒤’에 머물까요? 로봇 분야에 관심 있는 분들은 어디서부터 시작하고 계신지도 궁금해요.
🔗 출처: Hacker News