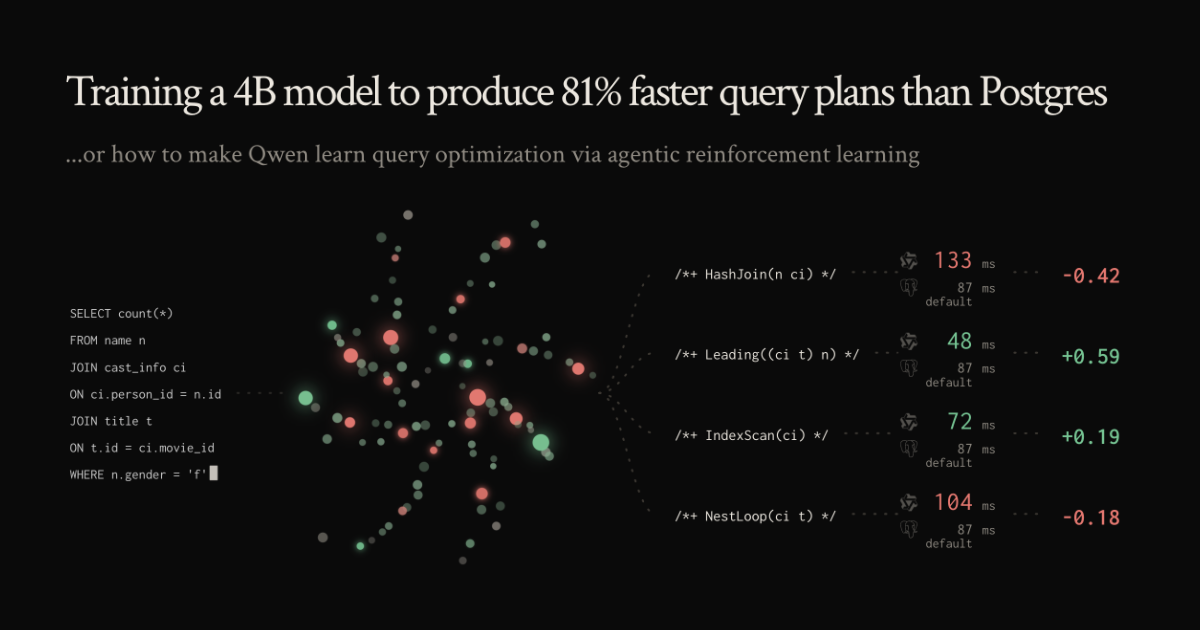
데이터베이스 성능을 다뤄본 사람이라면 "옵티마이저가 알아서 최적 플랜을 골라주지 않나?"라는 기대와, 실제로는 그렇지 않아 애를 먹은 경험을 동시에 갖고 있을 것이다. Leis 등의 연구진은 2015년에 쿼리 옵티마이저가 얼마나 잘 동작하는지를 정면으로 물었고, 10년 뒤 같은 질문을 다시 던졌다. 그 사이 방대한 연구가 쌓였음에도 결론은 크게 달라지지 않았다. 옵티마이저는 여전히 기대에 못 미친다는 것이다. 최근 한 개발자가 공개한 실험은 이 오래된 난제에 언어 모델을 붙여보는 시도로, 40억 파라미터급 오픈웨이트 모델(Qwen)을 후처리 학습시켜 Postgres 기본 플랜보다 최대 81% 빠른 실행 계획을 만들어냈다고 주장한다.
왜 옵티마이저는 여전히 어려운가
쿼리 최적화가 어려운 핵심 이유 중 하나는 조인 순서 결정(join ordering)이 NP-hard 문제라는 데 있다. 테이블이 늘어날수록 가능한 실행 방식은 조합적으로 폭발한다. 원문은 IMDb 데이터의 세 테이블 조인을 예로 든다. 조인 트리의 형태, 각 조인의 외부·내부 입력 방향, 해시·머지·중첩 루프 같은 조인 알고리즘, 그리고 순차·인덱스·비트맵 등 스캔 방식을 모두 곱하면 세 테이블만으로도 4,608가지 실행 방법이 나온다. 테이블이 6개면 약 17억 가지, 12개면 사실상 셀 수 없는 규모가 된다. Postgres는 이 공간 전부를 평가하지 않는다. 동적 프로그래밍으로 가지치기하고, 조인이 12개 이상이면 유전 알고리즘으로 근사한다.
문제는 어떤 플랜이 좋은지가 선택적 조건(WHERE절의 필터)에 크게 좌우된다는 점이다. 원문의 예에서 "2000년대에 가장 많은 작품을 낸 일본 회사"를 찾는 쿼리는, 먼저 일본 회사(전체의 5%)로 거른 뒤 2000년대 작품과 조인하면 약 10만 행을 다음 조인으로 넘긴다. 반대 순서로 하면 40만 행이 넘어가 네 배의 일을 하게 된다. 어느 쪽을 고르느냐에 따라 실행 비용이 크게 갈리는 것이다.
통계에 기댄 추정, 그리고 그 한계
그렇다면 Postgres가 각 조인의 결과 행 수를 세어 가장 적은 쪽을 고르면 되지 않을까. 그럴 수 없다. 행 수(카디널리티)를 정확히 알려면 실제로 조인을 실행해봐야 하는데, 이는 빠른 옵티마이저라는 목적 자체를 무너뜨린다. 대신 Postgres는 pg_statistic 테이블의 통계, 즉 각 컬럼의 대표값과 빈도, 나머지에 대한 히스토그램으로 카디널리티를 추정한다. 조인이 얽히면 한 테이블의 값 분포가 다른 테이블에 어떻게 퍼지는지 알 수 없으므로, 한쪽 빈도를 다른 쪽에 그대로 적용하는 균등 분포 가정을 쓴다.
이 가정은 대체로 무난한 휴리스틱이지만, 어긋날 때는 크게 어긋난다. 앞의 예에서 일본 회사가 전체의 5%라도 이들이 실제 영화의 50%를 차지한다면, 첫 조인은 예상한 10만이 아니라 100만 행을 쏟아낸다. 비용 모델은 첫 순서를 고르라고 하지만 실제로는 두 번째 순서가 낫다. 이렇게 초반 조인에서 한 번 빗나간 추정은 이후 트리 전체로 전파되며 다른 추정값까지 오염시킨다.
힌트로 옵티마이저를 밀어붙이기
Postgres는 언제나 비용이 가장 낮은 플랜을 고르고, 소스를 고치지 않는 한 그 비용 모델을 바꿀 수 없다. 여기서 등장하는 것이 pg_hint_plan 확장이다. SQL 문 위에 구조화된 주석 형태의 "힌트"를 붙이면, 특정 조인 알고리즘이나 스캔 방식을 강제하도록 Postgres를 유도할 수 있다. 원문 예시처럼 두 테이블을 해시 조인으로 붙이고 특정 테이블을 순차 스캔하라고 지시하면 플랜이 그대로 따라온다. 즉 비용이 더 높게 계산되는 플랜이라도 외부에서 선택을 밀어붙일 통로가 열려 있는 셈이다.
실험의 출발 질문은 여기서 나온다. 언어 모델이 더 나은 플랜으로 이어지는 힌트를 스스로 만들어내도록 학습할 수 있는가. 이 접근이 매력적인 이유는 결과 검증이 쉽다는 데 있다. 좋은 옵티마이저는 빠른 플랜을, 나쁜 옵티마이저는 느린 플랜을 낸다. 최적화 축이 실행 시간 하나로 환원되므로, 모델이 더 빠른 플랜을 내도록 행동을 강화하는 강화학습 설정과 잘 맞아떨어진다. 검증 가능한 출력을 가진 과제에서 언어 모델이 특히 강하다는 점을 정확히 겨냥한 것이다.
한 가지 눈여겨볼 대목은 저자가 처음 떠올린 아이디어를 스스로 접었다는 점이다. 모델에 Postgres 플래너와 똑같은 정보를 주고 더 나은 카디널리티 추정기를 만드는 방향인데, 저자는 이를 가치 없는 길로 판단했다. 수십 년간 축적된 카디널리티 추정 연구와 정면으로 싸워야 하는 데다, 모델 추론에 드는 지연 시간만으로도 Postgres의 초고속 옵티마이저 대비 얻는 이득을 상쇄해버린다는 이유에서다. 대신 힌트 생성이라는 우회로를 택한 것이다.
실무자 입장에서 이 실험은 두 가지를 시사한다. 하나는 옵티마이저가 만능이 아니라는 오래된 사실을, 통계 추정의 균등 분포 가정이 깨지는 지점에서 다시 확인시켜준다는 점이다. 데이터가 편향돼 있는 테이블에서 조인 순서가 어긋나는 병목을 겪었다면 원인은 대개 여기에 있다. 다른 하나는 pg_hint_plan 같은 기존 도구로 사람이 개입할 여지가 이미 존재하며, 그 개입을 모델에 위임하려는 시도가 시작되고 있다는 점이다. 다만 이 실험은 IMDb라는 특정 데이터셋과 오픈웨이트 소형 모델을 대상으로 한 단일 사례이고, 추론 지연이라는 근본적 제약도 남아 있다. 81%라는 수치가 곧바로 프로덕션 이득으로 옮겨간다고 보기는 이르며, 어떤 쿼리 분포와 조건에서 성립하는 개선인지를 함께 따져봐야 한다.