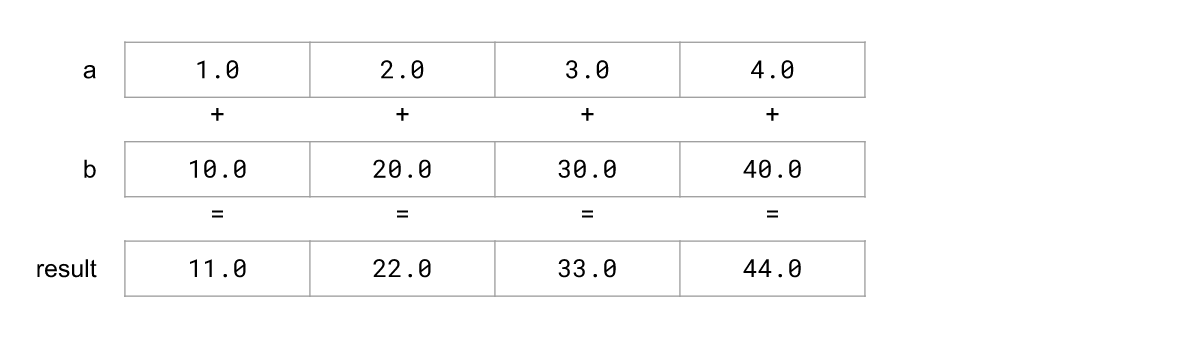
구글이 2022년 오픈소스로 공개한 정렬 코드가 숫자 배열을 C++ 표준 라이브러리의 std::sort보다 약 10배 빠르게 정렬한다고 밝혔다. '벡터화되고 성능 이식성을 갖춘 퀵소트(Vectorized and performance-portable Quicksort)'라는 이름이 붙은 이 작업물은, 수십 년간 다듬어져 온 표준 정렬 함수를 한 자릿수 배수가 아니라 열 배 수준으로 앞선다고 주장한다는 점에서 눈길을 끈다. 공개된 설명 자체는 짧지만, 그 배경에 있는 기술적 흐름과 실무적 함의는 한 번 짚어볼 만하다.
std::sort가 기준선인 이유
std::sort는 C++ 개발자가 가장 흔히 쓰는 정렬 도구다. 대부분의 표준 라이브러리 구현은 퀵소트와 힙소트, 삽입 정렬을 상황에 따라 조합한 인트로소트(introsort) 계열을 사용하며, 오랜 기간 검증되어 안정적이고 예측 가능한 성능을 낸다. 그래서 새로운 정렬 알고리즘이나 구현이 등장할 때 std::sort는 사실상 넘어야 할 기준선 역할을 한다. 바로 이 기준선을 열 배 차이로 넘어섰다는 것이 이번 공개의 핵심 주장이다.
표준 정렬이 빠르긴 하지만, 그 구현의 상당 부분은 한 번에 값 하나를 비교하고 교환하는 스칼라 연산에 기반한다. 원소를 비교하고 분기하고 자리를 바꾸는 과정이 반복되는데, 현대 CPU가 가진 병렬 처리 능력의 일부만 활용하는 구조인 셈이다. 이 지점이 개선의 여지로 지목된다.
벡터화와 성능 이식성이라는 두 축
제목에 담긴 첫 번째 열쇠는 '벡터화'다. 현대 CPU는 SIMD(Single Instruction, Multiple Data) 명령을 통해 여러 데이터를 하나의 명령으로 동시에 처리할 수 있다. 정렬처럼 비교와 분기가 촘촘하게 얽힌 작업은 원래 SIMD와 궁합이 좋지 않은 대표적 사례로 여겨져 왔다. 데이터에 따라 실행 경로가 갈라지는 분기가 많으면 여러 값을 한꺼번에 흘려보내는 벡터 연산의 이점을 살리기 어렵기 때문이다. 정렬을 제대로 벡터화하는 일이 까다로운 과제로 남아 있던 이유가 여기에 있고, 그 벽을 겨냥했다는 점에서 의미가 있다.
두 번째 열쇠는 '성능 이식성(performance portability)'이다. 벡터 명령어 집합은 x86 계열과 ARM 계열이 서로 다르고, 같은 계열 안에서도 세대에 따라 폭과 기능이 제각각이다. 특정 CPU에 손으로 최적화한 코드는 그 칩에서는 빠르지만 다른 아키텍처로 옮기면 이점이 사라지거나 아예 동작하지 않기 일쑤다. 성능 이식성을 내세웠다는 것은, 하나의 코드베이스로 서로 다른 하드웨어에서 고르게 빠른 속도를 내는 것을 목표로 삼았다는 뜻으로 읽힌다. 이는 단발성 벤치마크 기록보다 실무 적용 관점에서 더 중요한 특성이다.
실무자가 눈여겨볼 지점
정렬은 눈에 잘 띄지 않지만 데이터베이스 인덱싱, 쿼리 처리, 분석 파이프라인, 로그 처리 등 거의 모든 데이터 집약적 시스템의 밑바닥에서 반복 호출되는 연산이다. 대규모 배열을 다루는 워크로드에서 정렬 단계가 병목이라면, 이 부분을 열 배 수준으로 줄이는 것은 전체 처리 시간과 비용에 직접적인 영향을 준다. 오픈소스로 공개되었다는 점도 중요하다. 라이선스가 허용하는 범위에서 자체 시스템에 도입하거나, 최소한 벤치마크 기준으로 비교 검증에 활용할 수 있기 때문이다.
다만 '열 배'라는 수치는 그대로 받아들이기보다 조건을 따져봐야 한다. 이번 성과는 숫자 배열 정렬을 대상으로 한 것이다. 문자열이나 사용자 정의 비교 함수를 쓰는 복합 객체 정렬처럼 std::sort가 실제로 감당하는 폭넓은 범용성과는 적용 범위가 다르다. 또한 배속은 데이터 타입, 배열 크기, 실행 CPU의 벡터 폭에 따라 크게 달라지므로, 도입 전 자신의 실제 워크로드로 측정하는 과정이 반드시 필요하다.
공개된 요약이 짧은 만큼 세부 알고리즘과 벤치마크 조건은 원문 저장소에서 직접 확인하는 편이 안전하다. 그럼에도 이 작업이 던지는 메시지는 분명하다. 오랫동안 최적화가 끝났다고 여겨진 기초 연산에도 SIMD를 제대로 활용하면 상당한 여지가 남아 있으며, 그 이점을 특정 칩에 묶어두지 않고 여러 아키텍처로 가져가는 설계가 점점 더 중요해지고 있다는 점이다.