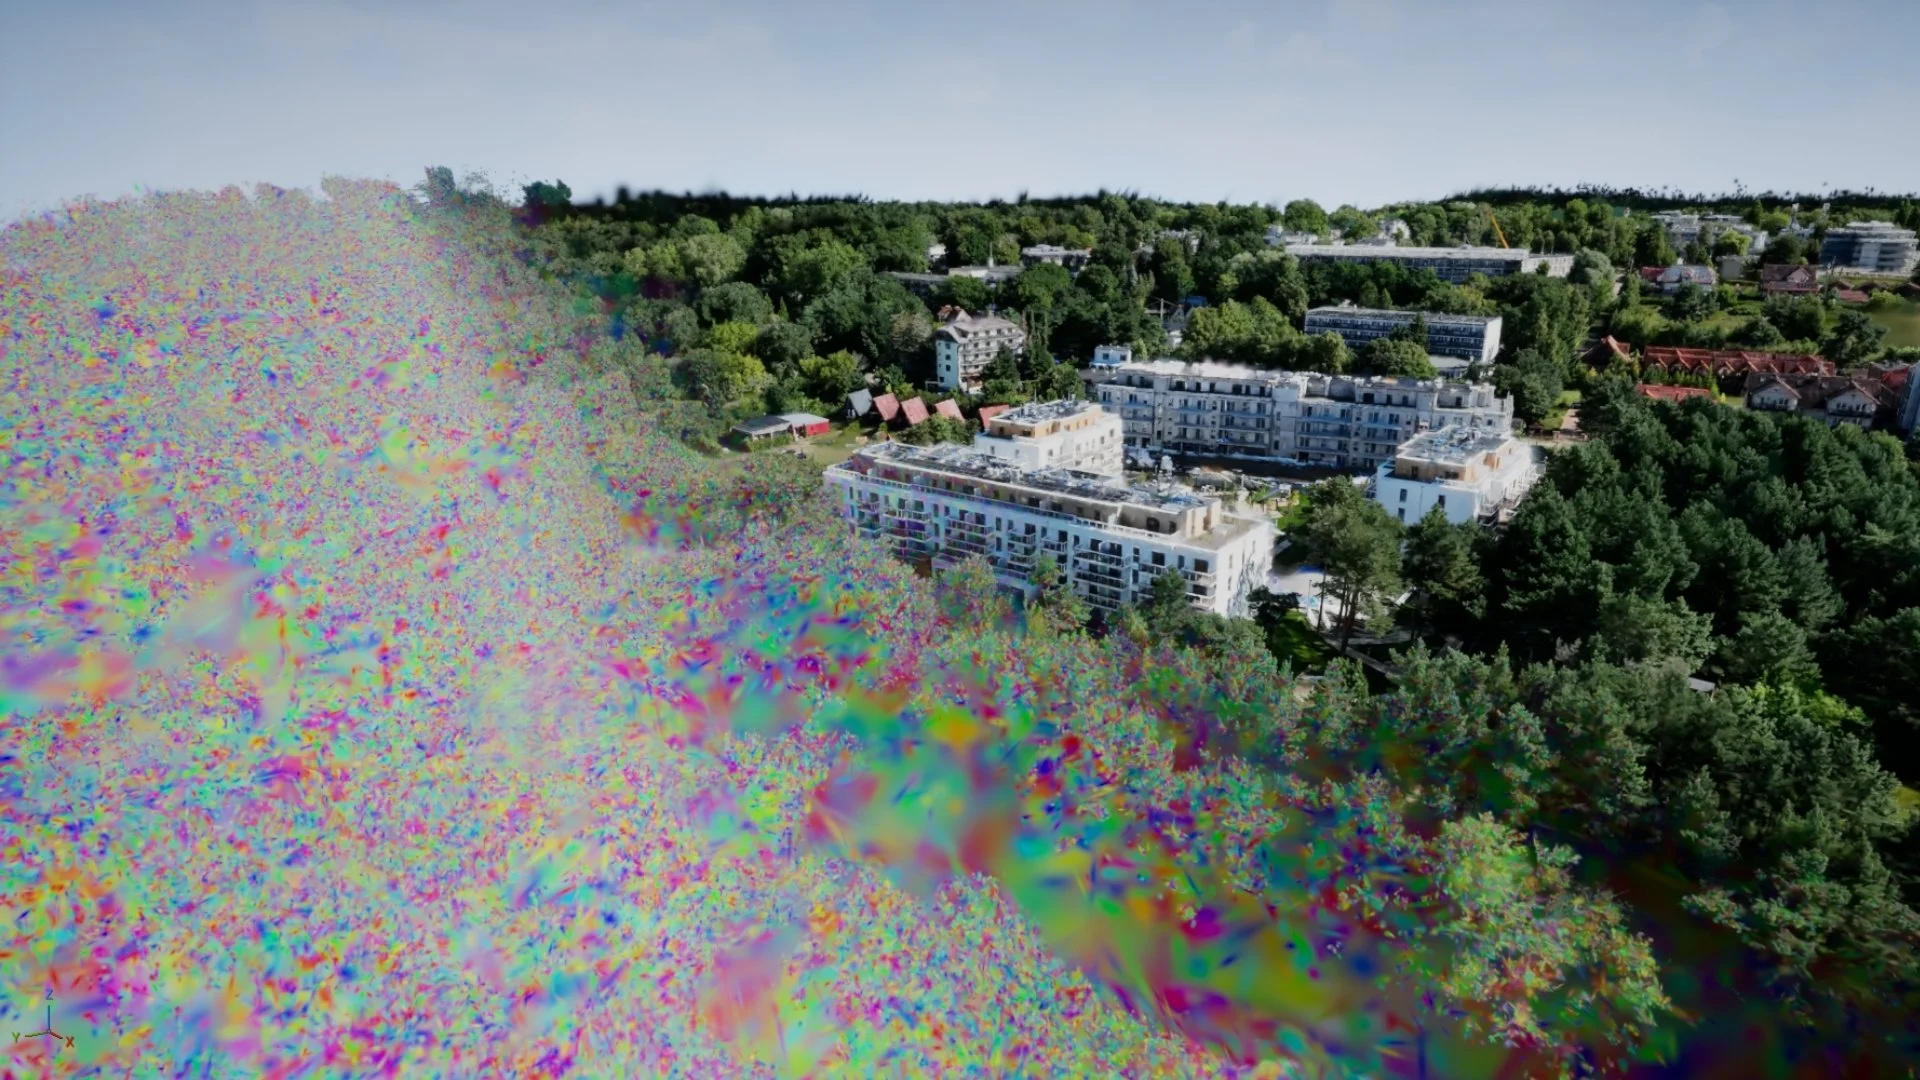
포토그래메트리로 현실 공간을 통째로 포착하는 가우시안 스플래팅은 2025년 그래픽스 업계가 가장 뜨겁게 받아들인 기술 중 하나다. Magnopus의 기술 디렉터 샘 벌리(Sam Birley)는 언리얼 엔진 기반 스플랫 렌더러를 Niagara에서 떼어내 인스턴스 렌더링 위에 다시 세우는 작업을 진행해 왔다. 모든 스플랫을 하나의 인스턴스로 등록하고, 매 프레임 GPU에서 정렬해 투명도 합성 순서를 맞춘 뒤, 머티리얼이 각 스플랫을 부드러운 타원으로 셰이딩하는 구조였다. 잘 동작했고, 그래서 그는 '무제한 스플랫 렌더링'을 자신 있게 선언했다. 그러나 그 선언은 성급했다. 이 글은 그가 이후 연달아 부딪힌 세 개의 벽과, 그것을 넘으면서 렌더러가 오히려 더 나은 형태로 진화해 간 과정을 다룬다.
첫 번째 벽: GPU Scene의 1,600만 인스턴스 상한
첫 번째 한계는 예상보다 훨씬 가까이 있었다. 자랑하던 렌더러에는 에셋당 약 1,600만 스플랫이라는 하드 캡이 숨어 있었는데, 그가 테스트한 에셋이 우연히 모두 그 아래였던 탓에 존재 자체를 몰랐던 것이다. 원인은 스플랫별 데이터가 어디에 사는지에 있었다. 모든 스플랫을 언리얼의 최신 메시 인스턴스로 등록한다는 것은 곧 GPU Scene, 즉 월드에 존재하는 거의 모든 것을 추적하는 중앙 원장에 데이터를 넘긴다는 뜻이다. GPU Scene은 수천 개 수준의 인스턴스를 전제로 설계된 구조이며, 메시당 최대 약 1,600만 인스턴스라는 내부 제한을 갖고 있다. 이를 넘기면 에셋의 일부만 보이고 그래픽 손상이 발생하며 뷰포트에 경고가 찍힌다.
해결책은 의외로 소박했다. 스플랫 추적을 GPU Scene에 맡기는 것을 아예 그만두고, 전통적인 DrawIndexedInstancedIndirect 호출에 가까운 고전적 간접 인스턴스 렌더링으로 되돌아간 것이다. 인스턴스를 GPU Scene에 등록하지 않고, 이미 매 프레임 정렬 키를 생성하며 전체 스플랫을 순회하던 셰이더에서 드로우 카운트를 받아 간접 드로우 버퍼에 넘겼다. 스플랫 인스턴스 데이터는 텍스처에 담아 GPU에 상주시키고, 작은 버텍스 팩토리를 작성해 버텍스 셰이더가 정렬된 스플랫 버퍼를 샘플링하도록 했다. 결과 이미지는 이전과 픽셀 단위로 동일했지만, 상한을 강제하던 주체가 파이프라인에서 빠지면서 3,000만 스플랫 에셋이 무리 없이 렌더링됐다.
이 전환은 뜻밖의 이득을 함께 가져왔다. 스플랫 메시는 언제나 단순한 쿼드이므로 셰이더 안에서 절차적으로 유도할 수 있어 실제 언리얼 메시를 지정할 필요가 사라졌고, 전체 방식이 바인드리스 렌더링에 가까워졌다. 더 중요한 것은, 어차피 매 프레임 전체 스플랫을 순회하던 김에 스플랫 단위 컬링을 그 안에서 수행해 카메라 절두체 안에 보이는 스플랫 수만큼만 그릴 수 있게 됐다는 점이다. 그려지는 스플랫 수가 매 프레임 GPU에서 가변적으로 결정되는 이 형태는, 의도치 않았지만 LOD 시스템이 요구하는 바로 그 구조—가능한 가장 늦은 시점에 매 프레임 다른 부분집합을 그리는 구조—그 자체였다.
두 번째 벽: 그릴 수 있는 양과 담을 수 있는 양은 다르다
인스턴스 상한을 걷어낸 지 일주일도 안 돼 다음 벽이 왔다. GPU Scene 탈출은 '얼마나 그릴 수 있는가'를 바꿨을 뿐 '얼마나 담을 수 있는가'는 그대로였다. 모든 스플랫은 여전히 상시 GPU 메모리에 올라가 있어야 했고, 위치·스케일·방향·불투명도·구면 조화 계수를 최대한 조밀하게 패킹해도 스플랫 하나가 약 32바이트였다. 실제 현장을 찍은 포토그래메트리 캡처는 머신의 VRAM 용량을 아무렇지 않게 넘어섰고, 더 짜낼 패킹의 여지도 없었다. 장면 전체가 메모리에 상주할 수 없다면, 렌더러가 매 프레임 어느 부분을 그릴지 정하고 그것을 가져와 그리는 수밖에 없다. 전형적인 LOD 문제다.
스플랫에는 버릴 폴리곤이 없지만 대신 '수가 너무 많다'는 특성이 있다. 40미터 떨어져 화면에서 6픽셀을 차지하는 영역에 쏟아부은 밀도는 대부분 낭비다. 따라서 스플랫 LOD는 한 영역을 솎아낸 복사본이다. 같은 구름이되 대부분의 입자를 제거하고 살아남은 입자를 키워 빈틈을 메운다. 채택한 포맷인 PlayCanvas의 Streamed SOG는 이 작업을 미리 구워 준다. 장면을 '리프(leaf)'라 불리는 영역들의 공간 트리로 쪼개고, 각 리프가 여러 단계의 솎아낸 LOD를 기술하며, 루트의 lod-meta.json이 전체 트리 구조와 각 청크의 위치를 설명한다.
그렇다면 보이는 영역마다 어느 LOD를 고를 것인가. 벌리의 첫 본능은 영리한 방법을 찾는 것이었지만, 더 나은 두 번째 본능은 결국 중요한 것은 '화면에서 얼마나 틀려 보이는가'뿐이며 그 척도는 픽셀이라는 사실을 떠올리는 것이었다. 여기에는 스크린 공간 오차(SSE)라는 수십 년 된 아이디어가 있다. 특정 단계가 유발하는 시각적 오차를 현재 카메라 거리에서 픽셀로 투영하고, 임계값 τ(타우) 아래에 머무는 가장 거친 단계를 고른다. 메시가 없는 스플랫에서는 밀도로 대신한다. 영역이 부피에 몇 개의 스플랫을 담는지에서 대략의 간격을 얻고, 이를 픽셀 크기로 투영해 τ와 비교하는 식이다. 이 τ는 프로젝트 설정에서 Low/Medium/High 품질 옵션으로 사용자에게 노출됐으며, 기본값 High는 '디테일을 아낌없이', Low는 '멀리서는 인색하게'를 뜻한다.
스트리밍을 받쳐 주는 덜 화려한 기계장치
정작 어려운 부분은 LOD 데이터를 GPU에 올리는 과정이었다. 장면을 처음 열면 텍스처 풀에는 아무것도 없다. LOD 선택이 '이 청크들을 달라'고 판단해도 그 청크는 아직 거기 없으므로, 먼저 로드하거나 심지어 다운로드해야 한다. 그래서 장면은 처음엔 비어 있다가, 거친 단계가 먼저 들어오고, 사용자가 실제로 보는 곳에 세밀한 디테일이 채워지는 식으로 거친 것에서 고운 것으로 눈앞에서 조립된다. Streamed SOG가 '스트림드'인 이유가 여기 있다. 리프 단위, LOD 단계 단위로 네트워크를 통해 전달되도록 설계돼, 에셋 전체를 로컬에 두지 않고 주변 리프의 LOD만 받아도 콘텐츠를 볼 수 있다.
개념은 단순하지만 구현은 이 시리즈에서 가장 까다로웠다. 청크 로드는 파일 읽기일 수도, 다른 대륙 서버로의 HTTP 요청일 수도 있어 게임 스레드를 막을 수 없으니 전체가 비동기 요청·전달 모델이어야 했고, 작업을 끝낸 스레드에서 콜백이 돌아오는 구조라 번거로운 스레드 동기화가 뒤따랐다. 안정적인 저해상도 화면을 최대한 빨리 띄우기 위해 영역의 가장 거친 단계를 먼저 요청했고, 청크 업로드에는 별도의 펜싱이 필요했다. GPU 메모리로의 업로드 완료와 CPU 측의 '그릴 준비 완료' 표시는 서로 다른 타임테이블의 사건이어서, 순서를 틀리면 한 프레임짜리 쓰레기 삼각형을 보게 된다. 그래서 청크는 업로드가 확실히 안착한 '다음' 프레임에야 그릴 수 있게 했다. 또한 버추얼 프로덕션에서는 하나의 언리얼 인스턴스가 여러 카메라를 동시에 렌더링하므로, 스플랫 데이터는 한 벌만 두되 LOD 선택 결정과 그 기록, 각 카메라용 GPU 전송은 따로 관리해야 했다.
세 번째 벽, 그리고 몇 달 전에 타이핑한 상수
스트리밍이 끝에서 끝까지 동작하자 벌리는 가장 거대한 캡처 하나를 밀어 넣었고, 렌더러는 "Texture2D cannot be created, exceeds this rhi's maximum dimension (16384)"라는 오류로 쓰러졌다. 모든 스플랫은 텍스처에 사는데, 그는 한 행에 4096개씩 배치하고 있었다. 텍스처 높이가 16384행으로 제한되므로 단일 텍스처는 약 6,700만 스플랫에서 한계에 닿고, 그 수를 넘기면 드라이버/RHI 계층이 텍스처 생성을 거부한다. 고칠 것은 두 가지였는데, 하나는 다소 민망한 일화였다. 초기에 행 크기를 4096이라는 상수로 고정하는 바람에 한 행당 쓸 수 있던 (16384 − 4096) 텍셀의 가로 공간을 통째로 놀리고 있었던 것이다. 행을 하드웨어 최대치까지 넓히자 같은 텍스처가 최대 2억 6,800만 스플랫(약 8.6GB VRAM)을 담게 됐고, 그제야 비로소 단일 텍스처의 실제 저장 한계에 도달했다.
최종 변경은 행 너비를 여기저기 박아 둔 상수에서 에셋별로 계산되는 값으로 바꾼 것뿐이라 사소했지만, 교훈은 그렇지 않았다. 몇 달 전에 무심코 타이핑한 임의의 상수를 근본적인 한계로 착각한 채 오래 씨름했다는 이야기이기 때문이다. 한국의 그래픽스·XR 실무자 입장에서 이 연작이 주는 함의는 분명하다. 엔진이 제공하는 범용 인스턴싱 경로(GPU Scene 같은)는 수천 단위를 전제로 최적화돼 있어, 수천만 단위를 다루는 포인트 클라우드/스플랫 워크로드에서는 명시적 간접 드로우와 텍스처 상주 데이터로 내려가는 편이 오히려 자연스럽다는 점이다. 또한 대규모 포토그래메트리를 제품화하려면 렌더링보다 스트리밍—비동기 로딩, 거친 단계 우선, 업로드 펜싱, 멀티뷰—이 진짜 난관이라는 사실, 그리고 '한계'라고 믿는 숫자가 실은 자신이 정한 상수인지부터 의심해 보라는 오래된 격언이다. 다만 이 글은 단일 스튜디오의 언리얼·PlayCanvas SOG 조합에 대한 1인칭 개발기이자 아직 완성 중인 렌더러에 대한 기록이므로, 구체적 수치나 설계 선택을 다른 엔진·포맷에 그대로 옮기기보다 접근 방식의 참고점으로 삼는 편이 안전하다.