ARM 기반 노트북과 서버가 빠르게 늘면서, 기존 x86용 애플리케이션을 그대로 실행하려는 수요도 커지고 있다. 여기서 흔히 간과되는 병목이 명령어 변환 자체가 아니라 '메모리 모델'의 차이다. x86 에뮬레이터 FEX 개발진이 공개한 해설에 따르면, x86의 TSO(Total Store Ordering) 메모리 모델을 ARM의 약한(weak) 메모리 모델 위에서 재현하는 일은 에뮬레이트되는 모든 애플리케이션에 광범위한 영향을 미치는 근본적 난제다.
메모리 모델은 로드(읽기)와 스토어(쓰기)가 서로 어떤 순서로 보이는지를 규정하는 규칙의 집합이다. x86의 TSO는 스펙트럼에서 가장 엄격한 축에 속한다. 어떤 코어가 메모리에 값을 쓰면 그 결과가 시스템의 다른 모든 프로세서에 일관되게 보인다고 프로그래머가 가정할 수 있고, 로드가 일어나는 시점에는 그 이전의 스토어들이 논리적으로 완료되어 있다고 볼 수 있다. '쓰면 곧 보인다'는 직관과 맞아떨어지는 대신, 하드웨어가 최적화할 여지는 거의 없다.
반대로 ARM의 약한 모델은 기본 로드·스토어가 코어 간에 곧바로 일관되지 않는다. 한 코어가 값을 써도 해당 캐시라인이 즉시 다른 코어에 보이지 않으며, 다른 코어의 캐시를 무효화하거나 스누핑하는 비용이 크기 때문에 이런 지연을 허용해 전력과 효율을 아낀다. 대신 순서를 강제하려면 별도의 수단이 필요한데, ARMv7 이전에는 성능 부담이 큰 메모리 배리어 명령을 썼고, 이후에는 load-acquire·store-release 명령(C++의 memory_order_acquire·release에 대응)을 도입해 배리어 없이 순서를 보장하는 RCsc 모델을 제공했다.
엄격함의 대가, 그리고 LRCPC라는 해법
FEX가 ARMv8.0-a에서 택한 출발점은 단순하다. x86의 모든 로드를 ARM의 load-acquire로, 모든 스토어를 store-release로 바꾸는 것이다. 이렇게 하면 x86과 사실상 같은 메모리 의미를 얻지만, 실제로는 필요 이상으로 엄격하다. 정확히 들어맞는 중간 단계 명령이 없었기 때문이다. 문제는 이 acquire/release 명령이 원래 드물게 쓰이도록 설계됐다는 점이다. 그런데 에뮬레이션에서는 초당 수백만 개의 로드가 전부 acquire가 되어 서로 재정렬조차 할 수 없게 되니 성능이 좋을 리 없다. FEX의 마이크로벤치마크에서도 테스트한 다섯 개 CPU 중 셋은 acquire-load에서 성능이 크게 떨어졌고, AmpereOne은 release-store가 유독 낮았으며 M1의 acquire 계열 로드도 기준치에 못 미쳤다. 반면 Cortex-X4나 X925는 뛰어난 성능을 보여, 이 부담이 하드웨어 설계 우선순위에 따라 크게 갈린다는 점을 드러냈다.
실질적 돌파구는 ARMv8.3부터 필수가 된 LRCPC 확장이다. 이 확장은 기존 RCsc 위에 RCpc(Release Consistency processor consistent) 모델을 얹은 새 로드 명령들을 추가하는데, 애초에 x86 에뮬레이션 요구사항을 겨냥해 설계됐다. 벤치마크상 거의 모든 플랫폼에서 LRCPC-load가 일반 로드와 대등한 성능을 냈다. FEX는 이 확장을 감지하면 acquire-load를 완전히 버리고 LRCPC-load로 전환한다. 다만 FEAT_LRCPC가 이미 세 차례 버전을 거치며 그때마다 미흡한 부분을 땜질해 왔다는 사실은, 이 접근이 완결된 해법이 아님을 시사한다.
애플의 우회로와 정렬(alignment) 지옥
가장 앞선 사례는 애플이다. 애플 실리콘은 CPU 기능을 켜면 일반 로드·스토어 명령의 동작이 x86-TSO에 맞게 바뀌는 하드웨어 토글을 직접 넣었다. 그래서 애플의 x86 에뮬레이터는 LRCPC 명령조차 쓰지 않고 평범한 로드·스토어만으로 처리하며, 벤치마크에서 오버헤드가 사실상 식별되지 않는다. FEX도 Asahi Linux에서 이 기능을 감지하면 활성화해 '공짜' 성능을 얻는다. TSO 모드에서 네이티브 ARM 코드가 불필요하게 느려질 수 있다는 우려가 있지만, 에뮬레이션 중 실행되는 네이티브 ARM 코드 비중은 0%에 수렴하므로 실무적으로는 무시할 만하다. FEX 개발진은 이런 하드웨어 TSO 토글이 고성능 x86 에뮬레이션의 가장 바람직한 길이라고 본다.
메모리 순서 문제를 넘겨도 정렬 문제가 남는다. x86 애플리케이션은 정렬을 신경 쓰지 않고 캐시라인 경계를 넘나들며 메모리에 접근하고, 정렬되지 않은 원자적 연산까지 태연히 수행한다. x86은 로드·스토어가 한 캐시라인 안에 들어오면 원자성과 일관성을 보장하지만, 경계를 넘으면 원자성이 깨지고 다른 스레드가 값이 찢어진 상태(tearing)를 볼 수 있다고 규정한다. 문제는 ARMv8.0의 acquire/release가 자연 정렬을 요구한다는 점이다. 8바이트 접근은 0·8·16 같은 오프셋에 놓여야 하며, 어긋나면 CPU가 정렬 폴트를 일으켜 대개 크래시로 이어진다. 이 정렬 미준수가 원자적 연산에서 캐시라인을 넘으면 이른바 '스플릿 락(split-lock)'이 되는데, 리눅스 커널이 이를 포착해 게임 실행을 느리게 만들 정도로 심각한 사안이다.
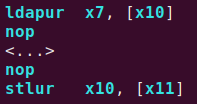
FEX는 이 상황을 JIT 차원에서 우회한다. 정렬 폴트를 낼 수 있는 로드·스토어에는 명령 앞뒤에 NOP 형태의 '패치포인트'를 심어 두고, 실제로 폴트가 발생하면 이를 가로채 해당 코드를 acquire/release에서 일반 로드·스토어로 즉석에서 교체한다. 이런 세부 우회 장치들이 쌓여야 비로소 대중적인 x86 게임과 애플리케이션이 ARM에서 그럭저럭 돌아간다.
한국의 실무자 관점에서 이 이야기의 함의는 분명하다. ARM 전환의 실제 성능은 명령어 세트 호환성보다 메모리 모델 지원 수준에 크게 좌우된다는 것이다. 같은 ARM이라도 LRCPC 지원 여부와 버전, 나아가 애플식 하드웨어 TSO 토글의 유무에 따라 에뮬레이션 성능 격차가 벌어진다. 도입을 검토한다면 대상 칩이 어떤 확장을 갖췄는지 확인하는 것이 우선이며, 아직 하드웨어 토글이 없는 플랫폼에서는 정렬 폴트 처리 같은 소프트웨어 우회의 비용을 감안해야 한다. 결국 완전한 해법은 하드웨어 차원의 TSO 지원이 얼마나 널리 표준화되느냐에 달려 있고, LRCPC 확장이 계속 버전을 더해 온 흐름을 보면 이 문제는 당분간 더 다뤄질 여지가 남아 있다.