문자 인코딩은 대개 완성된 표준으로 취급되어 실무자의 관심 밖에 있다. 하지만 유니코드를 담는 그릇인 UTF-8이 왜 지금의 모양을 하고 있는지 이해하면, 파일 파싱과 스트림 처리에서 반복적으로 마주치는 문제들의 뿌리가 보인다. 최근 공개된 UTF-8000은 UTF-8을 '무제한 길이'로 확장하는 사고 실험이자 명세로, 현행 UTF-8이 실은 더 큰 설계의 일부에 불과하다는 점을 드러낸다. 실용적으로 당장 도입할 물건은 아니지만, 인코딩의 내부 구조를 다시 들여다보게 만든다는 점에서 읽을 가치가 있다.
UTF-8의 두 가지 자기 완결성
UTF-8이 오래 살아남은 이유는 두 가지 성질에 있다. 첫째는 자기 동기화(self-synchronization)다. 모든 바이트의 최상위 비트가 그 바이트의 역할을 스스로 알려 준다. 첫 바이트는 접두 비트가 0(ASCII)이거나 11(멀티바이트 시작)이고, 이어지는 연속 바이트는 언제나 10으로 시작한다. 덕분에 파일 중간의 임의 위치로 건너뛰어도, 그 앞을 전혀 읽지 않고 지금 바이트가 코드 유닛의 시작인지 중간인지 즉시 판별할 수 있다. 이는 랜덤 액세스뿐 아니라 오류 복구에도 쓸모가 있다. 손상된 스트림에서 잘못된 바이트(예: 0xC0)를 만나면 U+FFFD 대체 문자를 내보내고 다음 첫 바이트가 나올 때까지 버리며 '침착하게 계속' 진행할 수 있다.
둘째는 자기 구두점(self-punctuation), 즉 접두 부호 성질이다. 첫 바이트의 상위 비트 패턴(110, 1110, 11110…)이 코드 유닛의 전체 길이를 미리 알려 준다. 길이를 표시하는 이 비트열은 1이 이어지다 0으로 끝나는 단항 부호(unary code) 형태다. 종료 0 비트를 만나는 순간 남은 바이트 수가 확정되므로, 다음 코드 유닛의 첫 바이트까지 넘겨다보지 않아도 현재 문자가 어디서 끝나는지 안다. 길이를 내장하지 않는 순진한 가변 길이 인코딩이라면 매번 다음 단위를 미리 읽거나, 심하면 구분자 바이트를 따로 끼워 넣어야 하는 문제를 UTF-8은 구조적으로 피한다.
시작 비트를 여러 바이트에 걸쳐 펼치기
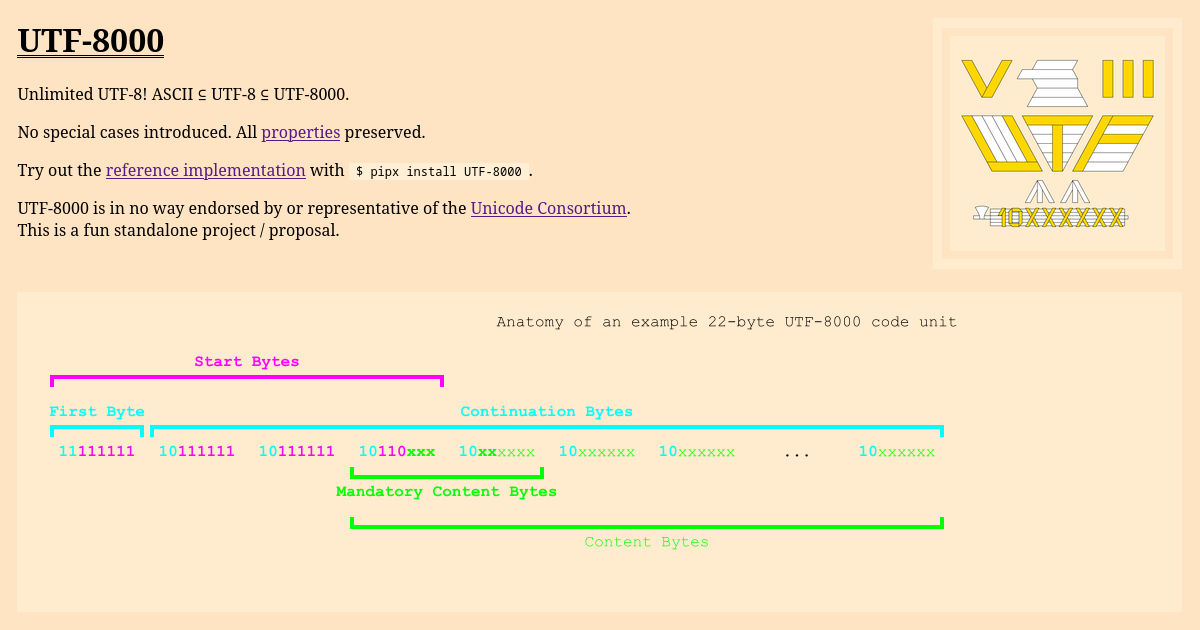
UTF-8000의 핵심 기여는 첫 바이트 상위 비트를 '자기 동기화 비트'와 '시작 비트'로 명확히 분리하고, 필요하면 시작 비트를 여러 바이트에 걸쳐 줄무늬처럼 펼치는(striping) 방식을 정의한 데 있다. 현행 UTF-8은 최대 4바이트(옛 표준에서는 6바이트)로 제한되어 시작 바이트가 항상 첫 바이트 하나뿐이지만, UTF-8000에서는 시작 비트가 첫 바이트를 넘어 뒤따르는 연속 바이트의 빈 자리까지 이어질 수 있다. 그 결과 시작 바이트가 여러 개 생기고, 코드 유닛 길이에 원리상 상한이 사라진다. 명세가 든 예시는 22바이트짜리 코드 유닛인데, 이는 특수 사례가 아니라 여러 시작 바이트가 동작하는 전형을 보여 주는 표본일 뿐이다.
이 확장에서 흥미로운 지점은 바이트의 역할이 더는 단순하게 겹치지 않는다는 것이다. 예시의 네 번째 바이트는 연속 바이트이면서 동시에 마지막 시작 바이트이고, 내용 비트도 일부만 담는다. 어떤 바이트가 내용 바이트라고 해서 연속 바이트인 것도 아니고(3바이트 유닛의 1110xxxx는 내용 비트 4개를 갖지만 연속 바이트가 아니다), 연속 바이트라고 해서 내용 비트를 갖는 것도 아니다(22바이트 유닛의 두 번째 바이트 10111111은 내용 비트가 없다). 개념들이 직교적으로 정의되어 있어야 이런 긴 유닛을 모순 없이 다룰 수 있다.
비트 수가 공식으로 떨어진다는 점
UTF-8000이 스스로를 '정본에 가까운 확장'이라 자부하는 근거는, 확장하면서도 새로운 특수 사례를 하나도 만들지 않는다는 데 있다. n바이트 코드 유닛(n>1)의 내용 비트는 5n+1개로 딱 떨어진다. 8n비트에서 바이트마다 자기 동기화 접두 2비트를 빼고, 시작 비트열 n-1비트를 더 빼면 5n+1이 남는다. 바이트를 하나 늘릴 때마다 연속 바이트에서 6비트를 얻지만 길어진 시작 비트열에 1비트를 내주므로 순증가는 5비트라는 계산과도 맞아떨어진다.
특수 사례는 UTF-8에서 물려받은 두 가지뿐이다. 하나는 ASCII로, 최상위 비트 0에 7개 내용 비트가 붙어 원형 그대로 포함되며 오버롱 검사가 필요 없다. 다른 하나는 2바이트 유닛으로, 필수 내용 비트가 5개가 아니라 4개다. ASCII의 7비트에서 2바이트의 11비트로 넘어갈 때 늘어나는 비트가 4개이기 때문이다. 이 필수 내용 비트에 최소한 1이 하나는 있어야 한다는 규칙이 오버롱 인코딩을 막는다. 흥미롭게도 2바이트의 필수 내용 비트 4개가 모두 첫 바이트에 몰려 있어, 0xC0과 0xC1은 어떤 유효한 유닛에도 영원히 등장할 수 없는 바이트로 확정된다.
오버롱 금지가 보안 문제인 이유
오버롱 인코딩 금지는 학술적 엄밀성의 문제가 아니라 실무 보안의 문제다. 예컨대 널 문자(코드포인트 0)를 11100000 10000000 10000000처럼 더 긴 유닛으로 위장해 인코딩할 수 있다면, strcpy 같은 C 함수는 이를 널 바이트로 보지 않아 최선의 경우 세그폴트, 최악의 경우 심각한 취약점으로 이어진다. 모든 코드포인트가 유일한 표현만 갖도록 강제하는 것은 인코딩 우회 공격을 막는 오래된 방어선이며, 이 원칙이 임의 길이 확장에서도 그대로 유지된다는 점이 UTF-8000이 강조하는 대목이다.
실무자가 이 명세에서 당장 가져갈 것은 새 인코딩 자체가 아니다. UTF-8000은 유니코드 컨소시엄의 표준이 아니며, 현행 코드포인트 공간을 넘어서는 값을 쓸 실제 수요도 없다. 오히려 값어치는 관점에 있다. 켄 톰프슨과 롭 파이크가 초기 초안에서 6바이트 시작 바이트를 111111xx로 두었다가 며칠 만에 1111110x로 바꾼 것은, 시작 비트가 바이트를 가득 채워 특수 사례가 되는 일을 피하기 위해서였다. 이 작은 결정 하나가 수십 년 뒤의 무제한 확장을 가능하게 했다는 사실은, 인코딩이든 프로토콜이든 자기 동기화와 자기 구두점 같은 성질을 처음부터 설계에 심어 두는 일이 왜 중요한지를 되짚게 한다.