무슨 일이 있었나요?
요즘 LLM API 가격표를 보면 깜짝 놀랄 때가 많아요. OpenAI와 Anthropic이 불과 몇 달 사이에 모델 가격을 최대 80%까지 내렸다는 이야기가 나왔거든요. 같은 일을 시켰는데 청구서가 5분의 1로 줄어든다는 뜻이니까, 서비스를 운영하는 입장에서는 엄청난 변화죠.
그런데 좀 이상하지 않나요? AI 회사들은 모델 학습에 천문학적인 돈을 쓰고, GPU는 여전히 비싸고, 크게 흑자를 냈다는 소식도 별로 없어요. 그런데 왜 이렇게 공격적으로 가격을 내릴까요? 여기엔 기술적인 이유와 경제적인 이유가 함께 얽혀 있어요. 하나씩 풀어볼게요.
먼저 알아둘 것: LLM 가격은 어떻게 매겨지나요
LLM API는 보통 토큰 단위로 돈을 받아요. 토큰이 뭐냐면, 모델이 글을 읽고 쓰는 최소 조각이에요. 단어나 글자를 잘게 쪼갠 단위라고 보면 돼요. 가격은 보통 '100만 토큰당 몇 달러'로 표시되고, 모델에 넣는 입력보다 모델이 만들어내는 출력이 훨씬 비싸요. 출력은 한 토큰씩 순서대로 만들어야 해서 GPU를 더 오래 붙잡고 있거든요.
기술적인 이유: 같은 답을 더 싸게 만드는 방법
1. 추론 최적화가 엄청나게 발전했어요. '추론(inference)'은 학습이 끝난 모델이 실제로 답을 만들어내는 과정이에요. 여기서 비용을 깎는 기술이 계속 쌓이고 있어요. 예를 들어 FP8, FP4처럼 정밀도가 낮은 숫자로 계산하면 메모리와 연산량이 확 줄어요. 추측 디코딩(speculative decoding)은 작고 빠른 모델이 다음 몇 토큰을 먼저 '찍어두면' 큰 모델은 한 번에 검사만 하는 방식이에요. 그만큼 큰 모델을 덜 돌려도 되죠. 받아쓰기할 때 친구가 초안을 먼저 적어주고 나는 틀린 것만 고치는 셈이에요.
2. 프롬프트 캐싱이 흔해졌어요. 챗봇이나 에이전트는 매번 긴 시스템 프롬프트나 같은 문서를 반복해서 보내는 경우가 많아요. 이미 계산한 앞부분을 저장해 뒀다가 다시 쓰면 그만큼 계산을 건너뛸 수 있어요. 두 회사 모두 캐시된 입력에는 할인된 가격을 받고 있어요.
3. 모델 구조 자체가 효율적으로 바뀌었어요. 전체 모델 중 일부만 골라서 계산하는 MoE(Mixture of Experts) 구조, 그리고 큰 모델의 지식을 작은 모델에 옮겨 담는 증류(distillation) 덕분에, 1년 전 최상위 모델 수준의 성능을 훨씬 작은 모델로 낼 수 있게 됐어요.
4. 하드웨어가 좋아지고 다양해졌어요. 엔비디아의 새 세대 GPU는 같은 전력으로 이전 세대보다 훨씬 많은 토큰을 만들어내요. Anthropic은 구글 TPU와 아마존 Trainium 같은 전용 칩도 대규모로 쓰고 있어서, 엔비디아에만 기댈 때보다 원가를 낮출 여지가 커졌어요.
경제적인 이유: 싸게 팔아야 하는 사정
기술만으로 다 설명되지는 않아요. 시장 상황도 큰 몫을 하거든요.
가장 큰 건 오픈 웨이트 모델과의 경쟁이에요. DeepSeek, Qwen 같은 모델이 꽤 높은 성능을 무료로 공개했고, 여러 호스팅 업체가 이걸 아주 싼 가격에 API로 팔고 있어요. 상용 모델이 '조금 더 똑똑하다'는 이유만으로 몇 배 비싼 가격을 유지하기가 점점 어려워진 거죠.
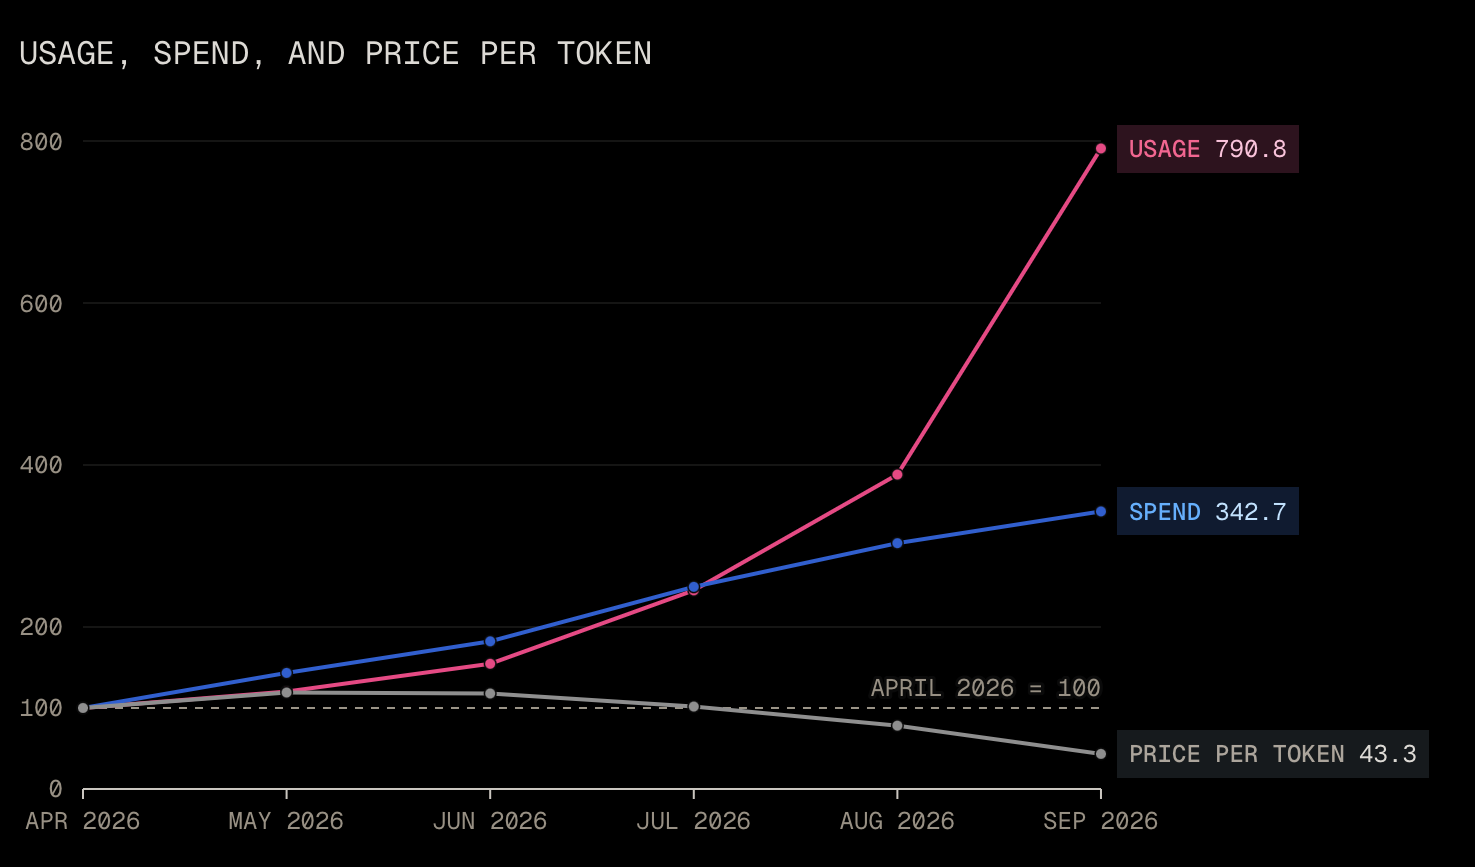
에이전트 시대의 토큰 폭증도 중요해요. 요즘 AI 코딩 도구나 에이전트는 작업 하나를 끝내려고 파일을 읽고, 도구를 부르고, 스스로 검토하면서 예전 챗봇보다 훨씬 많은 토큰을 써요. 단가가 그대로면 고객이 감당을 못 하니까, 단가를 내려야 사용량이 늘어나요. 경제학의 '제번스의 역설'과 비슷한 이야기인데요, 자원이 싸지면 오히려 전체 소비량이 늘어나는 현상이에요. 회사 입장에서는 단가를 내려도 총매출은 늘 수 있다는 계산이 서는 거죠. 여기에 시장 선점 계산도 있어요. 개발자는 한번 특정 API로 제품을 만들면 쉽게 갈아타지 않으니까요.
주의할 점: 단가가 내려가도 청구서는 그대로일 수 있어요
함정이 하나 있어요. 추론형(reasoning) 모델은 답을 내기 전에 속으로 긴 생각 과정을 거치는데, 이 생각에도 출력 토큰 요금이 붙어요. 그래서 토큰당 가격이 80% 내려가도 작업 하나에 쓰는 토큰이 5배 늘면 비용은 결국 비슷해요. 가격표 숫자보다 작업 하나당 실제 비용을 재보는 게 훨씬 중요해요.
한국 개발자에게 주는 시사점
예전에 “LLM은 너무 비싸서 우리 서비스엔 못 넣는다”고 접어둔 기능이 있다면, 지금 다시 계산해볼 만해요. 실무 팁 몇 가지를 정리해볼게요.
- 캐싱이 잘 되도록 프롬프트 구성하기: 바뀌지 않는 시스템 프롬프트와 문서는 앞쪽에, 바뀌는 사용자 입력은 뒤쪽에 두면 캐시 적중률이 올라가요.
- 배치 API 쓰기: 리뷰 분류나 데이터 정제처럼 실시간 응답이 필요 없는 대량 작업은 배치 API로 돌리면 보통 꽤 큰 할인을 받을 수 있어요.
- 모델 라우팅: 쉬운 요청은 작은 모델로, 어려운 요청만 큰 모델로 보내면 비용이 크게 줄어요.
- 갈아타기 쉬운 구조 만들기: 가격은 계속 바뀌니까 특정 API에 코드를 강하게 묶지 말고, LiteLLM 같은 추상화 계층을 고려해보세요.
마무리
한 줄 정리: LLM 가격 인하는 기술 발전, 오픈 모델과의 경쟁, 그리고 '더 많이 쓰게 만들려는' 전략이 겹친 결과예요. 이제 중요한 건 토큰 단가가 아니라 작업 하나당 비용이에요.
여러분은 이 가격 하락이 계속될 거라고 보시나요, 아니면 시장을 장악하고 나면 다시 오를 거라고 보시나요? 가격이 내려가서 새로 시도해보게 된 기능이 있다면 이야기 나눠주세요!
🔗 출처: Hacker News