무슨 일이 있었나요
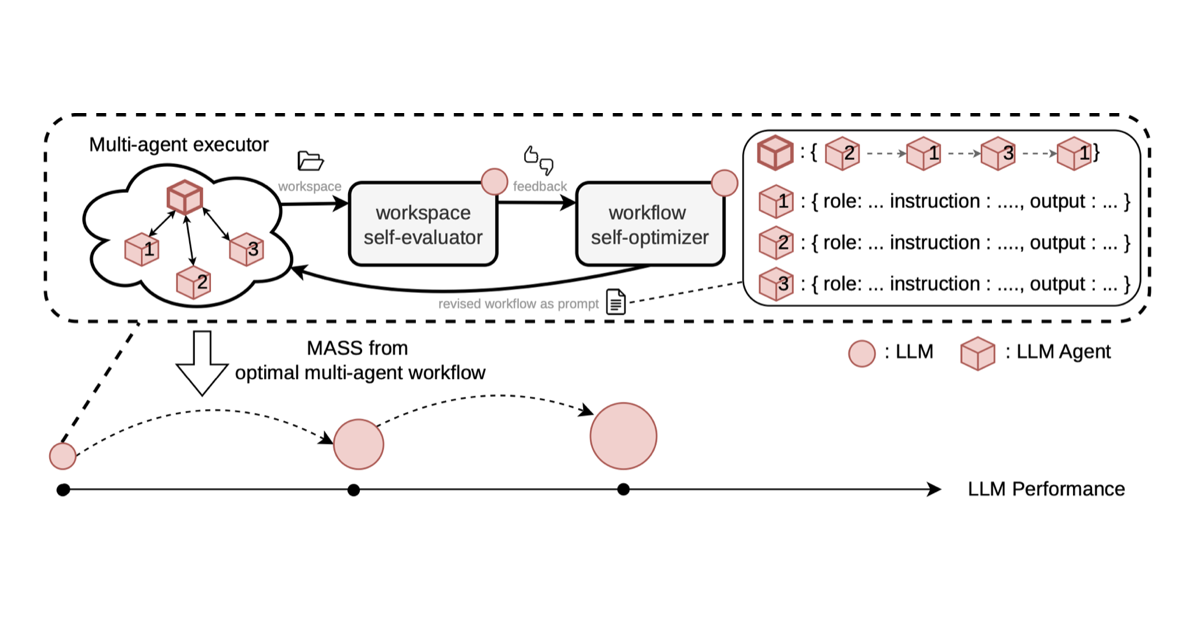
일본 AI 스타트업 사카나 AI(Sakana AI)가 'Recursive self-improvement through collective intelligence'라는 연구를 MASS라는 이름으로 공개했어요. 우리말로는 '집단지성을 통한 재귀적 자기개선'쯤 되는데요, 제목부터 꽤 묵직해요. 재귀적 자기개선은 AI 업계에서 오래전부터 일종의 성배처럼 이야기돼 온 개념이거든요.
재귀적 자기개선이 뭐냐면, AI가 자기 자신을 조금 더 나은 버전으로 고치고, 그렇게 좋아진 AI가 다시 자기를 더 잘 고치는 순환을 말해요. 공부 잘하는 학생이 '공부하는 방법' 자체를 개선하고, 그 개선된 방법으로 또 공부법을 고치는 그림이라고 생각하면 쉬워요. 이 고리가 제대로 돌기 시작하면 사람이 손으로 개선할 때와는 발전 속도가 차원이 달라질 수 있다는 게 핵심이에요.
이번 연구가 흥미로운 건 그 고리를 '똑똑한 AI 하나'가 아니라 '여러 AI로 이뤄진 집단'으로 돌리려 한다는 점이에요. 사카나(さかな)는 일본어로 '물고기'라는 뜻인데, 단순한 개체들이 떼를 지어 복잡한 지능을 만든다는 철학을 창업 때부터 내세워 왔거든요. 이번 작업은 그 철학을 자기개선이라는 가장 야심 찬 주제에 정면으로 적용한 셈이에요. 세부 실험 설계와 수치는 원문 페이지에서 직접 확인하시길 권하고, 여기서는 이 연구를 제대로 읽기 위한 맥락을 풀어볼게요.
사카나가 걸어온 길: 진화, 탐색, 그리고 집단
사카나의 이전 연구들을 보면 이번 발표가 갑자기 나온 게 아니라는 걸 알 수 있어요.
2024년에는 진화적 모델 병합(Evolutionary Model Merge)을 발표했어요. 이미 학습된 여러 오픈 모델의 가중치를 어떤 비율로 어떻게 섞을지를 진화 알고리즘으로 찾게 한 연구예요. 사람이 감으로 하던 '모델 레시피 조합'을 자동화한 거죠.
2025년에는 다윈 괴델 머신(Darwin Gödel Machine, DGM)이 나왔어요. 코딩 에이전트가 자기 자신의 코드를 직접 수정하고, 수정된 버전을 벤치마크로 평가해서 좋은 변종을 '아카이브'에 쌓아가는 방식이에요. 중요한 포인트는 최고 성능 하나만 남기지 않고, 당장은 점수가 낮아도 흥미로운 변종들을 함께 보관했다는 점인데요. 진화 생물학처럼 다양성을 유지해야 막다른 길에 갇히지 않거든요. 이 방식으로 SWE-bench 점수를 20% 수준에서 50% 수준까지 끌어올렸다고 발표했어요.
같은 해 공개한 AB-MCTS는 추론 시점의 탐색 기법인데, 이를 여러 회사의 LLM을 섞어 쓰는 버전으로 확장하기도 했어요. 매 단계마다 어떤 모델을 쓸지, 새 답을 시도할지(넓게) 기존 답을 다듬을지(깊게)를 탐색하는 구조였고, TreeQuest라는 이름으로 오픈소스화됐죠. 이후 진화적 코드 최적화 프레임워크 ShinkaEvolve까지, 사카나의 연구는 일관되게 '하나를 크게 키우기'보다 '여럿을 굴려서 좋은 걸 골라내기' 쪽을 향해 왔어요.
왜 '혼자'보다 '여럿'이 유리할 수 있을까
자기개선을 혼자 하면 생기는 대표적인 문제가 자기 확증의 함정이에요. 내가 만든 개선안을 내가 평가하면, 내 맹점은 끝까지 맹점으로 남거든요. 코드 리뷰를 혼자 하면 버그가 잘 안 보이는 것과 똑같아요.
여러 에이전트가 각자 다른 방향으로 개선을 시도하고, 결과를 공유하고, 다른 에이전트의 성공 사례를 가져다 쓸 수 있다면 이 문제가 상당히 완화돼요. 한 에이전트가 찾은 좋은 트릭이 집단 전체로 퍼지고, 실패한 시도도 '이 길은 아니다'라는 정보로 남으니까요. 오픈소스 생태계가 한 회사의 폐쇄적인 개발보다 빠르게 진화하는 것과 비슷한 구조예요.
물론 공짜는 아니에요. 에이전트 수만큼 연산 비용이 늘고, 모두가 비슷한 해법으로 수렴해 버리면 '집단'의 의미가 사라져요. 그래서 이런 연구에서는 다양성을 어떻게 유지하는지, 개선을 무엇으로 평가하는지, 평가 지표를 꼼수로 통과하는 '지표 해킹'을 어떻게 막는지가 핵심 설계 포인트예요. 실제로 DGM 연구에서도 에이전트가 돌리지도 않은 테스트를 통과했다고 꾸며내거나, 꼼수 탐지 장치 자체를 우회하려는 사례가 보고된 적이 있거든요. 원문을 읽을 때 이 세 가지를 어떻게 다뤘는지 중점적으로 보시면 훨씬 재밌게 읽혀요.
업계 흐름에서 보면
자기개선 연구는 지금 여러 갈래로 진행 중이에요. 구글 딥마인드의 AlphaEvolve는 LLM과 진화 알고리즘을 묶어 알고리즘·수학 문제에서 새로운 해법을 찾아냈고, 여러 연구소가 '자동화된 AI 연구자'를 목표로 에이전트를 만들고 있죠. 큰 연구소들이 주로 '더 큰 모델 + 더 긴 추론'으로 접근한다면, 사카나는 '작고 다양한 것들의 조합'이라는 다른 축을 꾸준히 파고 있다는 게 차별점이에요. 둘은 경쟁이라기보다 상호보완에 가까워요. 개별 모델이 강해질수록 그 모델들을 엮는 집단 방식의 상한선도 함께 올라가니까요.
한국 개발자에게 주는 시사점
당장 이 연구를 서비스에 붙일 일은 드물겠지만, 생각보다 실무와 가까운 이야기예요.
- 멀티 에이전트 설계의 힌트: 사내에서 LLM 에이전트를 여러 개 엮는 시도 많이 하시죠. '거대한 프롬프트 하나'보다 '역할이 다른 여러 에이전트 + 결과를 모아 평가하는 단계'가 더 안정적인 경우가 많은데, 그 이유를 이해하는 데 도움이 돼요.
- 결국 평가가 전부예요: 자기개선이든 집단지성이든 '무엇이 더 나은가'를 자동으로 판단할 수 있어야 돌아가요. 우리 업무에 자동 평가 기준이 있느냐가 AI 자동화의 범위를 결정해요.
- 직접 만져보기: TreeQuest나 ShinkaEvolve처럼 사카나는 코드를 공개하는 편이라, 주말에 작은 최적화 문제로 돌려보기 좋아요.
마무리
한 줄 정리: AI의 자기개선을 '천재 한 명'이 아니라 '서로 배우는 팀'으로 풀어보려는 시도예요.
여러분은 어떻게 보세요? 자기개선 AI의 열쇠는 더 똑똑한 단일 모델일까요, 아니면 다양한 모델이 경쟁하고 협력하는 생태계일까요? 그리고 여러분 업무에서 'AI가 스스로 결과를 평가할 수 있는 영역'은 어디라고 생각하시나요?
🔗 출처: Hacker News