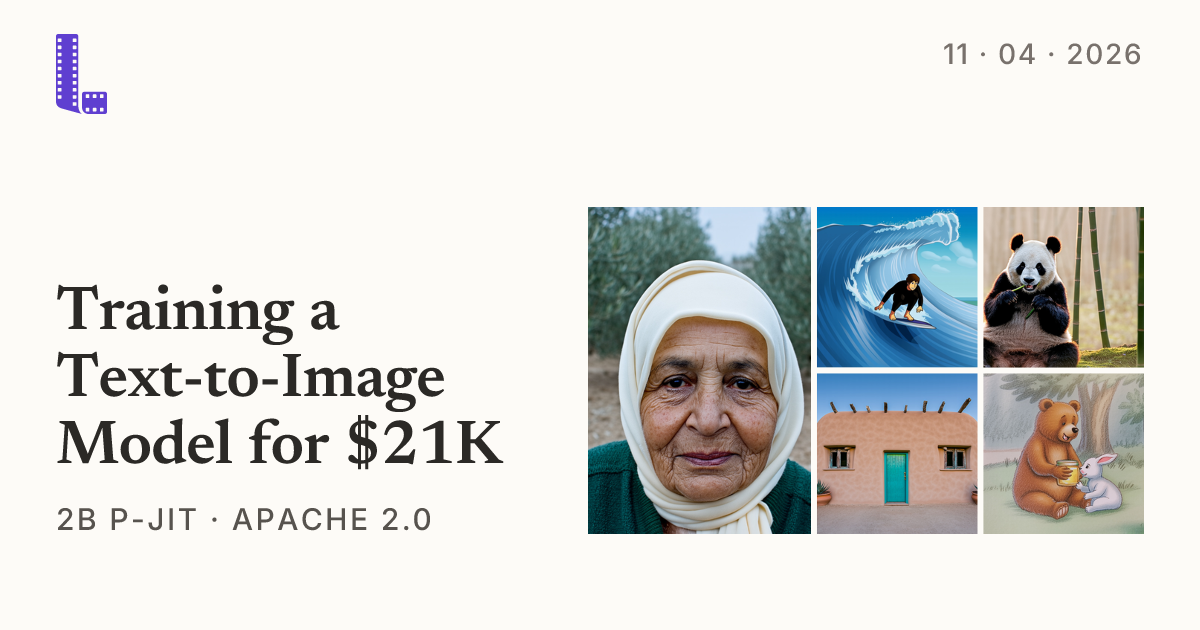
2만 달러로 이미지 생성 모델을 학습했다고요?
Linum 팀이 약 2만 달러를 들여 학습한 text-to-image 모델을 공개했어요. text-to-image는 '노을 지는 바닷가의 고양이'처럼 글을 넣으면 그림을 만들어 주는 모델이에요. 가중치(weights)도 Apache 2.0 라이선스로 풀었는데요, 가중치는 모델이 학습하면서 얻은 숫자 덩어리, 쉽게 말해 모델의 '뇌'예요. 이걸 공개했다는 건 누구나 내려받아 돌려 보고 고쳐 볼 수 있다는 뜻이에요.
팀 스스로도 'decent', 그러니까 '꽤 괜찮은 수준'이라고 표현했어요. 최고 성능 모델을 이겼다는 이야기가 아니에요. 이 소식의 핵심은 성능 순위보다 비용이거든요. 대형 연구소의 영역처럼 보였던 일이 작은 팀의 예산 안으로 얼마나 들어왔는지 보여 주는 사례니까요.
2만 달러는 얼마나 작은 숫자일까
과거 사례와 비교해 보면 감이 와요. 2022년 Stable Diffusion 초기 버전의 학습 비용은 약 60만 달러로 알려져 있었어요. 2023년에는 MosaicML이 Stable Diffusion 2 수준의 모델을 5만 달러 이하로 학습할 수 있다고 발표했고요. PixArt-α 논문은 학습 비용을 약 2만 6천 달러로 제시했어요. 2024년 Sony AI 연구진은 약 1,890달러로 학습한 이른바 '마이크로 버짓' 모델까지 내놨고요.
물론 이 숫자들을 그대로 줄 세우면 안 돼요. GPU 단가, 데이터 준비 비용, 실패한 실험 비용을 넣었는지가 전부 다르거든요. 그래도 방향은 분명해요. 4년 사이에 '쓸 만한 모델'의 가격표가 자릿수 단위로 내려왔어요.
감을 잡기 위해 계산도 해 볼게요. H100 GPU를 시간당 2~3달러에 빌린다고 가정하면, 2만 달러는 대략 7천~1만 GPU 시간이에요. GPU 8장짜리 서버 한 대를 5~7주 돌리는 규모죠. 실제 Linum의 구성은 다를 수 있지만, 스타트업이나 연구실이 충분히 결재받을 수 있는 금액이라는 건 체감되실 거예요.
비용은 어디서 줄어들까
구체적인 학습 레시피는 Linum의 원문 노트에서 직접 확인해 보세요. 어떤 데이터를 얼마나 썼는지가 재현의 핵심이니까요. 여기서는 저예산 이미지 모델 학습에서 흔히 쓰는 기법을 풀어 볼게요.
첫째는 압축된 공간에서 학습하기예요. 이미지를 픽셀 그대로 다루면 계산량이 어마어마해요. 그래서 VAE라는 압축기로 이미지를 작은 요약본으로 바꾼 뒤 그 위에서 학습해요. 원본 사진 대신 핵심만 적은 메모로 공부하는 셈이에요.
둘째는 이미 있는 부품 재사용이에요. 글의 뜻을 이해하는 텍스트 인코더를 처음부터 만들지 않고, 공개된 언어 모델을 가져다 쓰는 방식이죠. 학습해야 할 범위가 크게 줄어요.
셋째는 쉬운 것부터 배우기예요. 저해상도로 구도와 형태를 먼저 익히고, 마지막에 고해상도로 넘어가요. 고해상도 학습은 비싸니까 뒤에 짧게 쓰는 거예요.
넷째는 데이터의 질이에요. 웹에서 긁어 온 이미지 설명은 '사진1.jpg' 수준일 때가 많아요. 이미지를 보고 자세한 설명을 다시 만들어 주면 같은 양의 데이터로도 훨씬 빨리 배워요. PixArt-α가 비용을 줄인 핵심 요인 중 하나도 이런 고품질 캡션이었어요.
라이선스가 왜 이렇게 중요할까
오픈 모델이라고 다 같은 오픈이 아니거든요. Stable Diffusion 초기 모델은 사용 제한 조항이 붙은 OpenRAIL 계열 라이선스를 썼고, FLUX.1 [dev]는 비상업 라이선스로 나왔어요. 회사에서 쓰려면 약관을 꼼꼼히 봐야 했죠.
Apache 2.0은 저작권 고지 같은 조건만 지키면 상업적 사용, 수정, 재배포가 가능한 라이선스예요. 최근에는 FLUX.1 [schnell], Qwen-Image처럼 이 라이선스로 나오는 이미지 모델도 늘고 있고요. 다만 모델의 라이선스가 학습 데이터의 저작권 문제까지 해결해 주는 건 아니에요. 상용 서비스에 붙이기 전에는 학습 데이터 출처도 함께 확인하세요.
한국 개발자에게 주는 시사점
지금 당장 최고 화질이 필요하다면 상위 오픈 모델이나 상용 API가 더 나은 선택일 거예요. 이번 사례의 진짜 가치는 다른 곳에 있어요.
웹툰, 패션, 인테리어처럼 특정 도메인의 깨끗한 데이터를 가진 팀이라면 작은 모델을 직접 학습하는 일이 현실적인 선택지가 됐어요. 범용 모델이 못 그리는 우리만의 스타일을 만들 수 있으니까요. 한국어 프롬프트 이해를 높이려고 텍스트 인코더를 바꿔 실험해 보는 것도 재미있는 주제고요. 다만 이미지 속에 한글을 제대로 그리는 건 훨씬 어려운 별개의 문제예요.
학습 관점에서도 좋은 교재예요. 작은 예산의 학습 기록에는 어디서 돈을 아꼈고 무엇을 포기했는지가 드러나기 쉽거든요. 서비스에 붙일 계획이라면 2026년 1월 시행된 AI 기본법의 생성물 표시 의무도 함께 살펴보시고요.
마무리
한 줄로 정리하면, 이미지 생성 모델은 이제 '살 수만 있는 것'에서 '작은 팀도 만들어 볼 수 있는 것'으로 넘어오고 있어요. 여러분에게 2만 달러의 GPU 예산이 주어진다면 어떤 도메인의 모델을 학습해 보고 싶으세요? 범용 모델을 파인튜닝하는 것과 작은 모델을 직접 학습하는 것 중 어느 쪽이 더 낫다고 보시나요?
🔗 출처: Hacker News