E2E 테스트, 다들 한 번쯤 포기해보셨죠?
프론트엔드 개발을 조금이라도 해보셨다면 이런 경험이 있으실 거예요. 큰마음 먹고 E2E 테스트를 짜놨어요. E2E 테스트는 실제 사용자처럼 브라우저를 띄워서 회원가입부터 결제까지 흐름 전체를 처음부터 끝까지 확인하는 테스트예요. 그런데 디자이너가 버튼 위치를 옮기고 클래스 이름을 하나 바꾸자 테스트 수십 개가 한꺼번에 빨간불이 들어와요. 고치다 지쳐서 결국 CI에서 테스트를 꺼버리는 팀이 생각보다 정말 많거든요.
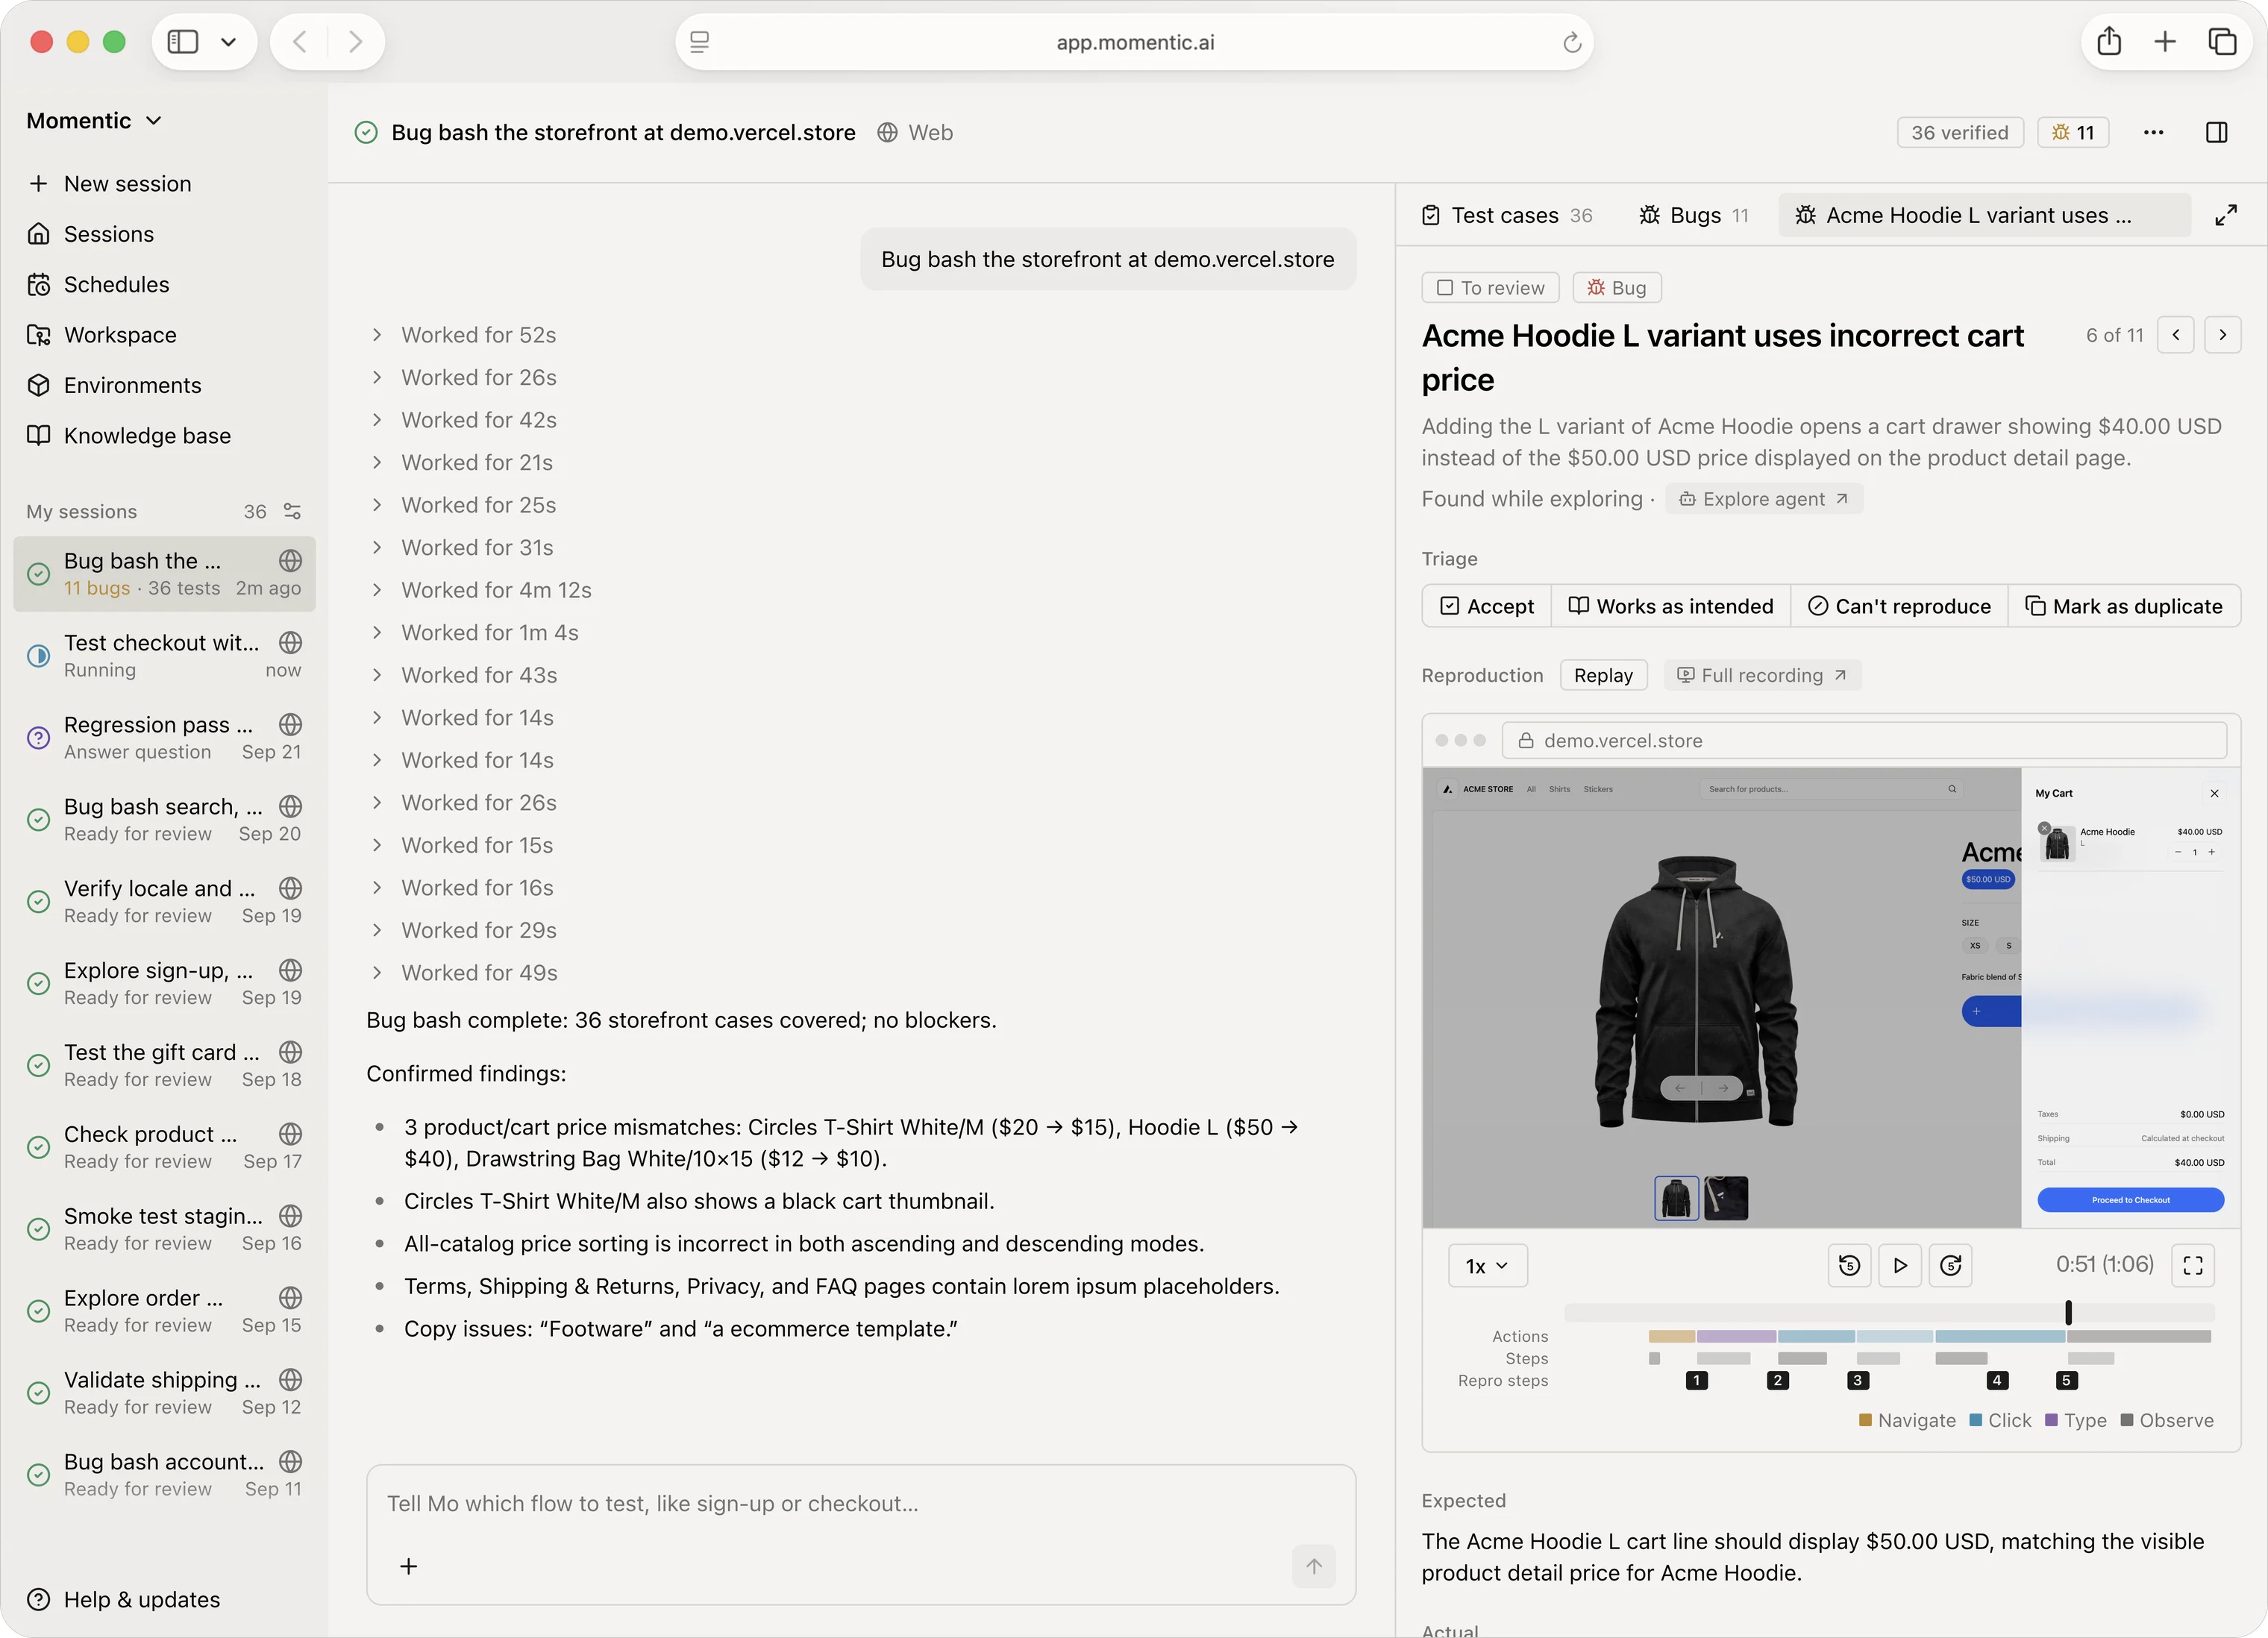
YC W24 배치 출신 스타트업 Momentic은 바로 이 문제를 정면으로 겨냥해요. 컨셉을 한 문장으로 줄이면 “AI 에이전트가 진짜 사용자처럼 앱을 직접 써보면서 버그를 잡는다”예요. 사람이 테스트 스크립트를 한 줄씩 짜는 대신, 에이전트가 화면을 보고 판단해서 직접 클릭하는 방식이죠.
기존 방식은 왜 그렇게 잘 깨질까?
Selenium, Cypress, Playwright 같은 전통적인 도구는 기본적으로 셀렉터를 기반으로 동작해요. 셀렉터는 화면에서 특정 요소를 찾아가는 ‘주소’ 같은 거예요. 예를 들어 Playwright에서는 page.click('#checkout-btn')처럼 “id가 checkout-btn인 버튼을 눌러라”라고 적어요. 문제는 이 주소가 바뀌는 순간 테스트가 버튼을 못 찾고 실패한다는 거예요. 기능은 멀쩡한데 테스트만 깨지는 거짓 실패가 쌓이면, 팀은 결국 테스트 결과를 믿지 않게 돼요.
Momentic 같은 AI 기반 도구는 접근 방식이 달라요. 테스트를 “장바구니 버튼을 누른다”, “주문 완료 메시지가 보여야 한다”처럼 자연어에 가깝게 적으면, AI가 지금 화면의 DOM 구조와 접근성 트리, 스크린샷을 함께 보고 해당 요소를 스스로 찾아가요. 접근성 트리는 스크린 리더가 읽어주는 화면 요소 목록이라고 생각하시면 돼요. 버튼 클래스명이 바뀌어도 사람 눈에 여전히 ‘장바구니 버튼’으로 보이면 AI도 찾을 수 있는 거죠. 이걸 흔히 셀프 힐링(self-healing)이라고 불러요.
이번 발표의 핵심은 여기서 한 발 더 나아간 ‘에이전트’예요. 정해진 시나리오만 따라가는 게 아니라, 에이전트가 화면을 관찰하고 → 다음 행동을 정하고 → 실행하는 루프를 돌면서 앱 곳곳을 돌아다니는 거예요. QA 엔지니어가 하는 탐색적 테스트, 그러니까 정해진 체크리스트 없이 이것저것 눌러보며 이상한 점을 찾는 테스트를 AI가 흉내 내는 셈이죠. 콘솔 에러가 뜨거나, 레이아웃이 깨지거나, 버튼을 눌러도 반응이 없는 상황을 사람 대신 찾아내는 게 목표예요.
물론 공짜 점심은 없어요
AI가 매번 화면을 해석하면 당연히 느리고 비싸요. LLM을 한 번 부르는 데 몇 초씩 걸릴 수 있으니까요. 그래서 이 분야 도구들은 AI가 한 번 찾아낸 경로를 캐시해두는 하이브리드 전략을 많이 써요. 다음 실행부터는 캐시된 경로로 빠르게 돌리고, 화면이 바뀌어서 실패할 때만 AI를 다시 부르는 식이에요.
비결정성도 따져봐야 해요. 같은 테스트를 돌려도 AI의 판단이 미묘하게 달라질 수 있거든요. 테스트의 존재 이유가 ‘믿을 수 있는 신호’인데 판정하는 쪽이 흔들리면 곤란하죠. AI가 버그를 놓치는 경우와 멀쩡한 걸 버그라고 우기는 오탐, 두 가지 모두 도입 전에 꼭 확인해야 해요.
비슷한 도구들과 비교해보면
이 시장은 지금 꽤 붐벼요. mabl이나 Testim처럼 일찍부터 AI 셀프 힐링을 내세운 SaaS가 있고, Applitools는 화면의 시각적 차이를 AI로 비교하는 데 특화돼 있어요. QA Wolf는 테스트 작성과 유지보수를 아예 서비스로 대신해주는 모델이고요. 오픈소스 쪽에는 Stagehand나 browser-use 같은 브라우저 에이전트 프레임워크가 있고, Playwright도 MCP 서버를 내놓으면서 LLM이 브라우저를 직접 조작할 수 있게 됐어요.
Momentic은 이런 브라우저 에이전트 기술을 ‘테스트’라는 목적에 맞춰 다듬었다는 점이 달라요. 범용 에이전트의 목적은 목표를 달성하는 거지만, 테스트 에이전트의 목적은 잘못된 걸 찾아내서 재현할 수 있게 보고하는 거니까요. 버그를 찾았을 때 재현 단계와 스크린샷을 얼마나 깔끔하게 남겨주느냐가 결국 실무에서의 가치를 결정할 거예요.
한국 개발자에게는 어떤 의미일까
한국 IT 회사에는 릴리스 직전에 QA팀이 수동 회귀 테스트를 몰아서 하는 문화가 아직 강하죠. QA 인력을 따로 두기 어려운 초기 스타트업이라면, 핵심 시나리오 몇 개만이라도 AI 에이전트에게 맡기는 게 꽤 현실적인 선택지가 될 수 있어요.
다만 한국 서비스에만 있는 장벽도 있어요. 휴대폰 본인인증, 카카오·네이버 소셜 로그인, PG사 결제창처럼 외부 팝업이나 보안 키패드가 끼어드는 흐름은 사람이 짠 스크립트로도 자동화하기 까다로워요. AI 에이전트라고 이걸 마법처럼 해결해주진 않으니, 이런 구간은 테스트 환경에서 목(mock)으로 대체하는 설계가 여전히 필요해요.
당장 해볼 만한 건, Playwright MCP에 LLM을 연결해서 로그인 → 핵심 기능 → 로그아웃 정도의 스모크 테스트를 에이전트에게 시켜보는 거예요. AI가 우리 앱 어디에서 헤매는지만 봐도 얻는 게 있어요. 그 지점이 사용자도 헷갈려하는 UX 문제일 가능성이 높거든요.
마무리
한 줄 정리: 테스트 코드를 ‘작성’하던 시대에서 에이전트에게 앱을 ‘써보게’ 하는 시대로 넘어가는 중이에요. 다만 속도, 비용, 신뢰성이라는 숙제는 아직 남아 있어요.
여러분 팀은 E2E 테스트를 어떻게 운영하고 계신가요? AI 에이전트가 판정한 테스트 결과를 배포 게이트로 믿고 쓸 수 있을지 의견이 궁금해요!
🔗 출처: Hacker News