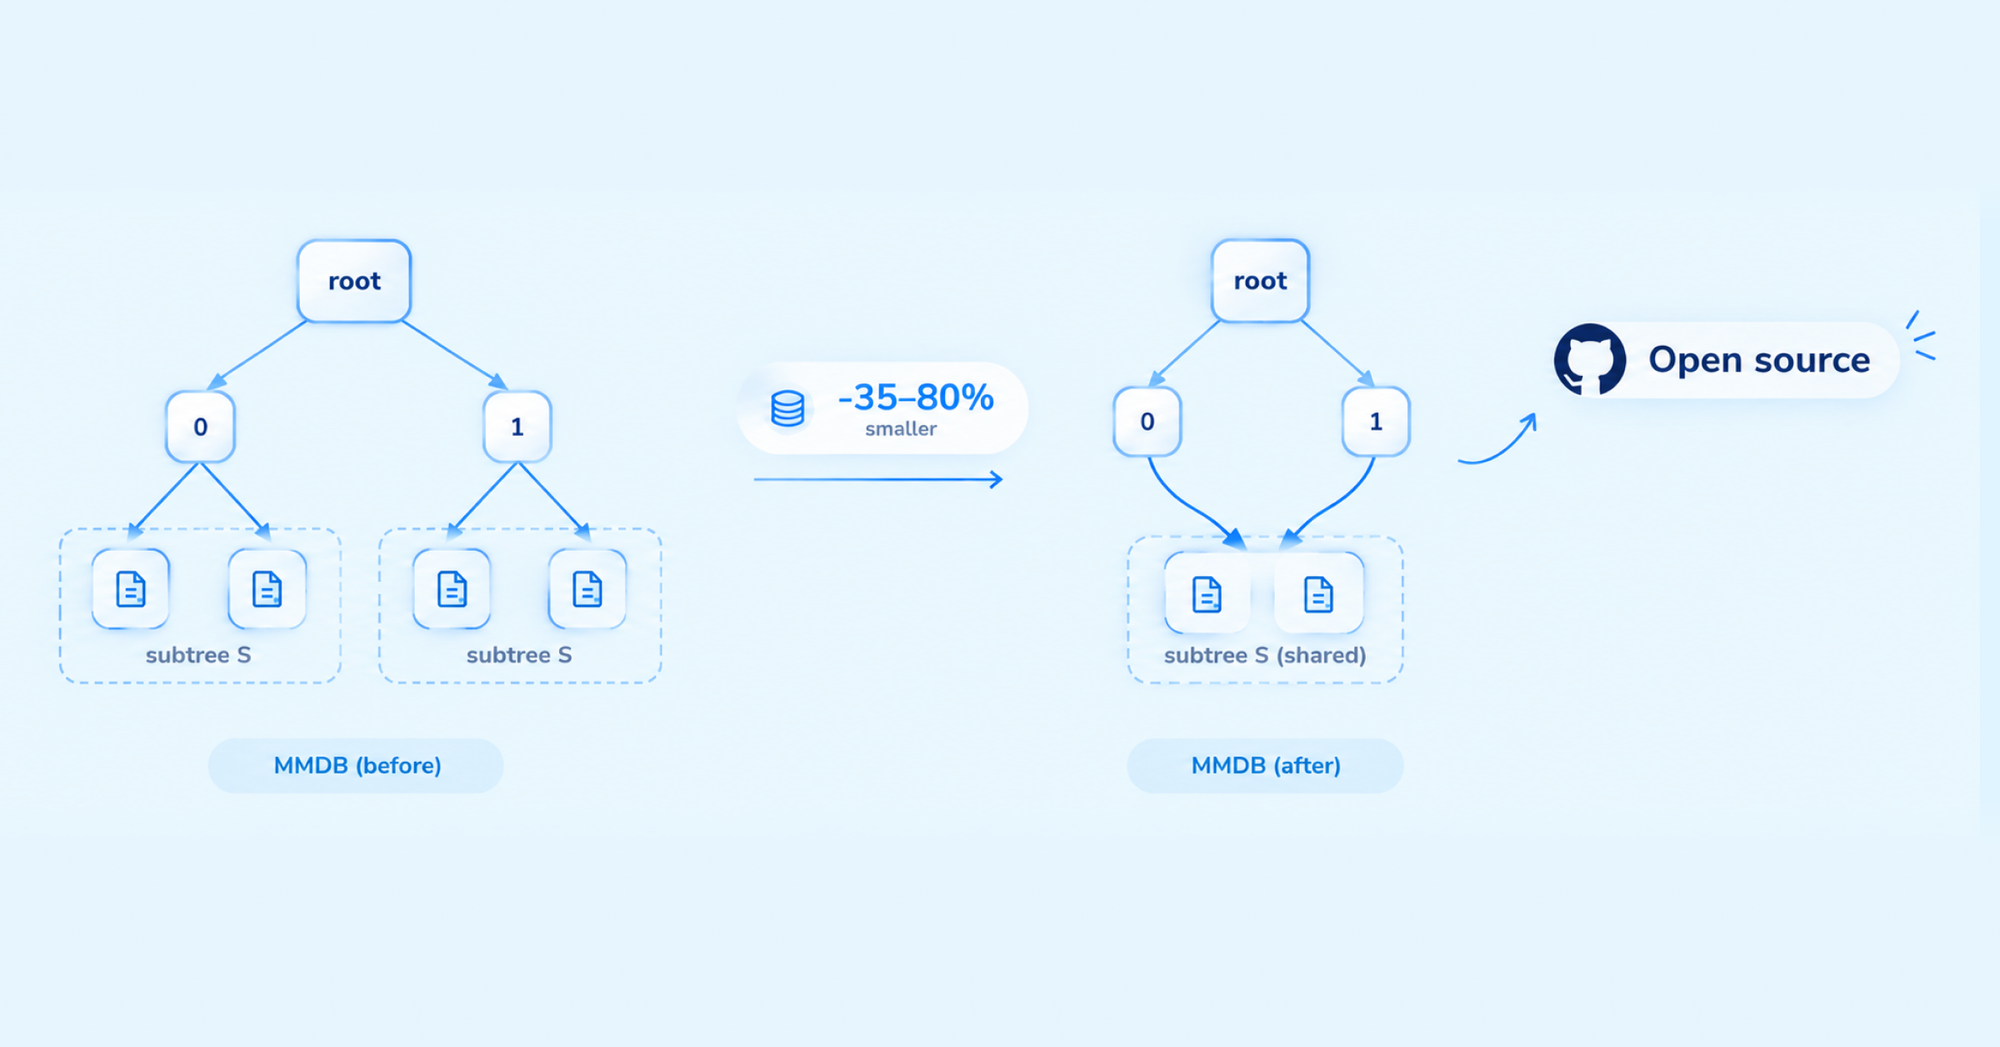
IP 주소를 국가·도시·ASN·익명화 여부 같은 메타데이터로 변환하는 작업은 보안·컴플라이언스·개인화 서비스의 기본 재료다. 이 데이터를 담는 대표적 포맷이 MaxMind가 설계한 MMDB로, 많은 리더 라이브러리가 이를 지원한다. IP 데이터 제공업체 IPinfo는 이 MMDB 포맷 자체에서 상당한 크기 절감 여지를 찾아냈고, 조회 결과는 그대로 유지한 채 파일을 최대 80%까지 줄였다. 이 작업을 수행하는 도구 mmdbshrink는 mmdbctl 업데이트와 별도 도구 형태로 Apache 2.0 라이선스 아래 오픈소스로 공개됐다.
숫자부터 보면 설득력이 분명하다. IPinfo가 매일 빌드하는 89개 데이터베이스 전체 용량은 91.2GB에서 62.8GB로 31% 줄었고, 가장 효과가 컸던 ipinfo_privacy 파일은 789MB에서 155MB로 80% 감소했다. 중요한 점은 여기에 어떤 압축도 쓰이지 않았다는 것이다. 압축 해제 단계도, 새로운 리더도, 새 포맷도 없다. 따라서 절감은 디스크 저장 시점뿐 아니라 네트워크 전송 시점과 메모리에서도 그대로 유효하다. MMDB는 메모리 맵 방식으로 읽히기 때문에 파일 크기가 곧 메모리 점유량이기 때문이다.
중복된 서브트리가 문제였다
MMDB 파일은 두 부분으로 구성된다. 하나는 IP 주소의 비트를 따라 0이면 왼쪽, 1이면 오른쪽으로 내려가다 리프에 도달하는 이진 트라이(검색 트리)이고, 다른 하나는 실제 레코드가 저장된 데이터 섹션이다. 포맷 설계자들은 데이터 섹션에는 공을 들였다. 포인터 타입이 있어 반복되는 레코드는 한 번만 기록하고 여러 리프에서 참조할 수 있으며, 널리 쓰이는 라이터들도 이 방식을 따른다. 실제로 ipinfo_lite 사례에서 데이터 섹션의 크기는 전혀 변하지 않았다.
문제는 검색 트리였다. 표준 라이터는 방문하는 모든 노드를 자식마다 하나씩, 두 개의 레코드로 그대로 써 내려갈 뿐 이미 동일한 노드를 기록했는지 확인하지 않는다. 주소 공간의 서로 다른 위치에 있는 두 /24 네트워크가 256개 주소 전부에 대해 같은 답을 낸다면, 그 아래 서브트리는 모양도 리프도 데이터 포인터도 비트 단위로 동일하다. 그런데도 표준 라이터는 둘 다 저장한다. 프라이버시 데이터베이스가 수백만 범위에 소수의 판정을 적용하거나, 위치 데이터베이스가 수십만 개의 도시 레코드를 수백만 프리픽스에 흩뿌리는 구조에서 이런 중복 서브트리는 트리의 상당 부분을 차지했다.
컴파일러 기법을 트라이에 적용하다
해법은 해시 컨싱(hash-consing)이다. 컴파일러와 기호 계산 분야에서 오래 쓰인 기법으로, Filliâtre와 Conchon의 2006년 논문과 Bryant의 1986년 이진 결정 다이어그램(BDD)에서의 서브그래프 공유와 맞닿아 있다. 핵심은 단순하다. 이미 만든 노드를 해시 테이블에 보관해두고, 새로 만들려는 노드가 구조적으로 동일하면 기존 노드를 재사용한다. 트라이에 상향식으로 적용하면 같은 자식 쌍을 가진 노드가 공유되어, 여러 부모가 하나의 서브트리를 가리키는 방향성 비순환 그래프(DAG)가 된다. 각 IP의 분기 결정 순서는 그대로 보존되므로 조회 결과는 바뀌지 않는다.
이 방식은 MMDB 포맷을 전혀 수정하지 않는다. 각 노드의 두 레코드는 다른 노드나 데이터 레코드, 빈 결과를 가리킬 수 있고, 여러 부모가 한 노드를 참조하는 공유는 IPv4 별칭(alias)을 위해 이미 포맷 명세에 기술돼 있다. IPinfo는 이 절감을 처음으로 찾아내 제품화했다고 밝혔다. 지난해 한 WhatsApp 취약점 연구에서 방대한 전화번호 집합을 위해 비슷한 발상의 자체 구조를 만든 사례가 있지만, IPinfo의 결과물은 여전히 유효한 MMDB라는 점이 다르다.
성능도 손해가 없다. ipinfo_lite 벤치마크에서 100만 건 조회는 원본의 797ns에서 최적화본 757ns로 오히려 빨라졌고, 상주 메모리는 36.02MiB에서 23.92MiB로 줄었다. 트리 바이트가 줄면 페이지 폴트도 줄기 때문이다. 이 사례에서 전체 노드의 41%가 이미 기록된 노드의 중복으로 드러났다.
실무자가 봐야 할 지점
IPinfo는 최적화 파일을 고객에게 내보내기 전 네 가지 방식으로 검증했다고 설명한다. 단 한 건의 조회라도 결과가 달라지면 크기 절감은 무의미하기 때문이다. 최초 투입은 2GB 플랫폼 한도를 넘긴 한 고객 맞춤 데이터셋에서 시작해 자사 API로 확대됐고, 현재는 API 트래픽과 데이터베이스 다운로드 100%가 기존과 동일한 파일명으로 최적화본을 제공한다. IPinfo 고객이라면 따로 할 일은 없다는 뜻이다.
정리하면, 이 중복은 특정 파일의 문제가 아니라 MMDB 라이터들의 공통된 성질이다. MMDB 파일을 직접 빌드해 배포하는 조직이라면 같은 트리 비대화를 겪고 있을 가능성이 높고, mmdbshrink를 자신들의 파일에 그대로 돌려볼 수 있다. 반대로 MMDB를 읽기만 하는 쪽은 리더를 바꿀 필요가 전혀 없다. IPinfo가 "파일을 어떻게 포장하느냐는 우리의 경쟁력이 아니다"라며 도구를 공개한 이유도 여기에 있다. 설치는 go install로 가능하며 사용법은 대상 파일을 인자로 넘기는 것만큼 단순하다. 압축이라는 익숙한 수단 대신 자료구조의 중복 자체를 제거해 저장·전송·메모리 세 측면을 동시에 개선한, 실무적으로 참고할 만한 접근이다.