몇 년 전만 해도 AI가 만든 이미지를 알아보는 가장 쉬운 방법은 손가락 개수를 세거나 배경 간판의 글자를 읽어보는 것이었다. 두 문제 모두 지금은 대부분 해결됐는데, 왜 그런 결함이 생겼는지를 들여다보면 이 모델들이 어떻게 작동하는지가 드러난다. 개발자 대니얼 볼(Daniel Ball)이 직접 여러 이미지 생성 API를 파이썬으로 호출해 픽셀아트 스프라이트, 카드 게임용 테이블 배경, 식당 포스터 등을 만들어 본 경험을 정리한 글은, 마케팅 문구보다 실제로 무엇을 얻게 되는지에 초점을 맞춘다.
손 문제는 손이 복잡하고 유연한 데다 사진 속에서 컵 뒤나 주머니 속처럼 일부만 보이는 경우가 많기 때문이었다. 모델은 손을 '손가락 몇 개짜리 구조물'이 아니라 하나의 질감으로 학습했다. 2023년 3월 미드저니 v5가 전환점으로 널리 거론됐고, 전문가들은 손을 선명하게 담은 잘 정제된 학습 데이터와 더 큰 모델, 더 높은 해상도가 원인이라고 추측했다. 다만 완벽하진 않아서, 한동안 배경 인물의 손은 여전히 기괴했다.
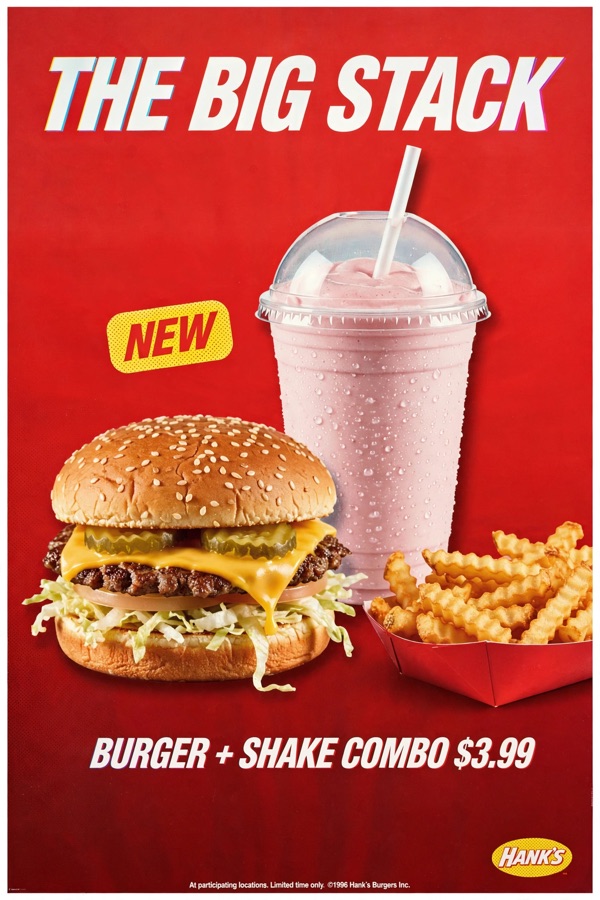
글자 문제의 원인은 더 구체적이다. 대부분의 모델은 프롬프트를 글자 단위가 아니라 단어 덩어리로 쪼개는 토크나이저로 읽는다. 모델은 'chocolate'이 c-h-o-c-o-l-a-t-e로 쓰인다는 사실 자체를 보지 못하므로 한 글자씩 그릴 수 없다. 2022년 논문 'Character-Aware Models Improve Visual Text Rendering'은 개별 문자에 접근할 수 있게 하면 문제가 상당히 해결된다는 점을 보였다. 구글 이미젠 출신 연구자가 포함된 Ideogram은 2023년 텍스트 렌더링을 강점으로 내세웠고, 2025년에 이르러 OpenAI와 구글의 멀티모달 모델이 읽을 수 있는 글자를 보편화했다. 그래도 긴 문장은 여전히 완전히 풀리지 않았다. 2024년 2월 글래스고의 '윌리 초콜릿 익스피리언스'는 AI 포스터에 'a pasadise of sweet teats' 같은 오타를 내걸었고, 2025년 12월 Nano Banana Pro는 멀쩡한 인포그래픽에서 'Lived experience'를 'Liver experience'로 바꿔놓았다.
디퓨전과 멀티모달의 경계
수학을 몰라도 모델은 잘 쓸 수 있지만, 작동 방식의 대략적인 그림은 알아둘 가치가 있다. 대부분의 이미지 모델은 디퓨전 방식이다. 학습 때는 깨끗한 사진에 노이즈를 조금씩 더해 원래 모습을 예측하도록 가르치고, 생성 때는 이를 거꾸로 돌려 순수한 잡음에서 출발해 여러 단계에 걸쳐 노이즈를 조금씩 걷어낸다. 텍스트 인코더가 프롬프트를 숫자로 바꿔 각 단계를 원하는 이미지 쪽으로 유도한다.
더 새로운 방식은 언어까지 이해하는 모델 안에 이미지 생성을 넣는 것이다. 같은 모델이 프롬프트를 읽고 그림을 그리기 때문에 지시를 훨씬 잘 따르고, 글자를 제대로 쓰며, 사용자가 준 이미지를 편집하는 데 강하다. GPT Image, 제미나이 이미지 모델, 메타의 Muse가 이런 방식이다. 일부는 그리기 전에 배치를 먼저 추론하는데, 무엇을 어디에 둘지가 중요한 프롬프트에서 차이가 뚜렷하다. 실제로 저자가 '바로 위에서 내려다본 식탁'을 요청했을 때, Flux는 소품을 온전한 형태로 모서리에 몰아넣은 반면 배치를 먼저 설계하는 Muse는 각 변에 하나씩 잘라 배치하고 가운데를 비워 카드 놓을 공간을 남겼다. 결국 중요한 구분은 수학이 아니라 모델이 언어를 얼마나 깊이 이해하느냐다.
과금 모델과 가격의 함정
ChatGPT의 이미지 기능은 2025년 3월부터 OpenAI 자체 GPT Image 모델을 쓴다. DALL-E 3는 2023년 10월부터 그때까지 ChatGPT의 생성기였고, OpenAI는 2026년 5월 12일 DALL-E 2·3을 API에서 제거했다. 같은 모델군은 API로도 이미지당 과금으로 쓸 수 있는데, 정해진 크기 목록·품질 등급·코드 일괄 생성, 일부 모델의 투명 배경 등을 제공한다. 몇 장 이상, 혹은 같은 유형을 반복 생성해야 한다면 앱이 아니라 API가 맞다. 출처 표시로 OpenAI는 C2PA 메타데이터와 SynthID 워터마크를, 구글은 제미나이 이미지에 SynthID를 넣지만, 메타데이터는 쉽게 지워지고 워터마크도 증명 수단으로 의존하기엔 부족하다.
저자가 제시하는 유용한 비유는 '큰 캔버스만 가진 화가'다. 캔버스 단위로 돈을 받고 구석구석 똑같은 정성을 들이므로, 평평한 파란 하늘도 얼굴만큼 공을 들인다. 최신 플래그십 모델은 장당 가격이 더 비싸고, 저가 영역은 오픈웨이트 모델과 'flash·mini·lite' 등급이다. 다만 장당 가격만 보는 것은 오해를 부른다. 열 번 시도해야 하는 공짜 로컬 모델은 한 번에 맞히는 0.039달러짜리 모델에 질 수 있다. 저자의 실험에서는 0.1센트 더 비싼 모델이 여러 번의 재시도를 아꼈다.
창의는 모델에, 구조는 코드에
픽셀아트는 가장 쉬워 보이지만 오히려 AI 이미지 생성의 한계를 잘 보여준다. 제미나이 2.5 Flash Image로 그린 기사 스프라이트는 7.5초, 약 0.039달러가 들었고 깔끔하지만, 실제로는 1024×1024 그림일 뿐 스프라이트가 아니다. '픽셀'의 크기가 들쭉날쭉하고 격자에 맞지 않으며 실제 팔레트보다 훨씬 많은 색을 쓰고, '단색' 마젠타 배경조차 미묘하게 변하는 분홍이었다. 쓸 만하게 만들려면 배경 제거, 최근접 이웃 다운스케일로 격자 맞추기, 팔레트 축소를 결국 일반 코드로 해야 했다.
여러 스프라이트를 한 이미지에 요청하는 전략은 서로 다른 객체 묶음에는 훌륭히 통했다. 판타지 인벤토리 아이콘 100개를 요청해 0.039달러 한 번 호출로 156개, 그중 약 140개가 서로 다른 아이콘을 얻었으니 개당 약 0.00025달러다. 반면 한 캐릭터의 여러 포즈에는 금세 무너져, 10×10 격자 요청은 같은 기사를 120번 찍어냈다. 게임 개발에 특화된 PixelLab이나 Retro Diffusion, Pixel Art XL 같은 애드온이 더 나은 경로다. 여기서 끌어낼 일반 교훈은 분명하다. AI는 '이것이 어떻게 보여야 하는가'에는 강하고 '정확히 이것을 정확히 이 칸에 넣어라'에는 약하다. 출력이 단순해 보이는지가 아니라 어려운 부분이 창의적인지 구조적인지가 관건이며, 창의는 모델에, 구조는 코드에 맡기는 것이 요령이다. 그리고 공급자마다 API가 제각각이므로 하나의 함수 뒤에 감춰 설정 변경만으로 공급자를 바꿀 수 있게 하라는 조언으로 글은 마무리된다.