러스트의 비동기 런타임 Tokio 위에서 성능 좋은 코드를 짜는 데에는 확고한 규칙이 거의 없다. 어떤 워크로드의 성능은 그 순간 런타임에서 함께 돌아가는 다른 작업에 따라 달라지기 때문이다. 최근 RustConf의 언컨퍼런스에서 비동기 애플리케이션의 디버깅과 벤치마킹을 놓고 오간 논의를 정리한 이 글은, 성능 문제가 유독 프로덕션에서만 드러나는 이유를 여기서 찾는다. 결국 비동기 애플리케이션을 빠르게 만드는 일은 공정성(fairness)과 배칭(batching), 경합(contention)과 격리(isolation) 사이의 저울질이라는 것이다.
먼저 짚어둘 전제가 있다. Tokio 애플리케이션에서 '위험 신호'를 찾기 시작하면 거의 반드시 찾게 된다. Alice Ryhl이 권장한 폴(poll) 구간 10~100마이크로초를 훌쩍 넘기는 긴 폴은 흔하지만, 그것이 실제로 신경 쓰는 지표나 동작에 영향을 주는지는 별개 문제다. 긴 폴이 완전히 무해한 경우도 있고, 그것을 '고친다'고 사용자 체감 지표가 개선되지 않을 수도 있다. 그래서 실제로 개선하려는 지표에서 거꾸로 출발하는 태도가 중요하다. 글쓴이의 경험상 문제의 압도적 다수는 Tokio가 아니라 애플리케이션 코드, 특히 분산 시스템 여러 구성 요소 간의 상호작용에 있었다. Tokio 지표 중 가장 유용한 것은 최근 추가된 스케줄 지연 히스토그램으로, 태스크가 실행 준비를 마친 시점과 Tokio가 실제로 폴하는 시점 사이의 시간을 보여준다. 원인을 직접 알려주진 않지만, 나쁜 상호작용의 가장 흔한 증상이다.
공정성은 공짜가 아니다
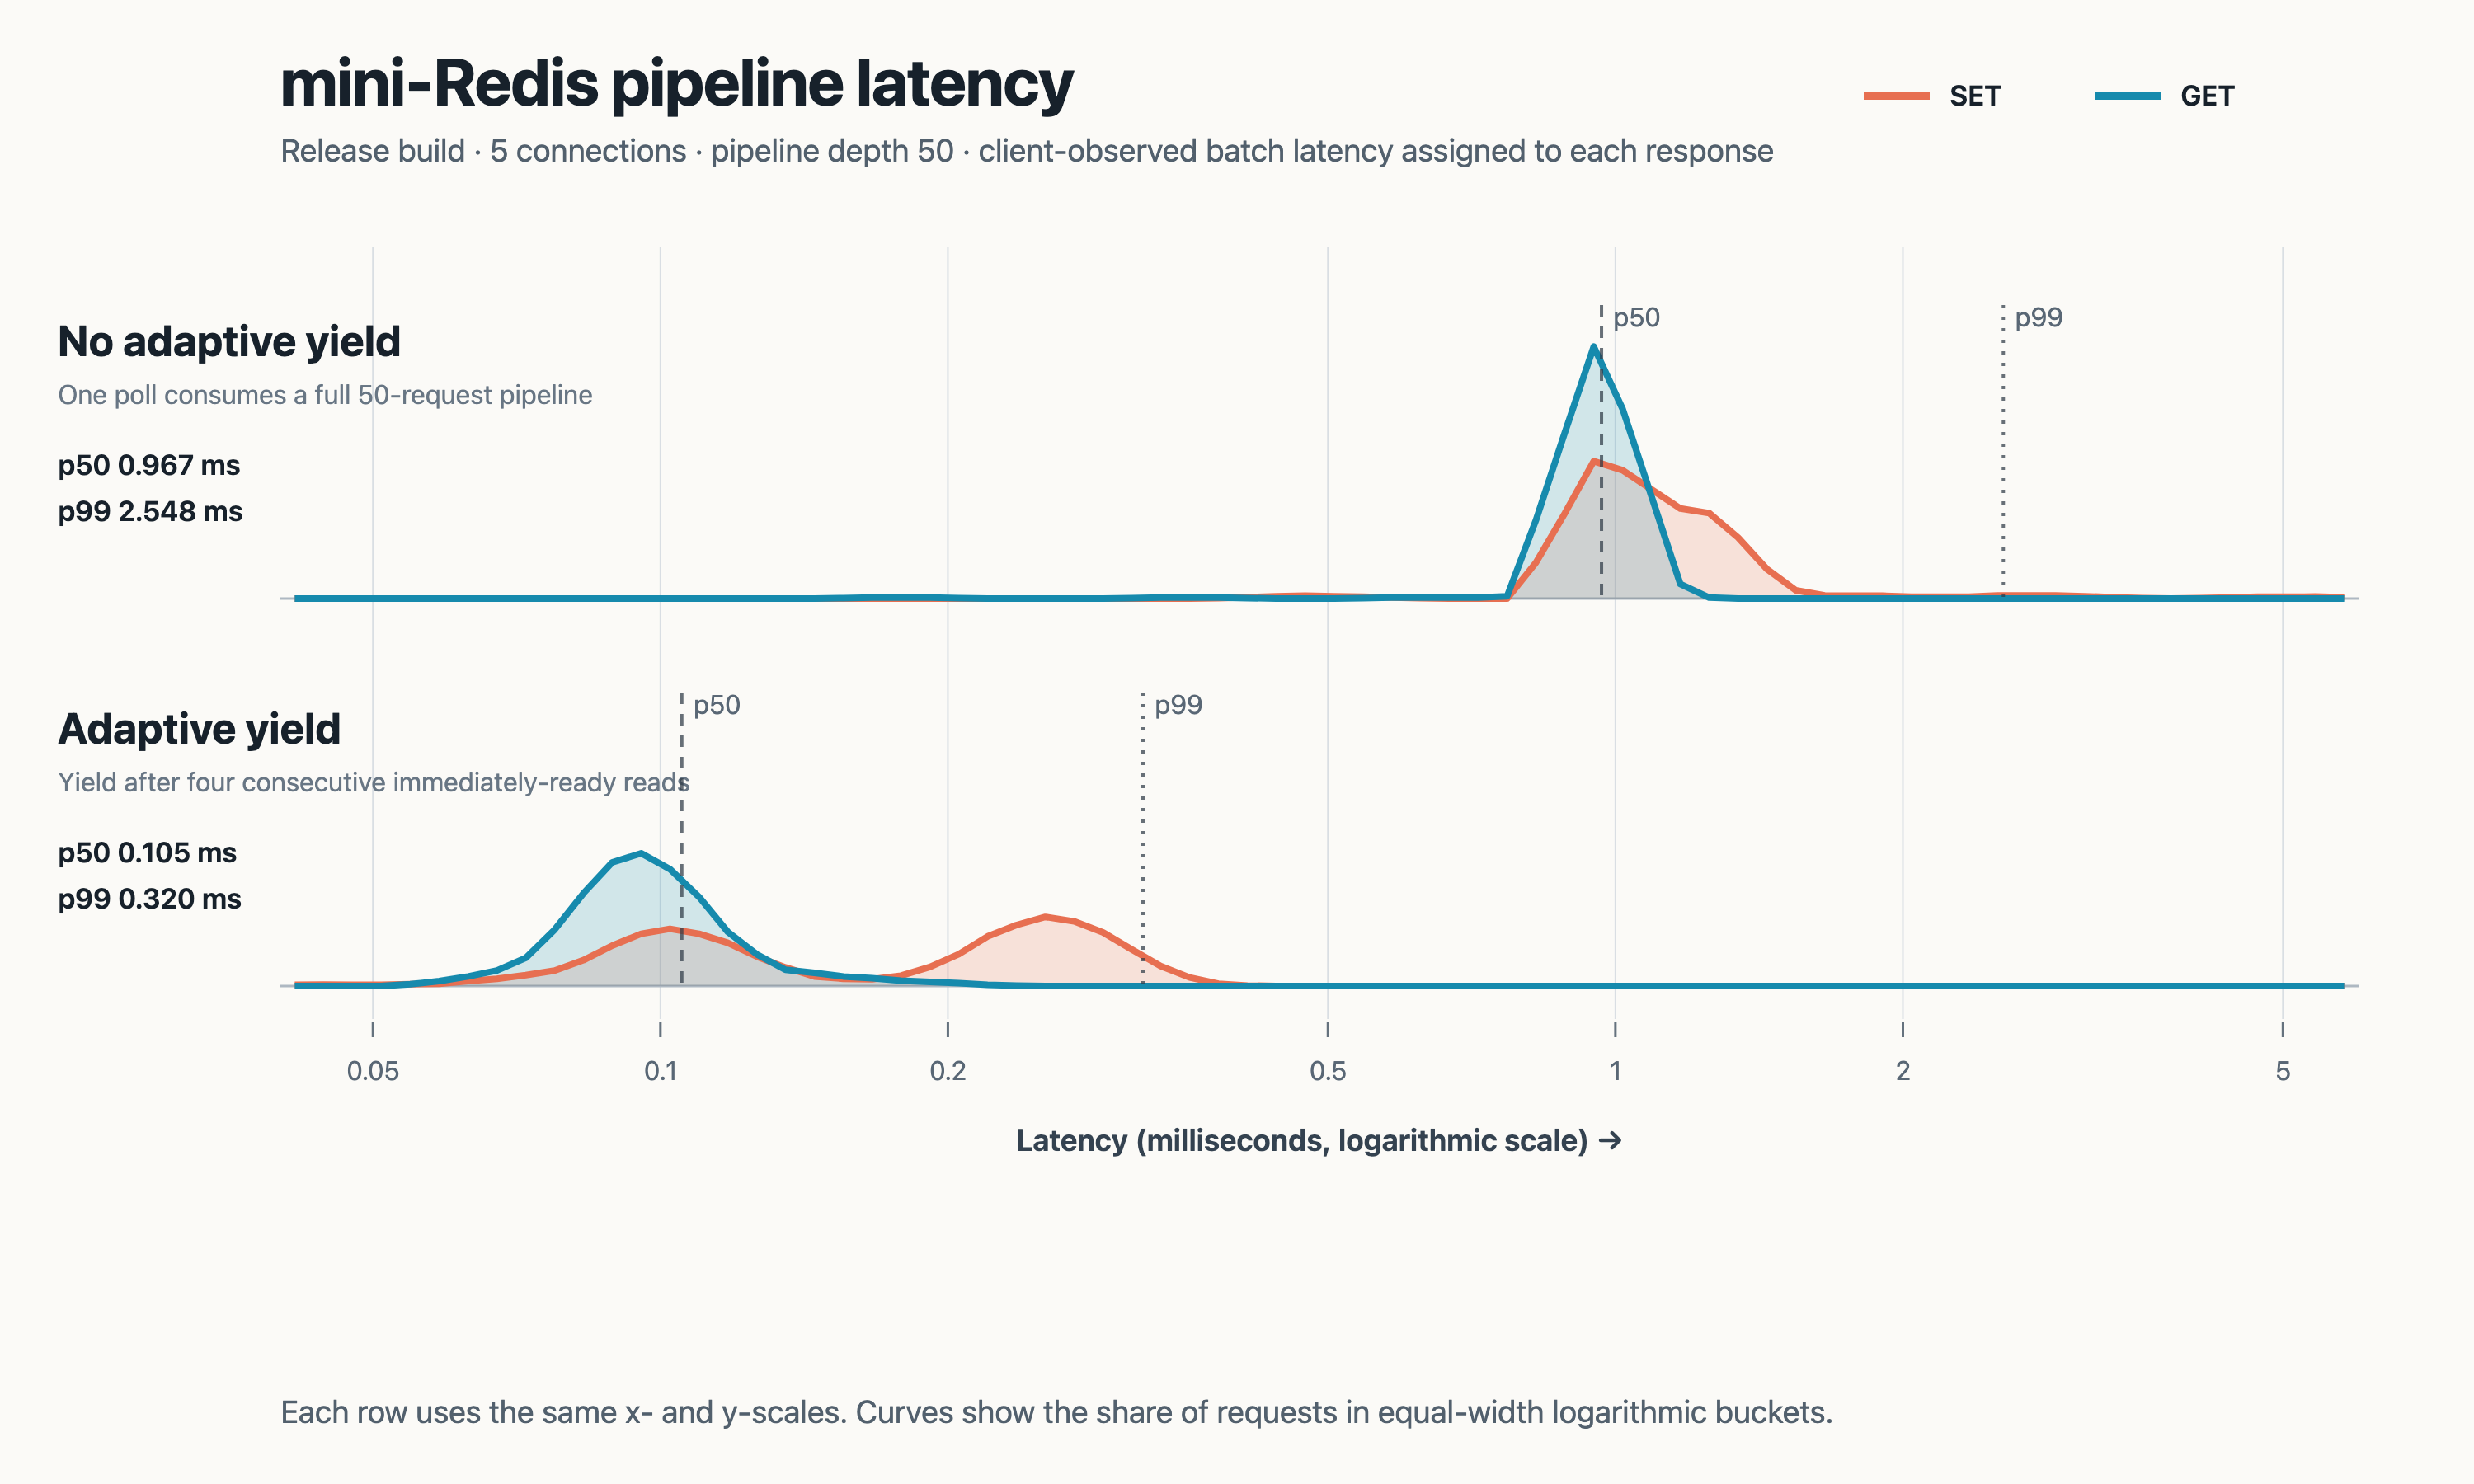
낮은 지연을 여러 요청에 걸쳐 유지하려면 연결 간 공정성이 필요하다. 요청 파이프라이닝을 지원하는 Redis 같은 애플리케이션을 보자. 소켓에 데이터가 있는 동안 계속 읽어 들이는 순진한 구현은, 파이프라인된 요청 전체가 메모리 버퍼에 들어와 각 프레임이 네트워크로 돌아가지 않고 곧바로 Poll::Ready가 된다. 이는 긴 폴과 클라이언트 간 불공정을 동시에 만든다. 처리량 자체는 크게 변하지 않지만 지연은 극적으로 나빠진다. 한 파이프라인 전체가 다른 파이프라인 뒤에 줄을 서기 때문이다. 요청마다 명시적으로 양보(yield)하면 이 예에서 지연을 약 10배 줄일 수 있고, 연속으로 즉시 준비된 읽기가 네 번 이어진 뒤에만 양보하면 배칭을 완전히 포기하지 않으면서도 훨씬 공정해진다.
그러나 공정성에는 대가가 따른다. 태스크 전환, 폴, 워커 이동, 스레드 전환 같은 런타임 이벤트 하나당 더 많은 유의미한 작업을 처리할수록 애플리케이션은 효율적이다. 대표적 사례가 tokio::fs다. io_uring이 없으면 Tokio는 모든 파일시스템 연산을 블로킹 풀에서 돌리는데, spawn_blocking 호출 자체에 비용이 있고 블로킹 풀은 런타임 전체가 공유한다. 연속된 파일시스템 작업이 예상된다면 가능한 한 큰 블로킹 구간으로 묶는 것이 좋고, 때로는 전용 OS 스레드가 더 낫다. 태스크 생성처럼 값싼 연산조차 공짜가 아니다. 10마이크로초짜리 작업을 별도 태스크로 스폰하는 것은 오히려 역효과다.
워커를 멈추게 하는 것들
런타임 전체를 가장 쉽게 마비시키는 방법 하나는 경합 중인 블로킹 뮤텍스에서 워커를 대기시키는 것이다. 뮤텍스 뒤에 놓인 메트릭 레지스트리가 대표적이다. 플러시가 값비싼 작업을 하며 락을 쥐고 있으면, 모든 워커가 결국 메트릭을 기록하려다 같은 락에 걸려 멈추고 작업 훔치기(work stealing)조차 불가능해진다. 그래서 비동기 애플리케이션의 임계 구역은 해시맵 갱신 한 번처럼 극단적으로 짧게 유지해야 한다. RWLock은 읽기 경로에서도 원자적 연산 경합을 만들어 대개 정답이 아니며, 락을 쥔 채 플러시하거나 I/O를 하거나 다른 퓨처를 await해서는 안 된다. tokio::sync::Mutex는 락 비용이 훨씬 크고 FutureLock 같은 미묘한 문제에 취약해, 임계 구역이 수 밀리초에 이를 때만 적절하다. 한편 Tokio는 시스템이 감당할 수 있는 것보다 훨씬 많은 태스크를 스폰할 수 있어, S3에 3,000개 연결이 무제한으로 팬아웃되는 사고도 흔하다. 해법은 지루하지만 Semaphore 같은 것으로 동시성을 제한하는 것이다.
코어를 나누는 격리 전략
Tokio는 워커가 빠르게 깨어난다는 전제에 기댄다. 그러나 OS 부하가 높으면 커널이 워커를 스케줄하기까지 10~20밀리초 이상 걸릴 수 있다. P99 지연을 한 자릿수 밀리초로 재는 서비스라면 재앙이다. 글쓴이는 아마존에서 자바에서 러스트로 점진 이관하며 같은 호스트에 두 프로세스를 올렸을 때, 자바 프로세스가 일을 덜 할수록 러스트 프로세스가 더 많은 일을 하면서도 빨라지는 현상을 관찰했다. tracing_appender의 백그라운드 스레드처럼 100밀리초 넘게 CPU를 양보하지 않는 다른 러스트 스레드도 같은 문제를 만든다. 기본 해법은 cgroups 등으로 Tokio 워커와 다른 코드를 별도 코어에 고정하는 것이다. 모든 코어를 Tokio에 줄 필요는 거의 없고, 비핵심 작업용 코어를 떼어두면 지연이 개선되는 경향이 있다.
더 강한 격리는 지연에 민감한 작업과 낮은 우선순위의 백그라운드 작업을 서로 다른 런타임에 배정하고 각 런타임을 전용 코어에 고정하는 것이다. TokioConf에서도 대부분의 발표가 최소 두 개의 런타임 구성으로 귀결됐다는 인상이 지배적이었다. 마이크로초 단위 지연을 쫓는 극단적 상황에서는 양보 대신 50마이크로초쯤 의도적으로 스핀(spin)하는 방법도 있지만, 코어를 소모하고 이웃 워크로드를 해치므로 대부분의 애플리케이션에는 부적절하다. 참고로 Tokio 1.52.0은 샤딩된 블로킹 큐를 잠깐 실었다가 spawn_blocking이 멈추는 회귀 때문에 1.52.1에서 되돌렸고, 이후 PR #8337에서 기본 비활성화된 unstable 기능으로 다시 도입됐다.
실무자가 얻을 교훈은 명확하다. 긴 폴이나 spawn_blocking 같은 신호를 무작정 '고치기'보다, 실제 지표에서 출발해 그 신호가 지연이나 처리량에 정말 영향을 주는지 먼저 확인하라는 것이다. 다만 여기 정리된 원칙들 대부분은 '경우에 따라 다르다'는 단서를 달고 있고, in-task 동시성을 쓰는 tokio::join!·tokio::select! 안에서는 작업 훔치기가 일어나지 않아 조언이 뒤집힌다는 점도 유의해야 한다. 결국 이 글은 규칙집이라기보다, 자신의 워크로드를 현미경처럼 들여다보며 균형점을 찾으라는 관찰 지침에 가깝다.