도입
새 모델이 나왔다는 소식을 들으면 우리는 자연스럽게 '최신'이라고 생각해요. 그런데 모델 이름이 새것이라고 해서 그 모델이 아는 세상까지 새것은 아니거든요. 모델은 특정 시점까지의 데이터로 학습을 마치고, 그 뒤로 몇 달을 거쳐 세상에 나와요. 그리고 출시된 뒤로도 한참 동안 쓰이죠. 그러니까 지금 여러분이 쓰는 모델은 어쩌면 1년 전 세상을 기준으로 답하고 있을 수 있어요.
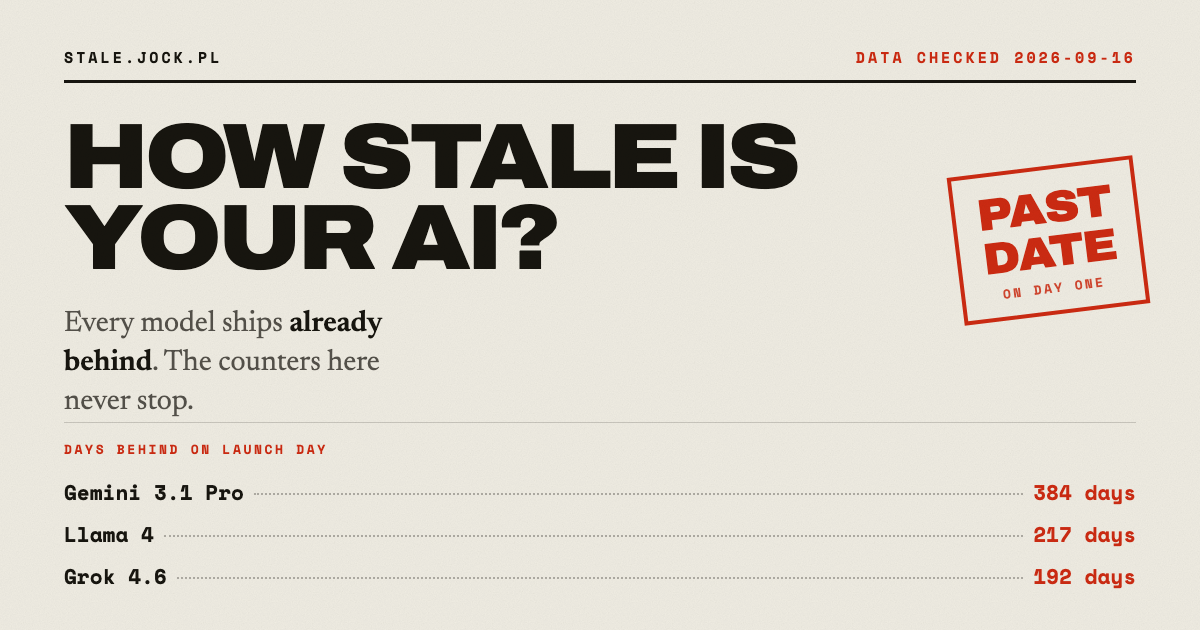
한 개발자가 이 문제를 눈에 보이게 만들었어요. 주요 AI 모델 20개의 출시일과 학습 기준일을 모아서, 오늘 기준으로 각 모델의 지식이 얼마나 '묵은' 상태인지 한눈에 보여주는 사이트를 만든 거예요. 단순한 표 하나인데, 보고 나면 모델을 고르는 눈이 조금 달라져요.
학습 기준일이 뭐냐면
학습 기준일, 영어로 training cutoff는 모델이 학습한 데이터가 어느 시점까지의 것인지를 말해요. 예를 들어 기준일이 어느 해 3월이라면 그 뒤에 나온 뉴스, 라이브러리 릴리스, 프레임워크 변경 사항은 모델이 원칙적으로 몰라요. 사람으로 치면 긴 항해를 떠났다가 돌아온 선원 같은 거예요. 똑똑하긴 한데 떠난 뒤에 일어난 일은 못 들은 상태죠.
그럼 왜 출시일과 기준일 사이에 몇 달씩 차이가 날까요? 대규모 사전학습이 끝난 뒤에도 할 일이 많아요. 사람이 원하는 방식으로 답하게 다듬는 후처리 학습, 안전성 평가, 성능 검증, 배포 인프라 준비 같은 단계를 거치거든요. 이 과정이 짧아야 몇 달, 길면 반년을 훌쩍 넘겨요. 그래서 출시 당일에도 이미 지식은 몇 달 뒤처져 있어요.
여기서 끝이 아니에요. 출시 후 시간이 갈수록 격차는 계속 벌어져요. 사이트가 보여주는 건 바로 이 부분이에요. 출시일 기준이 아니라 오늘 기준으로 계산하니까, 작년에 나온 모델은 이미 1년 넘게 '정지된 세상'을 기준으로 답하고 있다는 게 숫자로 드러나요.
사이트가 보여주는 것
구성은 간단해요. 모델마다 출시일, 학습 기준일, 그리고 기준일부터 오늘까지 지난 날짜를 나란히 보여줘요. 두 가지 간격을 같이 볼 수 있다는 게 포인트예요. 하나는 기준일과 출시일 사이의 간격, 즉 '태어날 때부터 얼마나 뒤처져 있었나'이고, 다른 하나는 기준일부터 오늘까지의 간격, 즉 '지금 얼마나 묵었나'예요.
이렇게 나란히 놓고 보면 재미있는 패턴이 보여요. 이름은 최신인데 기준일은 꽤 오래된 모델들이 있어요. 같은 기반 모델 위에서 후처리만 달리한 버전들은 기준일이 같은 경우가 많거든요. 반대로 출시 직전까지 데이터를 넣어서 격차가 짧은 모델도 있고요. 벤더가 기준일을 명확히 공개하지 않거나 모델 카드에 두루뭉술하게 적어두는 경우가 많아서, 이렇게 한 곳에 모아놓은 것 자체가 꽤 쓸모 있어요.
실무에서 어떤 문제가 생기나
가장 흔한 사례는 코딩이에요. 모델에게 어떤 라이브러리 사용법을 물었더니 이미 폐기된 API를 자신 있게 알려주는 경우예요. 기준일 이후에 메이저 버전이 바뀌었으면 모델은 옛 버전밖에 몰라요. 새로 나온 프레임워크나 도구는 아예 존재조차 모르고, 비슷한 이름의 다른 것을 지어내기도 해요. 모르면 모른다고 하면 좋을 텐데, 모델은 아는 척하는 데 능하거든요.
더 미묘한 문제도 있어요. 모델이 자기 기준일을 정확히 모르는 경우가 꽤 있어요. 물어보면 실제보다 이른 날짜를 답하기도 하죠. 기준일 직전 몇 달은 인터넷에 관련 글이 아직 충분히 쌓이지 않은 시기라 그 기간 지식이 유난히 흐릿한 경향도 있어요. 그러니 '기준일 이전이면 다 안다'고 믿으면 안 돼요.
그래서 어떻게 대응하나
방법은 결국 '모델 바깥에서 최신 정보를 넣어주는 것'이에요.
첫째, 검색 증강 생성, 즉 RAG예요. 질문할 때 관련 문서를 찾아서 같이 넣어주는 방식이에요. 모델의 기억에 의존하지 않고 최신 문서를 읽고 답하게 하는 거죠. 둘째, 웹 검색이나 도구 호출이에요. 요즘 모델들은 필요하면 검색하고 결과를 읽어요. 셋째, 프롬프트에 직접 맥락을 넣는 거예요. 오늘 날짜, 쓰는 라이브러리 버전, 공식 문서 본문을 시스템 프롬프트에 명시하면 오답이 확 줄어요. 코딩 도구라면 최신 문서를 컨텍스트로 넣어주는 MCP 서버나 llms.txt 같은 방식도 활용할 만해요.
한국 개발자에게 주는 시사점
팀에서 AI 도구를 도입할 때 '어떤 모델을 쓰나'만큼 '그 모델의 기준일이 언제고 우리 스택은 언제 바뀌었나'를 같이 확인해보세요. 특히 최근에 큰 버전 변화가 있었던 프레임워크는 모델이 옛 방식을 알려줄 가능성이 높아요. 그리고 모델 답변에 '이 정보는 기준일 이후 바뀌었을 수 있다'는 의심을 습관처럼 붙이는 게 좋아요. 이 사이트를 북마크해두고 모델 고를 때 한 번씩 들여다보는 것만으로도 꽤 도움이 돼요.
마무리
한 줄로 정리하면, 모델의 똑똑함과 모델의 최신성은 별개라는 거예요. 여러분은 AI가 옛날 정보를 자신 있게 말해서 낭패 본 경험이 있나요? 그리고 그걸 어떻게 잡아냈나요?
🔗 출처: Hacker News