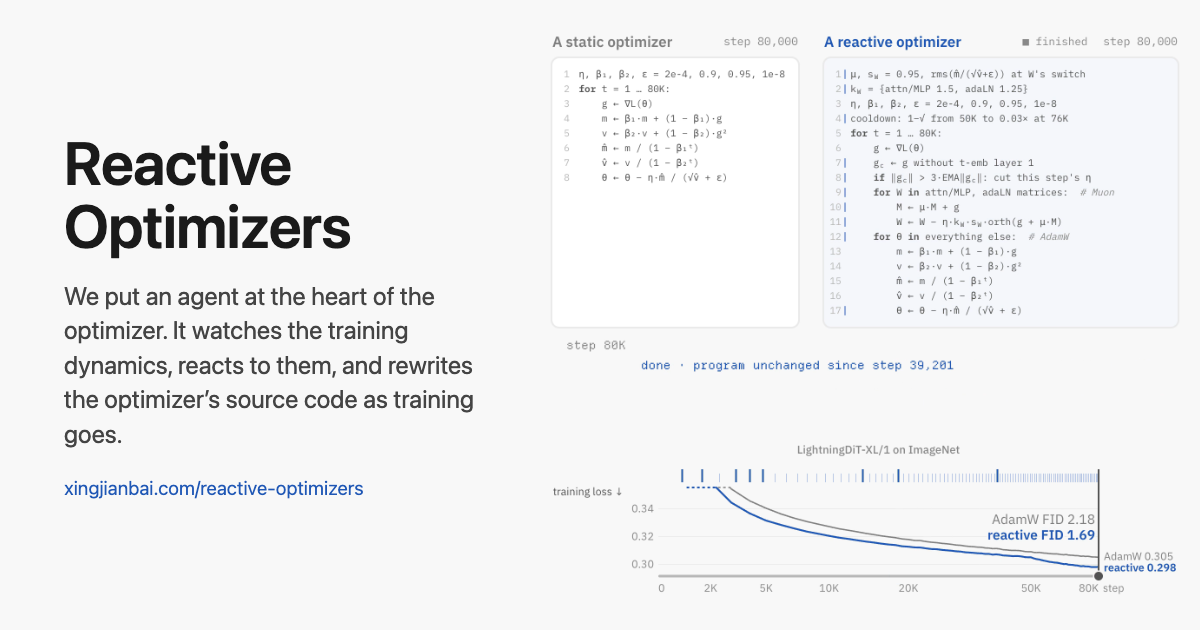
딥러닝 모델을 학습시킬 때 쓰는 최적화 레시피는 보통 훈련이 시작되기도 전에 완전히 결정된다. 적응형 스텝 크기, 프리컨디셔닝, 직교화된 업데이트, 학습 스텝에 연동된 스케줄, 모델 크기에 맞춘 학습률 등 수많은 사람의 통찰이 이 사전 설계에 녹아 있다. 자동 탐색 기법들도 여러 번의 실험을 가로질러 더 나은 옵티마이저를 찾아낸다. 그러나 손으로 짰든 자동으로 발견했든, 일단 정해진 옵티마이저는 훈련이 끝날 때까지 미리 적어둔 규칙대로만 움직인다. 예기치 못한 손실 급등이나 정체가 생기면 어떻게 대응해야 하는가, 한 모듈의 기울기만 진동하기 시작하면 무엇을 해야 하는가 같은 질문은 이 틀 안에서 답을 얻지 못한다.
반응형 옵티마이저는 이 범위를 넓혀 옵티마이저가 훈련 그 자체에 반응하도록 만들려는 시도다. 핵심은 옵티마이저 한가운데에 에이전트를 놓는 것이다. 에이전트는 훈련 역학을 관찰하고, 거기에 반응해, 훈련이 진행되는 동안 옵티마이저의 소스 코드를 다시 써 내려간다. 현장에서 추론하며 각 파라미터 그룹의 가중치 업데이트 규칙을 직접 작성하기 때문에, 복잡한 스케줄을 구현하고 훈련 사고에 대응하며 단 한 번의 훈련 에피소드에 맞춰 옵티마이저를 맞춤 제작할 자유를 갖는다. 중요한 점은 이것이 완전한 제로샷이라는 것이다. 반복된 실험에서 학습하거나 보존하는 것이 전혀 없고, 옵티마이저의 알고리즘 전체가 매번 새로 쓰기의 대상이 된다.
레시피가 없는 상황을 겨냥하다
이 방식이 빛을 발하는 전형적 상황은 이렇다. GPU 한 대를 하루만 쓸 수 있고 LLM API 토큰도 넉넉지 않은 대학원생이 자신이 설계한 새 모델이나 새 데이터셋으로 진지한 훈련을 단 한 번만 돌릴 수 있다고 하자. 보통은 가장 표준적인 레시피나 최신 논문의 레시피를 골라 쓰고, 그것이 상황에 맞지 않아 손실이 튀거나 정체되는 위험을 감수한다. 새로운 아키텍처, 모달리티, 언어, 과학 데이터는 모두 대규모 스윕을 감당할 수 없는 이 범주에 들어간다. 반응형 옵티마이저는 예산을 다르게 쓰는 길을 제시한다. GPU 시간과 사람의 시간 대신 LLM 토큰을 소모해 레시피 튜닝의 부담을 상당 부분 덜어주는 것이다.
연구진이 OPAL(OPtimizer with an Agent in the Loop)이라 이름 붙인 이 옵티마이저는 modded-nanogpt의 최적화 트랙에서 출발했다. 162M GPT를 FineWeb으로 사전학습하는 이 과제에서, 원래 설정을 살짝 비튼 두 가지 자연스러운 변형을 만들었다. 하나는 같은 모델을 중국어·태국어·키르기스어 등 다른 언어 데이터로 훈련하는 것이고, 다른 하나는 배치 크기를 4분의 1로 줄인 것이다. 둘 다 전용으로 튜닝된 레시피가 없으므로, 리더보드의 다섯 가지 레시피를 자연스럽게 조정해 쓴 경우와 비교했다. 모든 새 설정에서 OPAL은 최선의 베이스라인을 능가하거나 그에 필적했다.
350개 언어마다 작은 GPT를 하나씩 공통 레시피로 훈련하는 Goldfish는 적응성을 검증하기에 좋은 무대였다. 암하라어의 공식 레시피는 FLORES-200 held-out 텍스트에서 문장당 83.48비트(낮을수록 좋음)로 끝났지만, 같은 레시피로 초기화된 OPAL은 단 한 번에 81.11까지 내려갔다. 학습률을 스윕하면 80.89로 더 앞서는 정적 레시피를 찾을 수 있었으나, 그 스윕 레시피에서 다시 출발한 OPAL은 80.73으로 또 한 번 앞섰다. 이미지 생성에서도 결과는 비슷했다. LightningDiT-XL/1에서 가이던스 적용 시 FID-50K 1.83 대 2.18, 미적용 시 4.33 대 5.15로 공식 레시피를 앞섰고, Muon 변형으로 훈련하는 RAEv2-B에서도 3.19 대 3.39를 기록했다. 이 실험들의 에이전트는 모두 Claude Opus 5.5로 구동됐다.
코드를 인터페이스로 삼는 양방향 루프
OPAL의 구조는 두 개의 프로그램으로 이뤄진다. 에이전트가 매 최적화 스텝에서 쓰이는 updater.py를 다시 쓸 수 있게 하되, 그 전에 훈련이 어떻게 진행되는지 스스로 관찰해야 한다. 가중치·활성값·기울기 같은 원시 상태를 그대로 넘기면 맥락이 넘쳐버리므로, 에이전트는 analysis.py라는 두 번째 프로그램을 직접 작성해 필요한 통계와 기하학적 지표만 뽑아낸다. 파라미터 그룹별 기울기 노름, 가중치 대비 업데이트 크기, 연속된 기울기 사이의 코사인, 비정상적으로 큰 기울기 스파이크를 보이는 텐서 같은 것들이다. 이렇게 analysis.py로 훈련이 에이전트가 원하는 형태로 전달되고, updater.py로 에이전트의 결정이 모든 스텝에 반영되면서 양방향 루프가 완성된다. 코드를 유일한 인터페이스로 삼은 덕분에 에이전트는 최적화의 어떤 부분이든 자유롭게 바꿀 수 있다.
흥미로운 것은 제로샷 에이전트가 스스로 내리는 결정들이다. 에이전트들이 만든 스케줄은 파라미터 그룹마다 별도의 다단계 스케줄을 두는 등 정교했고 실행마다 달랐다. 여러 사례에서 훈련 도중 학습률을 다시 올리는, 현대 스케줄러에서는 드문 움직임도 나타났다. SiT 에이전트는 각 그룹의 연속 기울기 코사인을 측정해, 음수인 곳에서는 학습률을 낮춰 타임스텝 임베더를 공식 값의 0.3배, 다시 0.15배로 줄였고, 코사인이 살짝 양수로 유지된 Muon 행렬에서는 오히려 올렸다. RAEv2 에이전트는 두 학습률을 수백 업데이트씩 번갈아 적용하며 손실을 비교하는 A-B-A 테스트를 돌려 3,100스텝부터 2배로 전환했고, 이후 1.3배와 1.5배를 거쳐 2배·2.5배·2.75배를 각각 약 650업데이트 시험한 끝에 2배를 택했다. 손실 추세를 보고 예정보다 쿨다운을 앞당기는 결정도 있었다. SiT는 190K 스텝에서 쿨다운을 320K에서 280K로 옮기고 학습률 하한을 피크의 0.1에서 0.05로 낮췄으며, RAEv2는 계획된 75% 대신 45% 지점인 11,250 업데이트에서 쿨다운을 시작했다.
실무적으로 어떻게 읽어야 하나
한국의 실무자 관점에서 OPAL의 가치는 '잘 다져진 레시피가 이미 존재하는' 과제보다 '아직 아무도 레시피를 튜닝해본 적 없는' 과제에서 두드러진다. 새 아키텍처가 Adam이나 Muon으로 잘 학습되지 않을 때, 그것이 아키텍처의 문제인지 아니면 아직 맞는 옵티마이저를 만나지 못한 것인지를 한 번의 실행 안에서 탐색해볼 수 있다는 점이 핵심이다. 또한 GPU 시간이나 사람의 시간이 병목일 때 그 자원을 LLM 토큰으로 치환한다는 발상은, 대규모 스윕을 감당할 수 없는 소규모 팀에 특히 현실적인 선택지가 된다. 다만 토큰 비용과 대규모 환경에서의 실용성은 원문에서도 별도로 따져봐야 할 과제로 남겨둔 부분이며, 제로샷 특성상 결과가 실행마다 달라진다는 점도 재현성을 중시하는 파이프라인에서는 유의할 지점이다. 직접 자신의 훈련에 적용해보려면 공개된 OPAL 패키지를 통해 시도할 수 있다.