모델을 바꾸는 세 번째 길
LLM이 다르게 동작하길 바랄 때 우리가 쓰는 방법은 거의 정해져 있어요. 프롬프트를 잘 쓰거나, RAG로 외부 지식을 붙이거나, 그래도 안 되면 파인튜닝을 하죠. 그런데 이 셋에는 공통점이 있어요. 전부 모델 바깥에서 간접적으로 영향을 준다는 거예요. 모델 안에서 정확히 무슨 일이 일어나는지는 모르는 채로 입력을 바꾸거나 데이터를 잔뜩 보여주고, 알아서 바뀌기를 기대하는 방식이거든요.
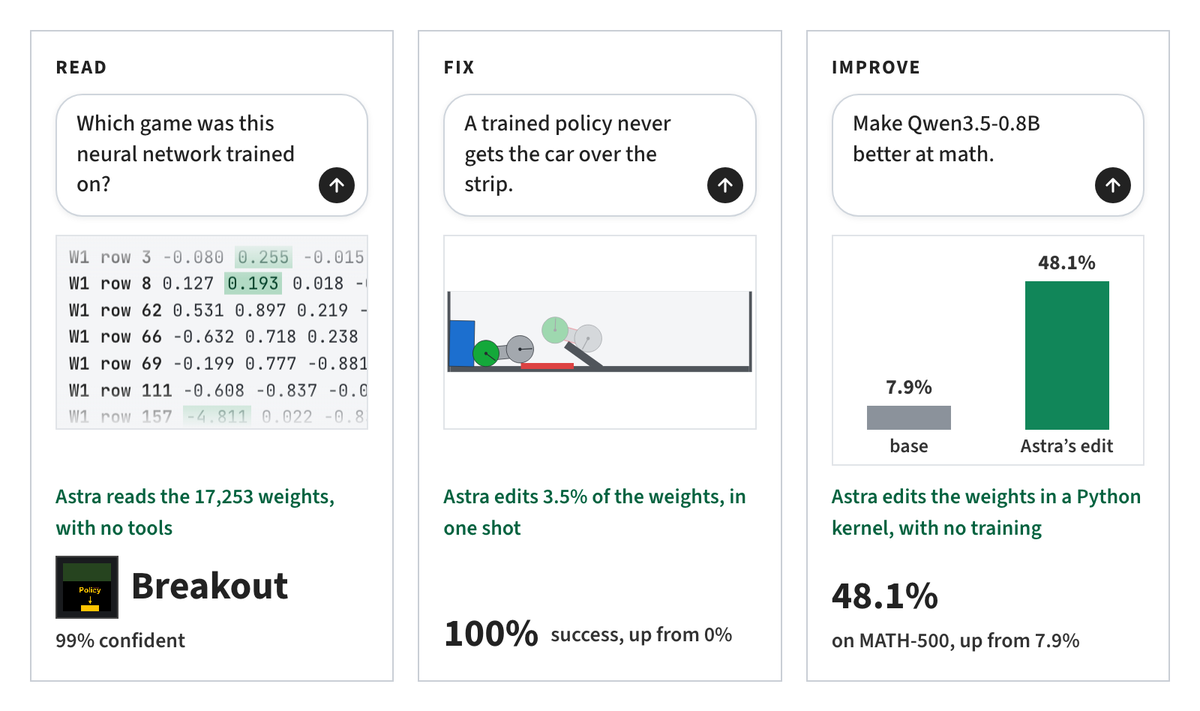
최근 공개된 'Weight-Space Programming(가중치 공간 프로그래밍)'이라는 글은 전혀 다른 질문을 던져요. 모델의 가중치를 코드처럼 직접 읽고, 필요한 곳만 골라서 고칠 수 있다면 어떨까요? 글에 나오는 Astra라는 시스템은 오픈 웨이트 모델인 Qwen의 가중치를 읽은 다음, 어디를 어떻게 바꿀지 판단해서 직접 써넣는 방식으로 모델 성능을 올렸다고 해요. 실험 설정이나 수치 같은 세부 내용은 원문에서 꼭 확인해 보시고, 여기서는 이 아이디어가 왜 흥미로운지, 그리고 어떤 연구 흐름에서 나왔는지를 풀어볼게요.
가중치가 뭐길래 '직접 고친다'는 게 대단한 걸까
가중치(weight)가 뭐냐면, 모델 안에 들어 있는 수십억 개의 숫자예요. 사람 뇌로 치면 신경세포끼리 얼마나 세게 연결돼 있는지를 나타내는 값 같은 거죠. 모델이 아는 지식이나 말투, 추론하는 습관이 전부 이 숫자들 사이 어딘가에 흩어져 저장돼 있어요.
파인튜닝은 이 숫자들을 경사하강법으로 바꿔요. 이게 뭐냐면, 정답 데이터를 보여주고 틀린 만큼 모든 가중치를 아주 조금씩 조정하는 일을 수천, 수만 번 반복하는 방식이에요. 안개 낀 산에서 발밑 경사만 보고 한 걸음씩 내려가는 것과 비슷해요. 효과는 확실하지만 데이터와 GPU가 많이 들고, 정확히 뭐가 바뀌었는지는 사람이 설명하기 어려워요.
가중치 공간 프로그래밍을 비유하자면, 학원에 보내서 반복 학습을 시키는 대신 뇌에서 특정 회로를 찾아 그 연결만 수술하는 쪽에 가까워요. 대략 이런 순환 과정으로 이해하면 쉬워요.
- 읽기: 가중치와 계산 중간에 나오는 값(활성값)을 분석해서, 어떤 층의 어떤 행렬, 그중에서도 어떤 방향이 특정 행동과 연결돼 있는지 찾아요.
- 쓰기: 찾아낸 부분의 숫자를 계산한 방향대로 직접 수정해요.
- 검증: 벤치마크나 테스트 셋으로 정말 좋아졌는지, 원래 잘하던 다른 능력이 망가지지는 않았는지 확인해요.
- 오픈 웨이트 모델을 쓰는 팀이라면 Qwen, Llama뿐 아니라 EXAONE, HyperCLOVA X SEED, Kanana 같은 국산 오픈 모델에도 같은 기법을 시도해볼 수 있어요. 파인튜닝용 데이터를 모으기 어려운 특정 행동을 교정할 때 특히 매력적이에요.
- 직접 실습해보고 싶다면 TransformerLens나 nnsight로 작은 모델의 활성값을 들여다보는 것부터 시작해 보세요. mergekit으로 모델 두 개를 섞어보는 것도 가중치 공간에 대한 감을 잡기에 좋아요.
- 수정했다면 회귀 테스트는 필수예요. 원래 잘하던 일을 여전히 잘하는지 확인할 평가 셋을 꼭 같이 준비하세요.
연구자가 손으로 하던 이 과정을 시스템이 스스로 돌릴 수 있다면, 모델을 개선하는 일이 '데이터 모아서 학습 돌리기'에서 '문제를 진단하고 패치하기'로 바뀔 수도 있어요. 이 글이 보여주는 가능성이 바로 이거예요.
갑자기 튀어나온 아이디어는 아니에요
가중치를 직접 건드리는 연구는 몇 년 전부터 꾸준히 쌓여 왔어요. 2022년에 나온 ROME / MEMIT은 '에펠탑은 파리에 있다' 같은 사실이 트랜스포머의 특정 MLP 층에 키-값 형태로 저장돼 있다는 걸 보여줬어요. 그리고 행렬에 작은 업데이트 하나만 더해서 그 사실을 바꾸는 데 성공했죠. 비슷한 시기에 나온 태스크 벡터(task arithmetic) 연구는 '파인튜닝한 가중치 - 원본 가중치'를 하나의 벡터로 봤는데요, 이걸 더하거나 빼서 능력을 붙이거나 떼어낼 수 있다는 걸 보였어요. mergekit 같은 도구로 여러 모델을 섞는 모델 머징도 같은 계열이에요.
2024년에는 LLM이 요청을 거절하는 행동이 가중치 공간에서 사실상 '한 방향'으로 표현된다는 연구가 나왔어요. 이 방향을 가중치에서 지워버리는 이른바 abliteration 기법이 커뮤니티에 퍼지기도 했고요. 여기서 중요한 교훈이 하나 나와요. 가중치를 직접 고치는 기술은 성능을 올리는 데도 쓰이지만, 안전장치를 없애는 데도 똑같이 쓰일 수 있다는 거예요.
그 사이에 희소 오토인코더(SAE)를 이용한 해석 가능성 연구도 '모델 안의 개념을 읽어내는 방법'을 꾸준히 발전시켜 왔어요. Astra 같은 시도는 이렇게 읽는 기술과 쓰는 기술을 하나의 자동화된 순환 과정으로 묶으려는 흐름의 연장선에 있다고 볼 수 있어요.
그럼 왜 하필 Qwen일까요? 크기별로 다양한 모델이 공개돼 있고 대부분 비교적 자유로운 라이선스로 풀려 있거든요. 그래서 요즘 오픈 모델 실험에서는 사실상 기본 재료처럼 쓰여요.
한국 개발자가 챙겨볼 포인트
당장 프로덕션에 넣을 기술은 아니에요. 모델 편집 연구에서 계속 지적되는 문제가 부작용(ripple effect)인데요, 한 곳을 고치면 엉뚱한 능력이 같이 망가지는 일이 흔해요. 벤치마크 점수만 보면서 수정하다 보면 그 벤치마크에만 과하게 맞춰질 위험도 있고요.
그래도 배워둘 가치는 충분해요.
마무리
한 줄로 정리하면, LLM을 학습시키는 대상이 아니라 읽고 고칠 수 있는 프로그램으로 바라보려는 시도예요. 앞으로는 모델 내부를 이해하는 능력이 AI 엔지니어의 중요한 차별점이 될 수도 있어요.
여러분은 어떻게 보세요? 가중치를 직접 고치는 방식이 언젠가 파인튜닝을 대체하게 될까요, 아니면 정밀한 보조 도구로 남을까요? 그리고 이 기술이 안전장치를 없애는 데도 쓰일 수 있다는 점은 어떻게 다뤄야 할까요?
🔗 출처: Hacker News