토큰 이야기부터 시작해볼게요
ChatGPT나 Claude 같은 언어 모델은 글자를 그대로 읽지 않아요. 먼저 토크나이저라는 도구가 문장을 '토큰'이라는 조각으로 잘라요. 예를 들어 'unbelievable'이 'un', 'believ', 'able'처럼 쪼개지는 식이죠. 모델은 이 토큰 번호들을 보고 다음 토큰을 예측해요.
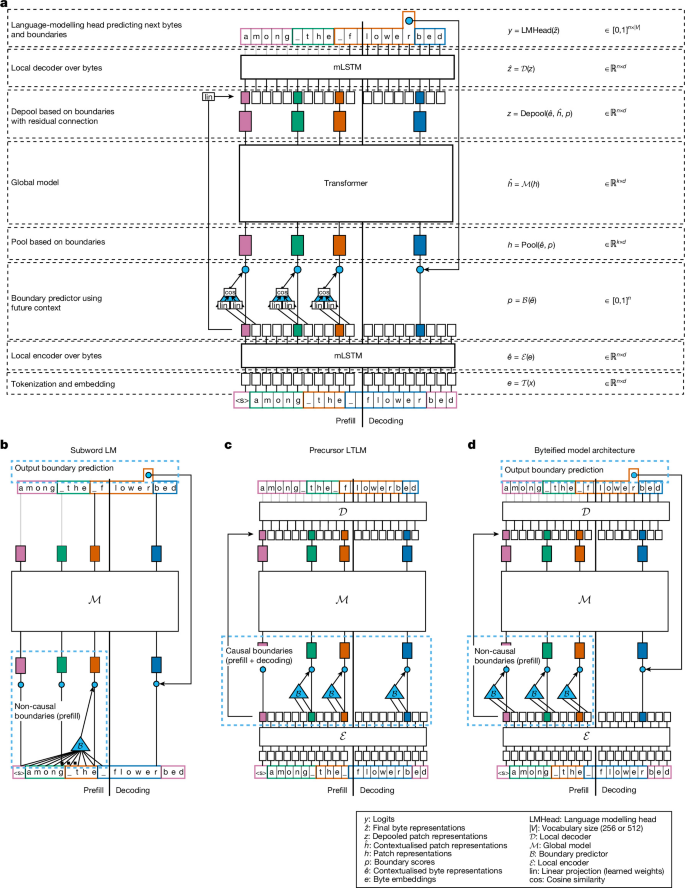
그런데 이 토크나이저가 은근히 골칫거리거든요. 이번에 Nature에 실린 연구는 이미 토큰 단위로 학습된 언어 모델을, 처음부터 다시 학습하지 않고 바이트 단위로 동작하게 '개조(retrofit)'하는 방법을 다뤄요. 핵심은 retrofit이라는 단어예요. 낡은 건물을 허물지 않고 내진 보강을 하듯, 이미 있는 모델을 살린 채로 고친다는 뜻이에요.
토크나이저가 왜 문제일까
토크나이저는 보통 학습 데이터에서 자주 나오는 문자열 조각을 모아 어휘집(vocabulary)을 만들어요. BPE(Byte Pair Encoding)가 대표적인 알고리즘이에요. 효율은 좋지만 부작용이 몇 가지 있어요.
하나는 글자 단위 작업에 약하다는 거예요. 'strawberry에 r이 몇 개야?' 같은 질문에 모델이 헷갈리던 이유 중 하나가 이거예요. 모델 눈에는 'straw'와 'berry' 같은 덩어리만 보이고, 그 안의 알파벳은 안 보이거든요.
또 하나는 언어 간 불공평이에요. 영어 위주 데이터로 어휘집을 만들면, 한국어 같은 언어는 같은 내용을 표현하는 데 토큰이 더 많이 들어요. API 요금이 토큰 단위로 나오니까 실제로 돈 문제이기도 하죠.
마지막으로 오타나 특이한 입력에 취약해요. 띄어쓰기 하나, 오타 하나에 토큰이 완전히 다르게 쪼개지면서 모델 반응이 이상해지는 경우가 있어요.
바이트 단위 모델이란
그래서 아예 토크나이저를 버리고 바이트를 직접 읽자는 시도가 꾸준히 있었어요. 컴퓨터에 저장된 텍스트는 결국 0부터 255까지의 숫자, 즉 바이트의 나열이니까 어휘집이 256개면 끝나요. 어떤 언어든, 이모지든, 코드든 다 같은 방식으로 처리되죠.
문제는 시퀀스가 엄청 길어진다는 거예요. 영어 기준으로 토큰 하나가 평균 4바이트 정도라고 하면, 같은 글을 네 배쯤 긴 시퀀스로 처리해야 해요. 트랜스포머의 어텐션 연산은 길이가 늘수록 비용이 급격히 커지고요. 그래서 구글의 ByT5, 메타의 MegaByte와 Byte Latent Transformer(BLT) 같은 연구들은 바이트를 '패치'로 묶어서 처리하는 계층 구조를 들여왔어요. BLT는 다음 바이트를 예측하기 어려운 지점(엔트로피가 높은 곳)에서 패치를 끊는 동적 분할로 효율을 끌어올렸고요.
Retrofit이 중요한 이유
그런데 이런 바이트 모델은 대부분 처음부터 새로 학습해야 했어요. 수조 개의 토큰으로 학습한 대형 모델의 지식을 버리고 다시 시작하는 건 비용 면에서 거의 불가능에 가깝죠.
Retrofit 접근의 기본 발상은 이래요. 기존 모델의 몸통인 트랜스포머 층 대부분은 그대로 두고, 입력과 출력 쪽만 바이트를 다룰 수 있게 바꾼 다음, 비교적 적은 양의 추가 학습으로 적응시키는 거예요. 엔진은 그대로 두고 연료 주입구와 배기구만 새 연료에 맞게 바꾸는 셈이죠. 이게 잘 되면 이미 공개된 오픈 모델을 바이트 모델로 '변환'할 길이 열리고, 바이트 모델 연구에 드는 비용도 크게 내려가요. 기존 모델의 토크나이저를 다른 것으로 옮겨 심는 'tokenizer transfer' 연구도 함께 이어지고 있어서, 토크나이저를 고정된 부품이 아니라 교체할 수 있는 부품으로 보는 흐름이 점점 뚜렷해지고 있어요.
한국 개발자에게 주는 시사점
한국어 입장에서 이 주제는 꽤 미묘해요. UTF-8에서 한글 음절 하나는 3바이트예요. 영어 알파벳 하나가 1바이트인 걸 생각하면, 바이트 모델에서 한국어 시퀀스는 더 길어져요. 대신 어휘집이 영어 쪽으로 치우치는 문제는 없어지니, '한국어는 토큰을 더 먹는다'는 문제가 전혀 다른 모양으로 바뀌는 거죠. 패치를 어떻게 묶느냐에 따라 한국어 효율이 크게 달라질 수 있어서, 한국어 데이터로 직접 재볼 가치가 있는 주제예요.
실무에서는 이렇게 생각해볼 수 있어요. 오타가 많은 사용자 입력(검색어, 채팅)을 다루거나, 자모 단위 처리가 필요하거나(초성 검색, 맞춤법 교정), 여러 언어와 코드가 섞인 텍스트를 다루는 서비스라면 바이트 단위 모델의 강점이 바로 와닿을 거예요. 당장 프로덕션에 쓰기엔 이르지만, 토크나이저가 LLM의 숨은 병목이라는 건 프롬프트를 설계하거나 비용을 계산할 때도 꼭 알아둘 개념이에요.
마무리
한 줄 정리: 토크나이저라는 오래된 병목을, 기존 모델을 버리지 않고 걷어낼 길이 열리고 있어요.
여러분이 다루는 서비스에서 토크나이저 때문에 겪은 이상한 현상이 있었나요? 한국어에는 바이트 단위 모델이 득일까요, 실일까요?
🔗 출처: Hacker News