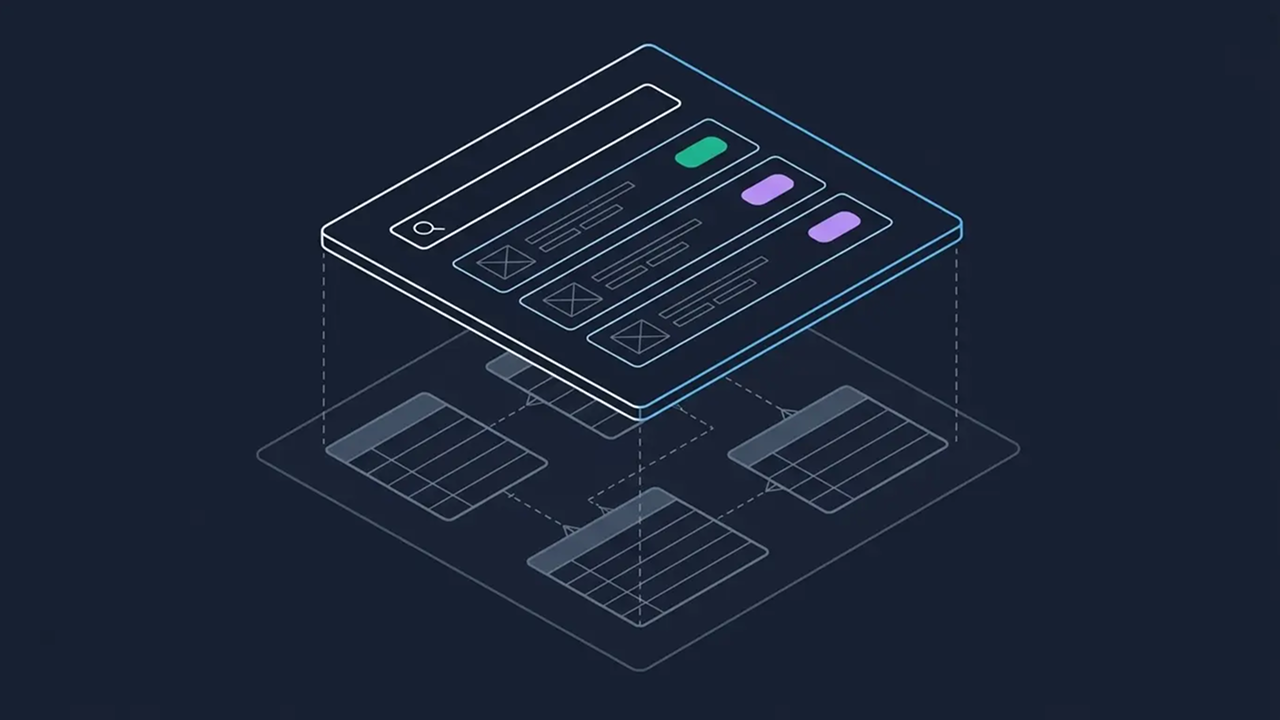
관계형 데이터베이스를 설계할 때 우리는 사용자, 게시글, 댓글을 각각 별도 테이블로 분리하는 정규화를 당연하게 여긴다. 사용자가 프로필을 수정할 때마다 그가 작성한 모든 게시글과 댓글을 함께 고쳐야 하는 상황을 피하기 위해서다. 그런데 이렇게 정규화된 스키마에서 "여러 테이블에 걸쳐 관련도가 높은 순으로 검색 결과를 뽑는" 작업, 즉 검색 조인(search join)을 하려고 하면 이야기가 달라진다. 지금까지 실무자들은 속도를 얻기 위해 취약한 ETL 파이프라인으로 데이터를 Elasticsearch에 비정규화해 밀어넣거나, 단순함을 택하는 대신 Postgres가 수백만 행을 느리게 조인·채점하도록 방치하는 양자택일을 강요받아 왔다. ParadeDB는 이 선택을 없애는 것을 목표로 검색 조인을 1급 기능으로 만들었다고 밝혔다.
왜 검색 조인은 느린가
문제의 본질은 정렬 기준에 있다. created_at처럼 단일 컬럼으로 정렬한다면 Postgres는 B-Tree 인덱스를 따라가다 조건을 만족하는 20개 행을 찾는 순간 멈출 수 있다. 하지만 여러 테이블의 관련도 점수를 OR로 합산해 정렬하는 경우, 그 합산 점수로 미리 정렬된 테이블은 어디에도 없다. 특정 댓글이 검색어를 포함하지 않아도 그 댓글이 달린 게시글이나 작성자를 통해 매칭될 수 있기 때문에, Postgres는 조인 전에 테이블을 걸러낼 수조차 없다. 결국 2,850만 행을 모두 조인하고, 모든 조합의 점수를 더한 뒤에야 상위 20개를 추릴 수 있다.
여기에 Postgres의 실행 방식이 비용을 더한다. 행 단위(row-at-a-time) 실행기는 조인을 위해 힙(heap) 저장소에서 튜플을 가져오는데, 이 비용이 크기 때문에 나중에 LIMIT 20에 의해 탈락할 가능성이 높은 행이라도 display_name, title 같은 필요할지 모르는 모든 컬럼을 미리 가져온다. 스택오버플로 데이터(사용자 230만, 게시글 2,000만, 댓글 2,900만 행)로 3개 테이블 OR 검색을 돌리면 B-Tree와 GIN 인덱스에 8-way 병렬을 적용해도 약 2분(11만 8,000ms)이 걸린다. OR을 테이블별 UNION ALL 84줄로 다시 쓰면 드문 검색어는 1.2초까지 줄지만, 흔한 검색어는 오히려 14초로 부풀고 유지보수 부담만 커진다.
컬럼 저장과 DataFusion으로 실행기를 바꾸다
ParadeDB의 해법은 인덱스와 실행기를 함께 다시 짜는 것이다. ParadeDB의 인덱스는 컬럼 저장소를 BM25·벡터 검색과 통합하고, 조인 키와 투영 컬럼을 인덱스 내부에 직접 저장한다. 검색 조인을 인식하면 Postgres의 플래너 훅을 통해 쿼리 계획에 개입해, 다중 테이블 JOIN과 LIMIT·GROUP BY·DISTINCT 등 전체를 Apache DataFusion으로 만든 컬럼형 실행기로 넘긴다. 검색과 무관한 쿼리는 Postgres 표준 실행기를 그대로 쓰며, 가속하는 쿼리는 Postgres와 결과가 동일한지 속성 테스트로 검증한다. DataFusion은 벡터화 실행과 공유 자원 없는(shared-nothing) 모델을 갖춘 빠른 OLAP 엔진으로, Postgres의 프로세스 모델과 잘 맞는다. 여기에 ParadeDB는 조인을 통과하는 데이터를 압축된 내부 문서 ID와 조인 키로 제한하고(지연 구체화), MVCC 가시성 검사를 조인이 행을 줄인 뒤로 미뤄 힙 접근 전에 가시성 맵을 먼저 확인하도록 DataFusion을 확장했다.
랭크 조인과 패싯 집계
핵심 기법인 랭크 조인(Rank Join)은 모든 행을 조인한 뒤 정렬하는 대신, 각 입력을 점수 내림차순으로 스트리밍하며 후보 집합을 쌓아간다. 어떤 스트림의 최저 점수(정렬 접근 바닥값)가 4.0이라면 아직 보지 못한 행은 그 이상 점수를 낼 수 없으므로, 남은 조합이 현재 상위 20개를 넘어설 수 없음을 증명하는 즉시 조기 종료할 수 있다. 다만 검색어에 전혀 매칭되지 않는 사용자가 쓴 고득점 게시글 같은 경우 바닥값을 충분히 낮추느라 수천 행을 끌어와야 하는데, ParadeDB는 정렬 접근 사이에 임의 접근(random access)을 끼워 넣어 조인 키로 상대 테이블을 직접 조회해 정확한 점수를 가져온다. 이 스트리밍 이진 조인 연산자 덕분에 3개 테이블 OR Top-K 쿼리가 단일 코어에서 100~600ms에 끝나고, 투영 컬럼은 최종 20개 행에 대해서만 구체화된다. 원래의 2분짜리 쿼리가 약 1000배 빨라진 셈이다.
검색 페이지의 다른 축인 패싯 집계는 성격이 다르다. 상위 20개에서 멈추는 Top-K와 달리 집계는 매칭되는 모든 행을 세야 하므로 조기 종료가 불가능하고, 따라서 랭크 조인을 쓸 수 없다. 저자 소개글이나 게시글 제목 중 하나에 'python'이 나타나면 매칭되는 식으로 2,000만 게시글 중 85만 4,000건을 집계해 상위 10개 태그를 뽑는 경우, Postgres의 표준 조인은 힙을 훑느라 35.3초가 걸린다. 중복 제거가 필요한 수동 UNION 재작성으로 1.0초까지 줄일 수 있지만, ParadeDB는 자연스러운 SQL을 컬럼형 인덱스 안에서 422ms에, 그것도 48배 적은 버퍼로 처리한다.
실무적 함의와 한계
이 접근의 가장 큰 가치는 별도 검색 인프라 없이 가장 단순하고 유지보수하기 쉬운 SQL을 그대로 쓸 수 있다는 점이다. Elasticsearch로 비정규화하면 중첩 필드, enrich 프로세서, 10,000행 배치 제한이 걸리는 LOOKUP JOIN 같은 개념을 거치고도 사용자나 배지 중 하나는 결국 모든 게시글과 댓글에 비정규화해야 하며, 복제 후 저장 공간이 최대 3배로 늘고 두 DB에 이중 쓰기를 해야 한다. ParadeDB는 이 복잡성과 쓰기·공간 증폭을 제거한다. 다만 공개된 벤치마크에서 Postgres 계획들은 최대 8개 워커로 병렬 실행되는 반면 ParadeDB의 랭크 조인은 현재 단일 코어로 동작한다는 점은 염두에 둘 필요가 있다. 집계 쿼리는 양쪽 모두 병렬 해시 조인을 쓴다. ParadeDB는 향후 랭크 조인의 워커 병렬화와 공동 파티셔닝(co-partitioning)을 지원할 계획이라고 밝혔다. 수치는 특정 스택오버플로 데이터셋과 쿼리 형태에 기반한 것인 만큼, 도입을 검토하는 팀은 자신의 스키마와 검색 패턴으로 재현해 확인하는 것이 바람직하다.