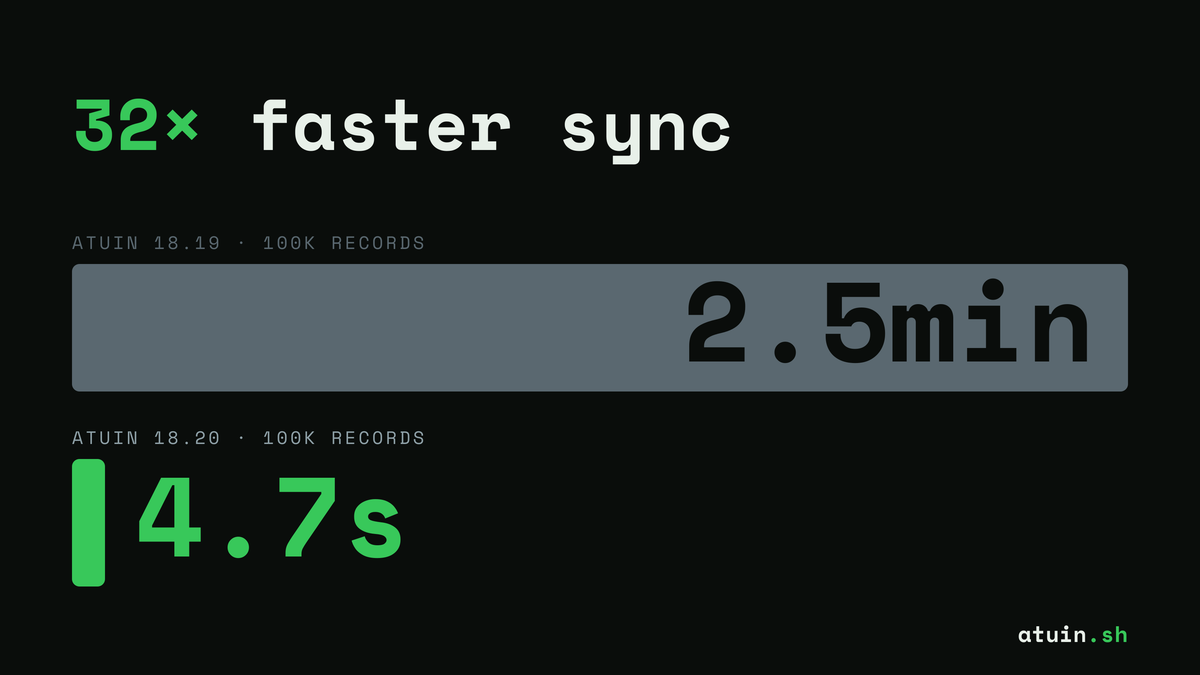
셸 히스토리를 여러 기기에 걸쳐 동기화해 주는 도구 Atuin이 18.20.0 릴리스에서 동기화 속도를 크게 끌어올렸다. 개발팀은 호스티드 서비스인 Atuin Hub 기준 최대 32배, 자체 호스팅 사용자 기준 16배 빨라졌다고 밝혔다. 수천 건의 레코드를 한 자릿수 초 안에 맞추게 됐다는 것이다. 흥미로운 점은 이 개선이 동기화 프로토콜 버전을 올리지 않고 이뤄졌다는 사실인데, 기존 사용자가 단순히 업데이트만 해도 즉시 혜택을 받을 수 있다는 의미다.
암호화가 만든 제약
Atuin은 셸 히스토리를 포함한 터미널 데이터를 엔드투엔드로 암호화한다. 서버는 사용자의 데이터를 읽을 수도, 압축하거나 묶을 수도 없다. 일반적인 서버라면 데이터를 압축해 전송량을 줄이겠지만, Atuin 서버가 보는 것은 암호문뿐이다. 더구나 암호문은 통계적으로 노이즈와 구별되지 않기 때문에 압축이 사실상 불가능하다. 기존 18.19.0 버전은 레코드를 100건 단위 페이지로 내려받았는데, 이 페이지들은 대체로 비압축 상태였고 압축도 먹히지 않았다.
문제의 성격은 Atuin의 데이터 구조에서 비롯된다. 레코드 저장소는 사실상 쓰기 전 로그(write-ahead log)에 가깝다. 새 기록이 로그 끝에 계속 더해지고, 다운로드 동기화는 클라이언트에 없는 레코드를 서버에서 하나씩 받아 오는 방식이다. 동기화 시간이 레코드 수에 비례해 선형으로 늘어나는 구조여서, 기록이 쌓일수록 느려진다. 개발팀이 공개한 수치를 보면 Hub의 중앙값 사용자는 레코드 7,338건에 약 11.7초, 평균 사용자는 26,075건에 약 40초가 걸렸다. 상위 5%, 1% 사용자는 각각 2.2분, 5.4분까지 치솟았다. 활동적인 사용자일수록 더 나쁜 경험을 하게 되는 셈이다.
클라이언트가 직접 묶는 패크파일
선형 복잡도 자체는 바꿀 수 없으니, 개발팀은 상수 항을 줄이는 쪽을 택했다. 그 핵심이 Git의 패크파일에서 아이디어를 빌려 온 자체 패크파일이다. 원리는 단순하다. 평문 레코드 N개를 모아 하나로 묶고, 압축한 뒤, 암호화한다. 암호화 이전에 압축하기 때문에 암호문 압축 불가 문제를 우회할 수 있다. 다만 서버는 암호화 키가 없으므로 이 작업을 서버가 대신할 수 없다. 결국 키와 원본 레코드를 모두 가진 클라이언트가 패킹을 책임진다.
구체적으로 Atuin 데몬은 사용하는 동안 레코드를 담는 롤링 버퍼를 유지한다. 버퍼가 임계치에 도달하면 데몬은 어떤 레코드 구간이 포함되는지를 기록한 작은 '패크파일 매니페스트' 레코드를 데이터베이스에 만든다. 이 시점까지는 무거운 연산이 없다. 실제 패킹은 동기화 시점에 일어난다. 새로 도입된 '기능 협상(capabilities)' 체계가 서버의 패크파일 지원 여부를 확인하고, 지원한다면 매니페스트가 가리키는 레코드들을 찾아 rmp로 직렬화하고 zstd로 압축한 뒤 기존 PASETO v4 방식으로 암호화한다. 완성된 패크파일은 일반 레코드와는 별도 경로로, 서버가 발급한 사전 서명 URL에 PUT으로 업로드된다. 다운로드 시에는 매니페스트를 받아 각 패크파일의 사전 서명 URL을 얻고, 내려받아 복호화·압축 해제한 뒤 개별 레코드로 쪼개 저장한다.
패킹 외의 개선과 남은 과제
속도 향상이 전부 패크파일 덕분은 아니다. 합성 벤치마크에서 레코드 10만 건의 파워 유저 기준으로 18.20.0은 약 30배 빨라졌는데, 이 중 패크파일이 기여한 몫은 약 2배다. 나머지는 다운로드 파이프라이닝과 배치 SQL 삽입에서 나왔다. 기존에는 페이지 하나를 받아 레코드를 하나씩 넣고 다음 페이지를 받는 순차 방식이었지만, 반복 구조를 조금 손봐 여러 페이지를 병렬로 미리 요청하도록 바꿨다. 이 파이프라이닝은 패크파일과 달리 18.20에서 모든 사용자에게 바로 적용되며, 단순 업데이트만으로 16배 속도를 얻는다. 패크파일은 이후 몇 주에 걸쳐 점진적으로 배포될 예정이다.
실무 관점에서 눈여겨볼 지점은 이 접근이 '암호화를 포기하지 않으면서 압축 이득을 얻는' 전형적인 설계라는 데 있다. 압축은 반드시 암호화 전에, 그리고 서버가 아닌 신뢰 경계 안쪽에서 수행돼야 한다는 제약을 그대로 보여 준다. 다만 한계도 분명하다. 현재 Hub 패크파일은 1,000건 고정 폭이며 크기는 10~100KB 수준이다. 패크파일 수가 매우 많아지는 경우를 위해 개발팀은 패크파일을 다시 묶는 '패크파일의 패크파일'(트리 구조)과, 여러 패크파일에 유효한 단일 사전 서명 URL로 왕복 횟수를 줄이는 방안을 검토 중이다. 또한 PASETO v4의 base64·메타데이터 오버헤드를 걷어내고 청크 단위 스트리밍 암복호화가 가능한 ChaCha20-Poly1305로의 전환도 탐색하고 있다.
이번 작업의 의미는 속도 수치 자체보다 그 위에 쌓일 기능에 있을 수 있다. 개발팀은 패크파일 인프라 덕분에 앞으로 실행한 명령뿐 아니라 명령의 출력, 에이전트 세션까지 기록하고 검색할 수 있게 될 것이라고 예고했다. 대량의 데이터를 암호화된 상태로 효율적으로 묶고 옮기는 기반이 마련된 만큼, 터미널 히스토리 도구가 담을 수 있는 데이터의 종류가 확장될 여지가 생긴 것이다. 자체 호스팅 환경을 운영하는 쪽이라면 프로토콜 버전 상승 없이 양방향 호환이 유지된다는 점이 특히 반가운 대목이다.