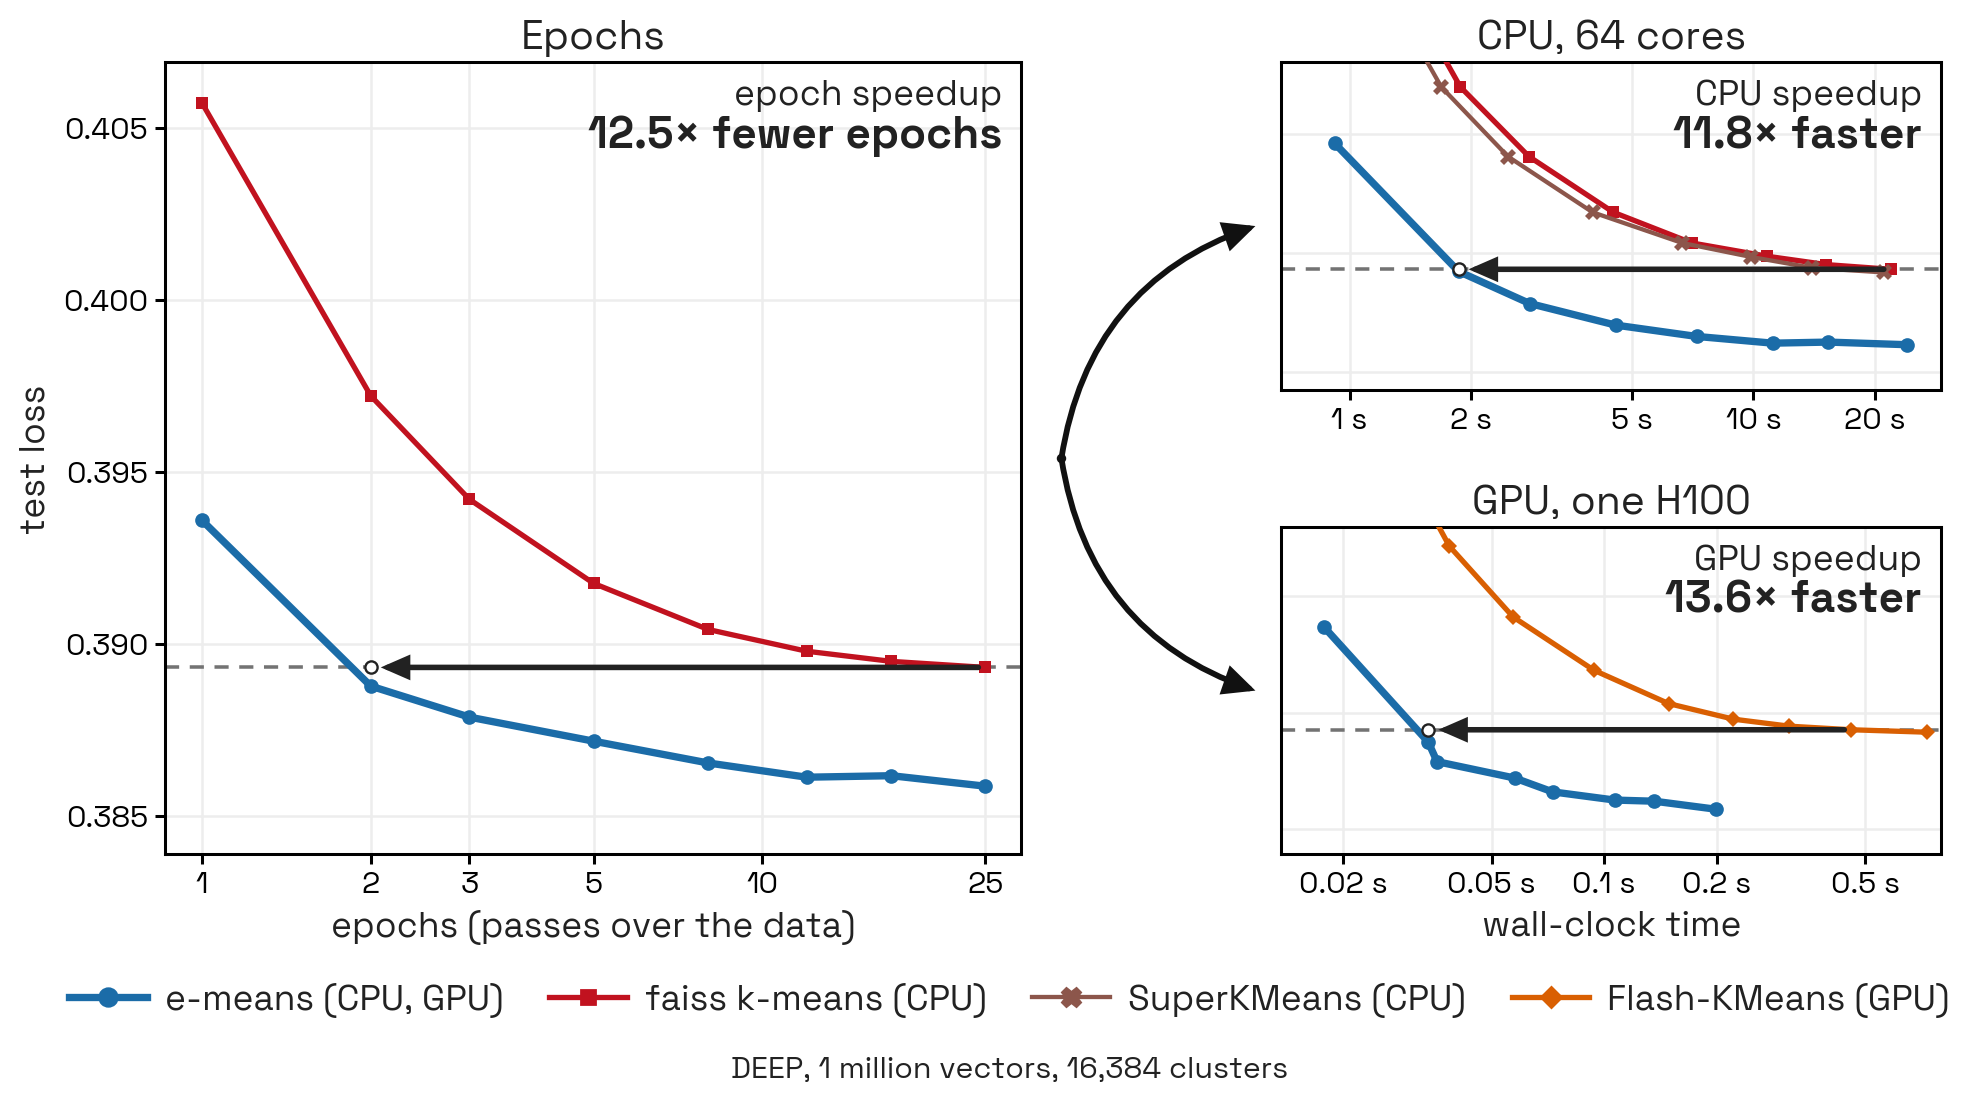
벡터 검색, 추천 시스템, 코드북 양자화까지 k-means 군집화는 여전히 머신러닝 파이프라인의 기본 도구다. 그런데 그 내부 최적화 규칙은 1950~60년대에 제안된 로이드(Lloyd) 알고리즘에서 크게 벗어나지 않았다. 로이드는 전체 데이터를 한 번 훑어 모든 점을 가장 가까운 중심에 배정하고 중심을 다시 계산하는 과정을 20~50회 반복한다. 'e-means'는 이 반복 규칙 자체를 현대적으로 다시 설계해, 같은 품질의 군집을 훨씬 적은 연산으로 얻겠다는 시도다. 공개된 설명에 따르면 로이드가 25에포크에서 도달하는 테스트 손실을 e-means는 1.2~3에포크 만에 넘어서며, 실측 기준 GPU에서는 최신 구현인 Flash-KMeans 대비 10~45배, CPU에서는 Faiss 대비 8~15배의 벽시계 시간 단축을 보고한다. 통상 속도와 품질이 맞교환되는 k-means에서 양쪽을 동시에 개선했다는 점이 핵심 주장이다.
지수이동평균이라는 선택
모든 k-means 변형은 클러스터마다 점들의 합(S)과 개수(N)를 유지하고 그 비율을 중심으로 삼는다. 차이는 S와 N을 어떻게 갱신하느냐에 있다. 로이드는 매번 전체 데이터로 처음부터 다시 계산하고, 맥퀸(MacQueen) 방식은 과거 배정을 버리지 않고 누적한다. 누적 방식은 초기의 나쁜 중심 위치에서 배정된 점까지 평균에 섞이는 문제가 있다. e-means는 미니배치 단위로 동작하되 이 합을 지수이동평균(EMA)으로 대체해, 오래된 배정을 α 비율로 잊고 최근 배정을 추적한다. 원래 EMA 갱신은 분포가 계속 움직이는 VQ-VAE 코드북 학습에서 쓰이던 방식인데, 정적 데이터셋에서도 다른 구성요소와 결합하고 하이퍼파라미터를 제대로 맞추면 매우 효율적이라는 것이 이 프로젝트의 발견이다.
이 선택에는 안정성이라는 이유가 있다. e-means는 Meta FAIR의 위고 투브롱, 에르베 제구가 수행한 선행 연구, 즉 경사하강 기반 미니배치 k-means가 로이드를 이길 수 있다는 결과에서 출발했다. 다만 경사하강 갱신은 큰 학습률에서 불안정했는데, EMA 갱신은 중심이 항상 배정된 점들의 볼록 껍질(convex hull) 안에 머무는 것을 보장하기 때문에 과도한 이동으로 껍질 밖으로 튀어나가는 일이 없다. 이름의 'e'도 여기서 왔다.
하이퍼파라미터를 스케일링 법칙에 맡기다
실무자 입장에서 가장 눈여겨볼 지점은, e-means가 로이드에 비해 추가로 조정해야 할 하이퍼파라미터가 없다는 설계다. 미니배치 방식은 보통 배치 크기와 스텝 크기를 손으로 맞춰야 하지만, e-means는 문제의 특성값(점 개수 n, 군집 수 k, 에포크 T)으로부터 배치 크기 B와 스텝 α0를 자동으로 정하는 두 개의 스케일링 법칙을 피팅했다. 처리량을 우선하는 '기본 법칙'과 품질을 위해 처리량을 일부 내주는 '품질 법칙'을 함께 제공한다. 흥미롭게도 배치를 전체 데이터로, α를 1로 두면 e-means 한 번의 갱신이 로이드 한 번과 정확히 같아진다. 즉 로이드는 코사인 스케줄링이 빠진 e-means의 극단적 특수 사례인데, 하이퍼파라미터 탐색 결과 바로 그 구석 설정이 가장 비효율적인 영역에 놓인다는 것이다. 미니배치의 잡음 섞인 갱신이 최적화 지형을 더 탐색해 국소 최저점을 빠져나가기 쉬운 반면, 손실이 항상 감소하는 로이드는 찾은 국소해에 갇히기 쉽다는 설명이 뒤따른다.
미니배치 k-means의 고질적 약점인 '죽은 클러스터', 즉 학습 중 배정 점이 0이 되는 중심 문제도 다룬다. EnCodec처럼 작아진 중심을 배치에서 뽑은 임의 샘플로 교체하는 방식은 완전한 해결이 아니라고 보고, e-means는 Faiss의 방식을 응용해 크기에 비례해 뽑은 활성 클러스터를 둘로 쪼개 되살린다. 이 방식이 코드북 용량 보존에 더 효과적이었다고 한다. 여기에 더 나은 초기화, 코사인 감쇠, 그리고 학습 말미에 각 클러스터의 정확한 마지막 에포크 평균으로 마무리해 손실을 더 낮추는 '종료 단계'까지 더해진다. 이 모든 값이 스케일링 법칙에서 파생된다.
실무에서 읽을 점과 한계
e-means의 속도 이득이 단순한 에포크 수 절감에 그치지 않는다는 점도 중요하다. 최근접 중심 배정을 융합한 전용 GPU 커널이 있어야 알고리즘상의 에포크 절감이 실제 벽시계 속도로 번역된다. 즉 보고된 배수의 상당 부분은 구현 최적화와 함께 달성된 수치이며, 커널이 없는 환경에서 같은 배수를 기대하긴 어렵다. 검증은 임베딩·합성 데이터 24종과 구성에서 이뤄졌고, 영상 자료를 위해서는 10만~1억 점 규모의 16개 데이터셋에 걸쳐 234개 구성으로 비교했다고 밝힌다. 다만 이 방법은 분포가 고정된 정적 데이터셋을 전제로 하며, 분포가 계속 움직이는 VQ-VAE 학습 같은 상황과는 문제 설정 자체가 다르다는 점을 저자도 구분한다.
정리하면 e-means는 로이드를 대체하려는 완전히 새로운 알고리즘이라기보다, 미니배치·EMA·스케일링 법칙이라는 현대적 최적화 관행을 k-means라는 오래된 문제에 체계적으로 이식한 작업에 가깝다. 대규모 코드북이나 수천만 벡터 규모의 군집화를 반복적으로 돌려야 하는 팀이라면, 추가 튜닝 부담 없이 로이드 수준 손실을 훨씬 빠르게 얻을 수 있다는 약속은 검토할 가치가 있다. 구체적인 스케일링 법칙 계수와 재현 조건은 논문(arXiv:2611.09501)에서 확인하는 편이 안전하다.