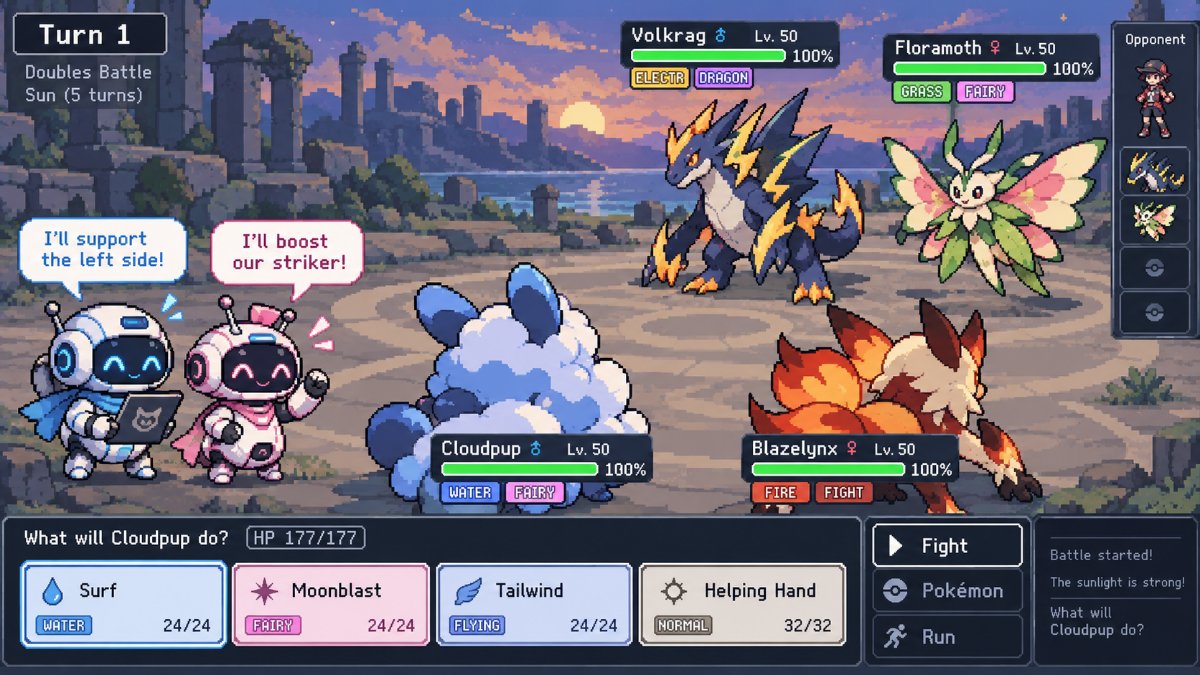
대규모 언어모델(LLM)을 여러 개 묶어 쓰는 멀티 에이전트 연구는 대부분 '워크플로' 형태였다. 한 에이전트가 작업을 처리해 다음 에이전트로 넘기는 파이프라인 구조다. 그러나 실무에서 점점 중요해지는 것은 동등한 지위의 에이전트들이 서로 소통하고 행동을 조율하는 능력이다. 올리버 그라브너(Oliver Grabner)가 공개한 실험은 바로 이 지점을 겨냥한다. 포켓몬 대전 시뮬레이터 '포켓몬 쇼다운'의 2대2(더블) 포맷을 빌려, 같은 편에 선 두 LLM 에이전트가 매 턴 전에 대화를 나눌 수 있게 하고 '대화가 승률을 올리는가, 그리고 그 대가는 무엇인가'를 측정했다.
포켓몬 더블 대전은 협력 능력을 재기에 꽤 까다로운 환경이다. 상대의 구성이 숨겨져 있어 완전정보 게임이 아니고, 기술의 데미지에도 난수가 개입한다. 상대 팀을 읽고, 두 공격 대상을 나누고, 파트너의 수를 염두에 두고 계획해야 한다. 기존의 포켓에이전트 챌린지(PokéAgent Challenge) 같은 벤치마크가 있지만 거기서는 한쪽을 에이전트 하나가 통째로 조종하며, 전문 강화학습(RL) 에이전트가 범용 LLM을 여전히 앞선다. 다시 말해 '서로 호흡을 맞춰야 하는 동료' 상황은 평가되지 않았다는 것이 저자의 문제의식이다.
실험은 어떻게 설계됐나
저자는 공식 포켓몬 쇼다운 시뮬레이터를 강화학습용 Gym 스타일 환경으로 감쌌다. 네 명의 플레이어가 각자 포켓몬 한 마리씩 조종하고, 두 명이 한 편을 이룬다. 각 팀은 세 마리 중에서 내보낸다. 매 턴 에이전트는 전황을 평이한 영어로 요약한 설명과 번호가 매겨진 합법적인 기술 목록을 읽고, 파트너에게 비공개 메시지를 보내거나 기술을 선택한다. 일단 기술을 정하면 그 선택이 파트너에게 전달된다. 대화 방식은 네 가지로 나뉜다. 둘 다 결정할 때까지 계속 주고받는 '자유 대화', 각자 한 번씩만 말하는 방식, 대화 없음, 그리고 한 모델이 두 마리를 모두 조종하는 방식이다. 실험에서는 Qwen3.8-27B가 두 동료를 모두 맡아, 데미지를 최대화하도록 짜인 스크립트 봇과 겨뤘다. 대전은 시드가 고정되고 모든 팀 조합을 양쪽에서 번갈아 치르게 해, 각 대화 방식이 동일한 대전을 상대하도록 통제했다.
대화는 이긴다, 그리고 비싸다
결과는 명료했다. 자유롭게 대화한 동료들은 최대 데미지 봇을 상대로 64%를 이겼고, 전혀 대화하지 못한 경우는 42%에 그쳤다. 각자 한 번씩만 말해도 52%로 '대화 없음'을 앞섰다. 흥미로운 것은 한 모델이 두 마리를 모두 조종한 경우로, 54%를 기록해 '대화 없음'보다는 나았지만 자유 대화에는 미치지 못했다. 저자는 이 차이를 근거로, 성능 향상이 단지 한 지능이 두 수를 동시에 계획해서가 아니라 '대화 그 자체'에서 나온다고 해석한다.
물론 공짜는 아니다. 자유 대화는 한 대전당 프롬프트 토큰을 97만8천 개 소모했는데, 이는 대화 없음(25만9천 개)의 3.8배다. 메시지를 한 번 주고받을 때마다 모델을 다시 호출해 전황과 그간의 대화 전체를 다시 읽어야 하기 때문이다. 공개된 대화 샘플을 보면 이 비용의 정체가 드러난다. 한 에이전트가 '상대 둘 다 물 타입이라 내 불꽃 기술이 반감된다'며 전략을 제안하자, 파트너가 '격투는 물·땅에 반감되지 않으니 내 인파이트는 양쪽에 1배'라고 정정하며 수를 확정한다. 이렇게 서로의 오판을 교정하는 상호작용이 승률을 끌어올리지만, 그 대화량이 곧 토큰 청구서가 된다.
벤치마크로서의 가능성
저자는 이 환경이 모델의 실력 차이를 실제로 구별해내는지도 점검했다. Qwen3.8-27B 팀은 2B 모델 팀을 상대로 96%, 9B 모델 팀을 상대로 74%를 이겼고, 최대 데미지 봇 상대로는 64%였다. 상대가 강할수록 승부가 팽팽해졌다는 뜻인데, 이는 모델을 비교하는 벤치마크로 쓰기에 적합한 성질이다. 너무 쉽거나 너무 어려우면 변별력이 없기 때문이다.
실무자 관점에서 이 실험이 던지는 메시지는 분명하다. 에이전트 간 대화는 협력 품질을 높이지만 토큰 비용이 거의 선형적으로 불어난다. 매 턴 전체 맥락을 재전송하는 구조에서는 더욱 그렇다. 따라서 '대화 없음, 한 번씩, 자유 대화' 사이의 선택은 과제의 난이도와 예산에 따라 조율해야 할 설계 변수이지, 무조건 많이 대화할수록 좋은 것이 아니다. 다만 이 연구는 Qwen 계열 단일 모델군, 스크립트 봇이라는 통제된 상대, 포켓몬이라는 특정 게임에서 얻은 결과라는 한계를 분명히 갖는다. 저자 스스로도 '대화의 효과'와 '파트너의 수를 보는 효과'가 아직 뒤섞여 있다는 점을 인정하며, 이 둘을 분리하고 모델 간 리더보드와 RL 학습 환경으로 확장하는 것을 다음 과제로 남겼다. 협력형 에이전트를 저비용으로 설계하려는 팀이라면, 결과의 방향성은 참고하되 자기 도메인에서 비용·효과 곡선을 직접 재보는 편이 안전하다.