무슨 일이 있었나
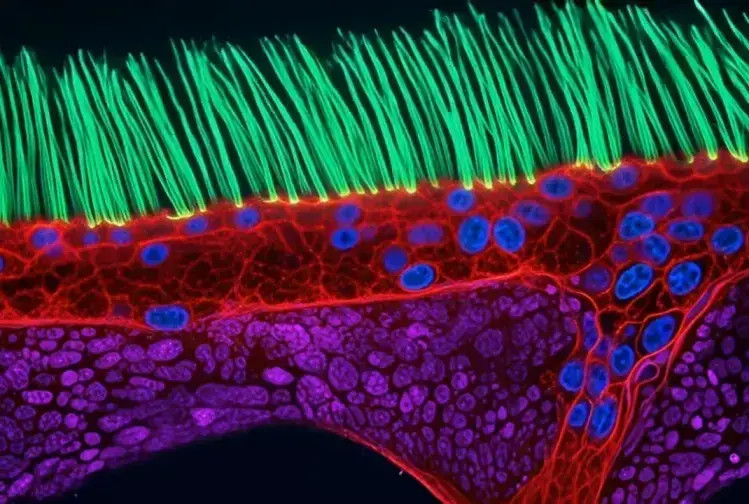
니콘이 주최한 사진 공모전에서 수상작으로 뽑혔던 작품이 결국 수상을 취소당했어요. 과학자들이 이미지를 들여다보다가 AI로 만들었거나 조작한 흔적을 찾아냈거든요. 심사위원도 못 거른 걸, 전문 지식을 가진 사람들이 '실제로는 이렇게 생길 수가 없다'고 짚어낸 거예요.
이 사건이 흥미로운 이유가 있어요. AI 이미지 판별이 이제 눈썰미 좋은 사람이 알아채는 수준을 넘어섰다는 걸 보여주거든요. 도메인 지식과 기술이 같이 있어야 잡아낼 수 있는 단계가 된 거죠. 개발자에게도 남 일이 아니에요. 우리가 만드는 서비스에 올라오는 이미지가 진짜인지 아닌지가 점점 더 중요한 문제가 되고 있으니까요.
과학자들은 어떻게 알아챘을까
이번 사례의 구체적인 판별 근거는 원문 기사를 참고해주세요. 여기서는 이런 사례에서 흔히 쓰는 판별 방법을 정리해볼게요.
첫 번째는 물리적·생물학적으로 말이 안 되는 디테일이에요. 생성형 AI는 그럴듯해 보이는 걸 만드는 데는 뛰어나요. 하지만 실제로 그래야 하는 규칙까지 지키지는 못해요. 곤충 다리 마디 수가 틀리거나, 세포 구조가 실제 생물과 다르거나, 빛 방향과 그림자가 안 맞는 식이죠. 일반인 눈에는 멋진 사진이지만, 그 분야를 평생 연구한 사람은 '이 생물은 이렇게 안 생겼는데?' 하고 바로 알아봐요.
두 번째는 이미지 자체에 남는 통계적 흔적이에요. 실제 카메라 센서로 찍은 사진에는 센서마다 고유한 노이즈 패턴이 있어요. 카메라마다 조금씩 다른 지문 같은 거예요. AI가 만든 이미지에는 이 패턴이 없거나 부자연스럽게 고르게 나타나요. 같은 텍스처가 반복되거나 경계가 녹아내린 듯한 부분도 흔한 단서예요.
세 번째는 원본 파일과 메타데이터예요. 공모전은 의심이 가면 보통 RAW 원본 파일을 요구해요. RAW는 센서가 받은 데이터를 거의 가공하지 않은 파일이라서, 이걸 내지 못하면 신뢰가 크게 떨어져요.
업계 맥락: 반복되는 사진 공모전 논란
이런 일이 처음은 아니에요. 2023년 소니 월드 포토그래피 어워드에서는 독일 작가 보리스 엘다크센이 AI로 만든 작품으로 수상했어요. 그 뒤 스스로 AI 작품이라고 밝히고 수상을 거부해서 큰 논쟁이 됐죠. 2024년에는 반대 사건도 있었어요. 한 사진가가 AI 부문에 실제로 찍은 사진을 내서 수상했다가 실격됐어요.
기술 업계는 나중에 잡아내는 것보다 처음부터 출처를 증명하는 쪽으로 방향을 틀고 있어요. 대표적인 게 C2PA(콘텐츠 출처와 진위를 증명하는 업계 연합 표준)예요. 사진을 찍는 순간 카메라가 전자 서명을 붙이고, 이후 편집 이력까지 기록해요. 그래서 '어떤 기기로 찍었고 어떤 수정을 거쳤는지' 검증할 수 있어요. 택배 송장에 배송 이력이 하나하나 찍히는 것과 비슷해요. 니콘, 소니, 캐논, 라이카 같은 카메라 제조사와 어도비, 구글, 마이크로소프트 같은 기업들이 참여하고 있어요. 구글 SynthID처럼 AI 생성 이미지에 눈에 안 보이는 워터마크를 넣는 방식도 있고요.
다만 이것도 만능은 아니에요. 2025년에는 니콘 카메라의 콘텐츠 자격증명 기능에서 취약점이 보고됐어요. 그 결과 관련 인증서를 폐기하고 서비스를 멈춰야 했죠. 서명 체계는 키 관리나 구현이 조금만 허술해도 신뢰 전체가 흔들린다는 걸 보여준 사례예요.
한국 개발자에게 주는 시사점
사용자가 올린 콘텐츠를 다루는 서비스라면 곧 이 문제를 만나게 될 거예요. 커뮤니티, 중고거래, 리뷰 플랫폼, 부동산 매물 사진을 받는 서비스 같은 곳이요. 몇 가지 생각해볼 점이 있어요.
먼저 AI 판별 모델만 믿으면 안 돼요. 탐지 모델은 오탐(진짜를 가짜로 판단)과 미탐(가짜를 놓침)이 생각보다 많아요. 생성 모델이 좋아질수록 정확도도 떨어지고요. 판별 결과는 확정 판정이 아니라 '사람이 검토해볼 신호'로 쓰는 게 안전해요.
다음으로 업로드할 때 메타데이터를 남길지 고민해보세요. 많은 서비스가 이미지 크기를 줄이면서 EXIF나 C2PA 정보를 지워버려요. 출처 검증이 중요한 서비스라면 이 정보를 보존하거나 따로 검증하는 파이프라인이 필요할 수 있어요.
마지막으로 이번 사건처럼 도메인 전문가의 눈이 여전히 가장 강력한 탐지기예요. 기술과 사람의 검토를 어떻게 섞을지가 실제 설계의 핵심이 돼요.
마무리
한 줄 정리: AI 이미지는 그럴듯함은 흉내 내도 사실까지는 흉내 내지 못해요. 그 틈을 잡아내는 건 결국 기술과 전문 지식의 조합이에요.
여러분 서비스에 AI 생성 이미지가 올라온다면 막으실 건가요, 표시만 하실 건가요? 그리고 C2PA 같은 출처 증명 표준이 정말 대세가 될 수 있을까요?
🔗 출처: Hacker News