무슨 이야기인가요
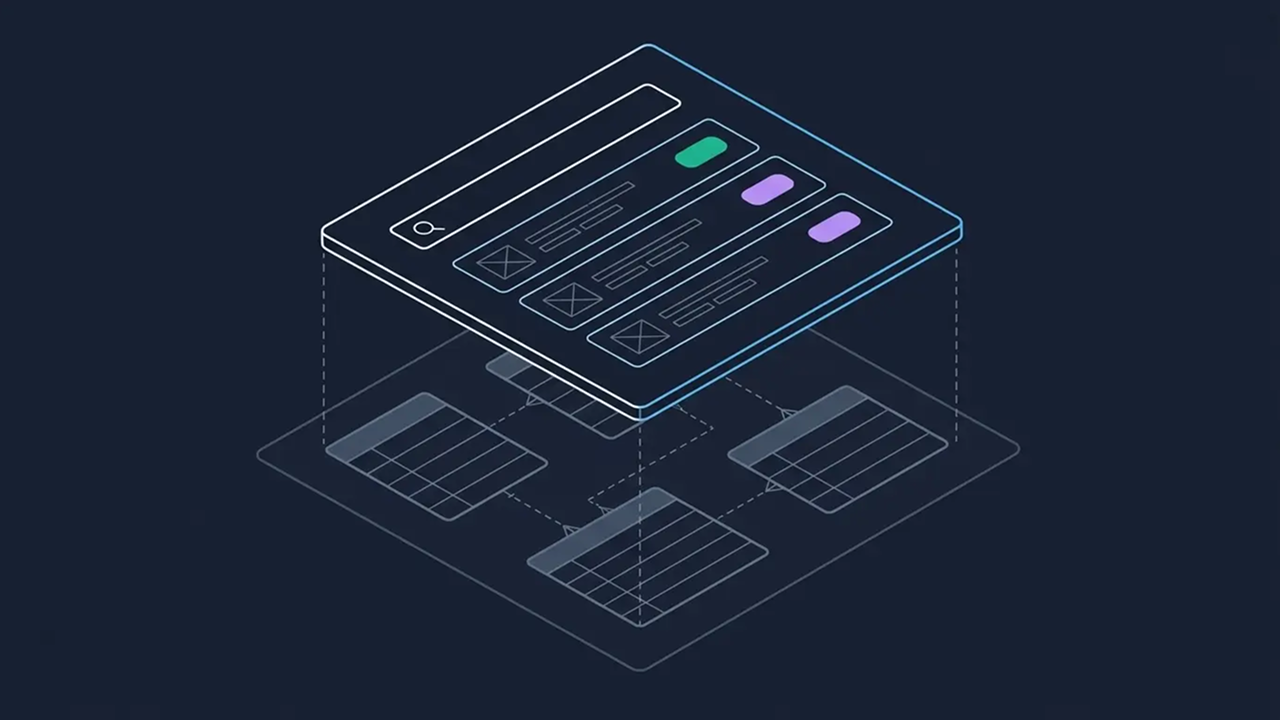
Postgres 안에서 본격적인 전문 검색을 할 수 있게 해 주는 ParadeDB가 '아직도 비정규화를 해야 하나요?'라는 제목의 글을 공개했어요. 검색 기능을 만들어 본 분이라면 이 질문이 왜 묵직한지 바로 아실 거예요. 검색 엔진을 붙이는 순간, 잘 나눠 놓은 테이블들을 하나의 커다란 문서로 뭉쳐야 했던 경험이 한 번쯤 있으니까요. ParadeDB의 주장은 간단해요. 스키마는 그대로 두고, JOIN을 걸어서 검색하자는 거예요.
비정규화가 뭐길래 문제일까요
용어부터 풀어 볼게요. 정규화는 같은 정보를 한 곳에만 저장하도록 테이블을 나누는 걸 말해요. 쇼핑몰이라면 상품, 판매자, 카테고리, 리뷰를 각각 다른 테이블에 두고 ID로 연결하는 식이죠. 판매자 이름이 바뀌어도 판매자 테이블 한 줄만 고치면 되니 데이터가 꼬일 일이 없어요.
비정규화는 그 반대예요. 읽기 편하라고 정보를 일부러 복사해 한 덩어리로 만들어요. Elasticsearch 같은 검색 엔진은 문서 하나하나를 독립적으로 색인하는 구조라서, 관계형 DB처럼 자유롭게 JOIN하기가 어려워요. 그래서 상품 문서 안에 판매자 이름, 카테고리 이름, 태그를 전부 집어넣는 게 사실상 표준이 됐어요.
문제는 그다음이에요. 판매자 이름 하나가 바뀌면 그 판매자의 상품 문서 수만 건을 다시 색인해야 해요. 원본 DB와 검색 엔진 사이에 데이터를 옮겨 주는 파이프라인도 따로 만들어 돌려야 하고, 그 사이 시간차 때문에 '방금 수정했는데 검색 결과에는 예전 값이 나와요' 같은 문의가 생겨요. 주소록을 수첩 여러 권에 베껴 적어 둔 상황과 비슷해요. 번호가 바뀔 때마다 수첩을 전부 찾아 고쳐야 하니까요.
ParadeDB는 어떻게 접근하나요
ParadeDB는 pg_search라는 Postgres 확장으로 동작해요. 테이블에 BM25 인덱스를 만들면 평소 쓰던 SQL 안에서 전문 검색을 할 수 있어요. BM25가 뭐냐면, 검색어가 문서에 얼마나 자주, 얼마나 의미 있게 등장하는지를 점수로 매기는 방식인데요, Elasticsearch가 기본으로 쓰는 관련도 계산법과 같은 계열이에요. 내부적으로는 Rust로 만든 검색 라이브러리 Tantivy를 사용해요.
데이터가 이미 Postgres 테이블에 있으니, 이론상으로는 WHERE description @@@ '키보드' 같은 검색 조건을 건 다음 판매자 테이블과 그냥 JOIN하면 끝이에요. 그런데 여기에 성능 함정이 있어요. 검색에서 가장 흔한 요청은 '관련도 높은 순으로 상위 10개만 주세요'인데, 단순하게 실행하면 DB는 조건에 맞는 행을 전부 찾고, 전부 JOIN하고, 전부 정렬한 뒤에야 10개를 잘라 내요. 100만 건이 걸리면 100만 건을 끝까지 끌고 다니는 거죠.
검색 엔진이 빠른 건 '어차피 상위 10개에 못 들 문서는 일찍 건너뛰는' 최적화 덕분인데, JOIN이 중간에 끼면 이 최적화가 끊어지기 쉬워요. ParadeDB가 풀려는 지점이 바로 여기예요. JOIN 자체를 검색 인덱스가 처리하는 영역으로 내려보내서(pushdown), 인덱스에 들어 있는 컬럼 데이터만으로 조인과 정렬을 먼저 끝내고 최종적으로 필요한 몇 건만 실제 테이블에서 꺼내 오는 방향이에요. 도서관에 비유하면, 책을 전부 책상에 쌓아 놓고 고르는 게 아니라 목록 카드만 보고 열 권을 정한 다음 그 책만 가져오는 거예요. 구현 세부 사항은 원문에서 직접 확인해 보시길 추천해요.
업계 흐름에서 보면
Elasticsearch도 손 놓고 있진 않았어요. nested 필드나 부모-자식 관계 기능이 있고, ES|QL이라는 질의 언어에는 LOOKUP JOIN도 추가됐어요. 하지만 제약 조건이 붙는 경우가 많아서 관계형 DB처럼 마음껏 JOIN하는 느낌과는 거리가 있어요. Typesense 같은 경량 검색 엔진도 컬렉션 간 참조 기능으로 비슷한 문제를 풀려 하고요.
반대편에는 Postgres 기본 전문 검색(tsvector와 GIN 인덱스)이 있어요. JOIN은 당연히 되지만 BM25 같은 정교한 관련도 점수가 없고, 결과가 많아지면 순위 매기기가 느려지는 약점이 있어요. ParadeDB는 이 둘 사이에서 '검색 엔진의 품질'과 '관계형 DB의 스키마'를 한 곳에서 잡겠다는 위치예요. 벡터 검색을 pgvector로 Postgres 안에서 해결하는 흐름과 같은 맥락이죠. 별도 시스템이 하나 줄면 동기화 파이프라인, 장애 지점, 운영 부담이 같이 줄어드니까요.
한국 개발자에게 주는 시사점
먼저 한글 검색이 궁금하실 텐데요, ParadeDB는 Lindera 기반의 한국어 토크나이저를 지원해요. Elasticsearch에서 nori가 하던 역할이에요. 다만 사전 품질이나 사용자 사전 관리 방식은 다를 수 있으니, 실제 서비스 데이터로 검색 품질을 꼭 비교해 보세요.
두 번째는 배포 환경이에요. pg_search는 확장 프로그램이라, 확장 설치가 제한된 관리형 DB 서비스에서는 바로 쓸 수 없는 경우가 있어요. 이럴 땐 ParadeDB를 별도 인스턴스로 띄우고 운영 DB에서 논리 복제로 데이터를 받아 오는 구성을 써요. 커뮤니티 버전 라이선스가 AGPL이라는 점도 회사에서 도입하기 전에 검토가 필요한 부분이에요.
판단 기준을 하나 드리자면, 이미 Postgres를 쓰고 있고 검색용 동기화 파이프라인 유지보수에 지친 팀이라면 검토해 볼 가치가 충분해요. 반대로 로그 분석처럼 Elasticsearch 생태계 도구에 깊이 의존하고 있다면 당장 갈아탈 이유는 크지 않아요.
마무리
한 줄로 정리하면, '검색하려면 데이터를 복사해서 뭉쳐야 한다'는 오랜 전제가, 검색이 DB 안으로 들어오면서 흔들리고 있어요. 여러분 서비스에서는 검색용 데이터를 어떻게 동기화하고 계신가요? 그 파이프라인이 사라진다면 뭐가 가장 먼저 편해질까요?
🔗 출처: Hacker News