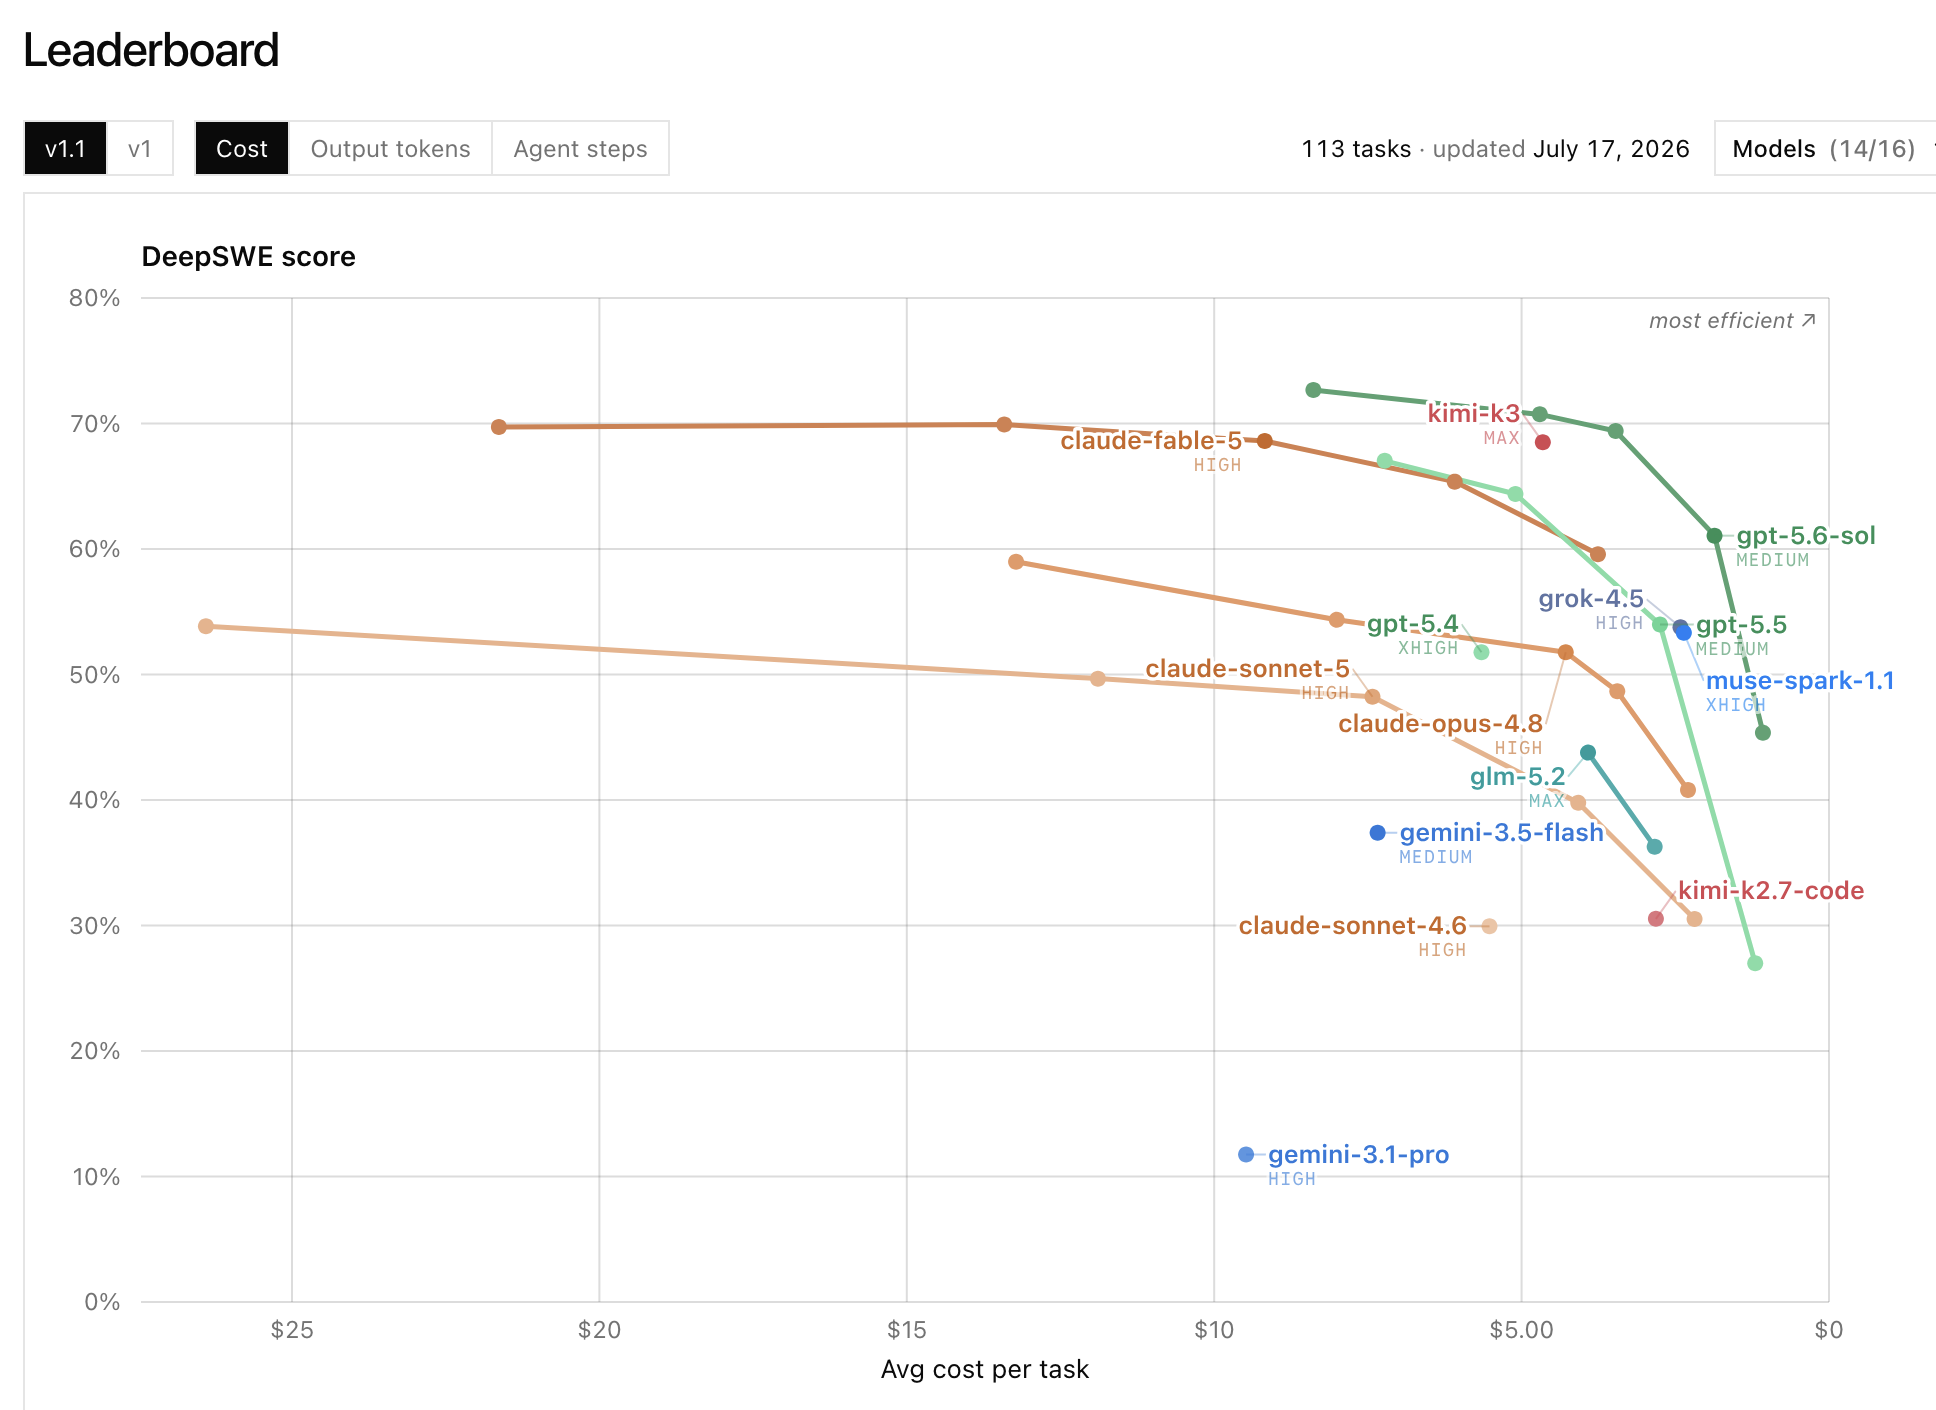
벤치마크 1등이 실제 1등이 아닐 때
요즘 AI 코딩 도구 뉴스를 보면 꼭 따라붙는 숫자가 있어요. "SWE-Bench에서 몇 퍼센트 달성" 같은 거요. 그런데 이 숫자를 보고 "오, 이제 시니어 개발자 수준이네" 하고 믿어도 될까요? 시스템 성능과 측정의 함정에 대해 오랫동안 글을 써온 Dan Luu가 이번 글에서 바로 이 질문을 던졌어요. 제목에 등장하는 세 가지 키워드, 그러니까 '시니어 SWE-Bench', '냅킨 계산', 그리고 '겨울 타이어'가 각각 나쁜 벤치마크의 다른 얼굴을 보여주거든요.
SWE-Bench가 뭐냐면
먼저 SWE-Bench부터 짚고 갈게요. 이게 뭐냐면, 깃허브에 실제로 올라온 이슈와 그걸 고친 풀리퀘스트를 모아놓은 문제집이에요. AI 모델한테 이슈 설명을 주고 "이거 고쳐봐" 하면, 모델이 코드를 수정하고, 그 수정본이 원래 테스트를 통과하는지로 채점하는 방식이에요. 실제 프로젝트 코드를 쓰니까 장난감 문제보다 훨씬 현실적이라는 평가를 받았고, 그래서 코딩 AI의 표준 성적표처럼 자리 잡았죠.
문제는 '표준 성적표'가 되는 순간 생겨요. 모든 회사가 이 점수를 올리려고 최적화를 하기 시작하거든요. 문제집이 공개되어 있으니 학습 데이터에 섞여 들어가기도 하고(이걸 데이터 오염이라고 불러요), 테스트 케이스만 통과하면 되니까 실제로는 엉뚱한 방식으로 고쳐도 정답 처리가 되기도 해요. 그리고 '시니어 수준'이라는 이름을 붙인 변형 벤치마크가 나온다고 해서, 시니어 개발자가 실제로 하는 일이 거기 담기는 건 아니에요. 시니어의 진짜 가치는 이슈 하나를 고치는 게 아니라 "이 이슈를 고치는 게 맞는지", "이 설계가 6개월 뒤에 어떤 문제를 만들지"를 판단하는 데 있는데, 그건 테스트 통과 여부로 채점할 수가 없거든요. 벤치마크는 측정하기 쉬운 걸 측정하지, 중요한 걸 측정하는 게 아니라는 거예요.
냅킨 계산: 숫자를 믿기 전에 한 번만 따져보기
두 번째 키워드인 냅킨 계산은 Dan Luu가 오랫동안 강조해온 습관이에요. 이게 뭐냐면, 정밀한 계산 없이 대략적인 숫자 몇 개만으로 "이게 말이 되는 결과인가"를 검산해보는 거예요. 냅킨 뒷면에 끄적일 정도로 간단해서 그런 이름이 붙었죠.
벤치마크 결과에 이걸 적용하면 의외로 많은 게 걸러져요. 예를 들어 어떤 도구가 "개발 생산성 10배 향상"이라고 하면, 이렇게 따져볼 수 있어요. 개발자가 하루 8시간 중 실제로 코드를 타이핑하는 시간이 얼마나 될까요? 회의, 코드 리뷰, 요구사항 파악, 디버깅을 빼면 순수 코딩은 두세 시간 남짓이에요. 그 두세 시간을 0으로 만들어도 하루 전체 생산성은 기껏해야 1.5배 정도밖에 안 오르죠. 그러면 10배라는 숫자는 뭔가를 아주 좁게 측정했거나, 측정 자체가 잘못됐다는 뜻이에요. 이런 식으로 결과를 받아들이기 전에 상한선을 먼저 그어보는 습관이 냅킨 계산의 핵심이에요.
겨울 타이어: 측정 조건이 곧 결과다
세 번째 비유가 제일 재밌어요. 타이어 성능 시험을 생각해보세요. 여름철 마른 아스팔트에서 제동 거리를 재면 특정 타이어가 1등을 해요. 그런데 그 타이어를 눈 쌓인 강원도 고갯길에서 쓰면 어떨까요? 순위가 완전히 뒤집히죠. 벤치마크 결과가 틀린 게 아니에요. 다만 그 결과는 '그 조건에서만' 유효한 거예요.
소프트웨어 벤치마크도 똑같아요. 깨끗하게 정리된 파이썬 오픈소스 저장소에서 잘 작동하는 AI가, 10년 묵은 자바 레거시 코드에 한국어 주석과 사내 전용 프레임워크가 섞인 환경에서도 똑같이 잘할까요? 아무도 보장 못 해요. 그런데 우리는 여름 타이어 성적표를 들고 겨울 산길에 올라가면서 "벤치마크에서 1등이었는데" 하고 놀라곤 하죠.
업계에서 벌어지는 일
이건 AI만의 문제가 아니에요. CPU 벤치마크에서 특정 테스트만 감지해서 클럭을 올리는 꼼수는 수십 년 된 이야기고, 데이터베이스 업계에도 TPC 벤치마크를 위한 전용 튜닝이 따로 있을 정도예요. 다만 AI 쪽은 투자 규모가 워낙 크고 점수 하나가 기업 가치에 직결되다 보니 왜곡의 유인이 훨씬 세요. 그래서 최근에는 문제를 비공개로 유지하는 벤치마크, 실제 업무 환경을 흉내 낸 장기 과제형 평가, 사람이 직접 비교 평가하는 아레나 방식 등이 대안으로 나오고 있지만, 어느 것도 완벽하진 않아요.
한국 개발자에게 주는 시사점
실무에서 도구를 고를 때 벤치마크 숫자는 참고만 하고, 우리 팀 코드베이스에서 직접 돌려보는 게 답이에요. 작은 규모라도 '우리 프로젝트 전용 벤치마크'를 만들어두면, 새 모델이 나올 때마다 광고 문구에 휘둘리지 않고 판단할 수 있어요. 그리고 성능 보고서를 읽을 땐 항상 세 가지를 물어보세요. 무엇을 측정했는가, 어떤 조건에서 측정했는가, 냅킨 계산으로 검산해봤을 때 말이 되는가.
마무리
한 줄로 정리하면 이래요. 벤치마크는 거짓말을 하지 않지만, 우리가 벤치마크에 묻지 않은 질문에 대해선 아무 대답도 해주지 않아요.
여러분 팀은 AI 도구를 도입할 때 뭘 기준으로 판단하시나요? 직접 평가 세트를 만들어본 경험이 있다면 어떤 방식이 효과적이었는지 공유해주세요.
🔗 출처: Hacker News