무슨 일이 있었나요
OpenAI가 로보틱스 전담 팀을 해체했다고 미국 경제지 Fortune이 보도했어요. 흥미로운 건 타이밍인데요, 보도에 따르면 OpenAI의 범용 AI 모델이 로봇을 직접 구동하기 시작한 시점에 전담 팀이 사라졌다는 거예요. 로봇을 포기했다기보다, 로봇만을 위한 별도 조직을 둘 이유가 줄었다는 신호로 읽히죠. 인력 재배치 같은 세부 내용은 보도 원문을 참고하시고, 여기서는 이 결정이 왜 상징적인지 로봇 AI의 큰 흐름 안에서 풀어볼게요.
사실 이번이 처음이 아니에요
OpenAI와 로봇의 인연은 꽤 오래됐어요. 2018년에는 로봇 손이 정육면체를 손가락으로 굴리는 Dactyl을, 2019년에는 한 손으로 루빅스 큐브를 맞추는 데모를 공개해서 화제가 됐죠. 그런데 2021년에 이 팀을 한 번 해체했어요. 당시 공동창업자 보이치에흐 자렘바가 밝힌 이유는 '데이터'였어요. 텍스트는 인터넷에 무한히 쌓여 있는데 로봇이 물건을 집고 옮기는 데이터는 직접 로봇을 굴려서 모아야 하니, 같은 노력을 들였을 때 진전이 더딘 분야였던 거죠.
그러다 휴머노이드 붐이 일면서 2024년 무렵 팀을 다시 꾸렸어요. 메타에서 AR 하드웨어를 이끌던 케이틀린 칼리노프스키를 영입했고, 센서와 구동기 같은 하드웨어 직군 채용 공고도 냈죠. Figure, 1X, Physical Intelligence 같은 로봇 스타트업에 투자도 했고요. 그러니까 이번 해체는 '만들었다 접었다'를 한 바퀴 더 돈 셈인데, 보도대로라면 2021년과는 이유가 정반대라는 점이 핵심이에요. 그때는 '아직 안 돼서'였고, 지금은 '따로 안 해도 돼서'에 가까우니까요.
범용 모델이 로봇을 움직인다는 게 뭐냐면
예전 로봇 소프트웨어는 분업 구조였어요. 카메라 영상에서 물체를 찾는 인식 모듈, 어떻게 움직일지 짜는 계획 모듈, 모터를 돌리는 제어 모듈을 따로 만들고 사람이 이어 붙였죠. 요즘 방식은 달라요. VLA(Vision-Language-Action) 모델이라고 부르는데, 이게 뭐냐면 챗봇이 다음 단어를 예측하듯이 로봇의 '다음 동작'을 예측하는 모델이에요. 카메라 화면과 '식탁 위 컵을 싱크대에 넣어줘' 같은 문장을 넣으면, 답으로 글자가 아니라 팔 관절을 얼마나 움직일지가 나오는 거죠.
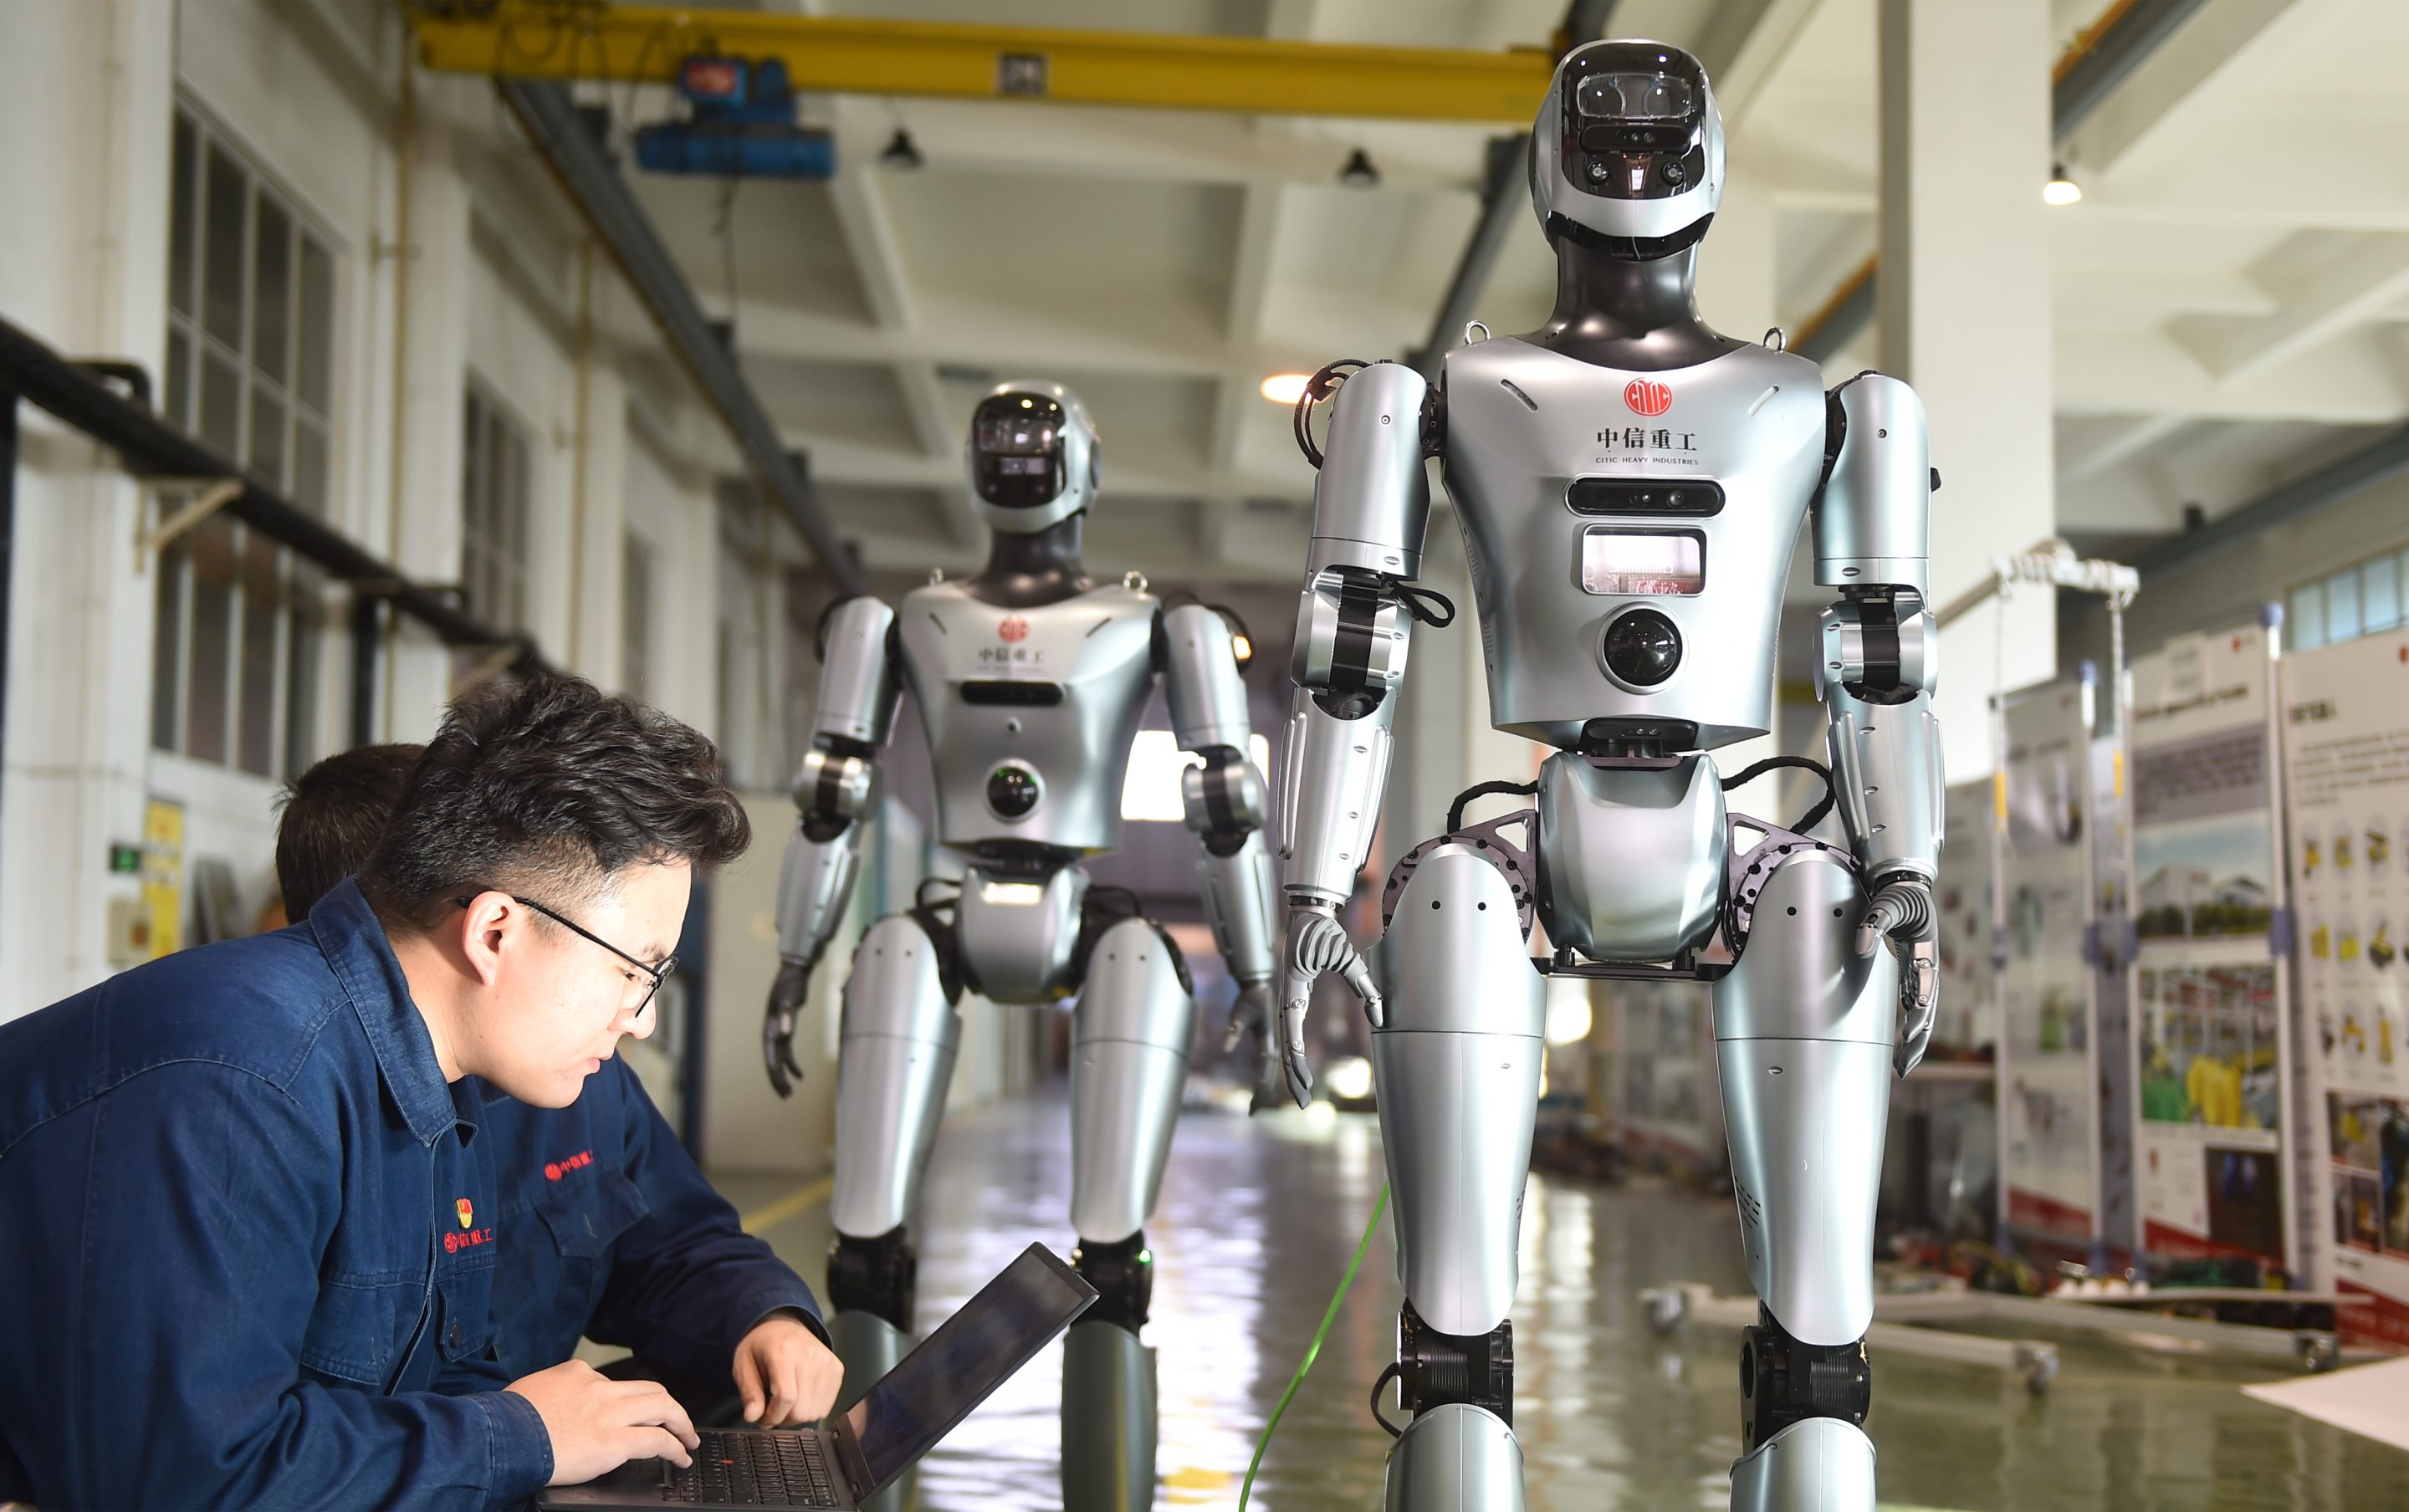
여기서 중요한 포인트는 이 모델의 몸통이 로봇 전용이 아니라는 거예요. 인터넷의 글과 영상으로 세상 지식을 배운 거대 모델에 '동작'이라는 출력을 하나 더 얹은 구조거든요. 그래서 한 번도 본 적 없는 물건이라도 '공룡 인형 집어줘'라고 하면 알아듣고 집을 수 있어요. 공룡이 뭔지는 이미 알고 있으니까요. 이 구조에서는 기반 모델이 똑똑해질수록 로봇도 덩달아 똑똑해져요. 로봇 팀을 따로 두기보다 본진 모델 팀이 로봇까지 맡는 게 자연스러워지는 이유예요.
업계 흐름: 모두가 같은 방향, 다른 전략
이 흐름은 OpenAI만의 것이 아니에요. 구글 딥마인드는 2023년 RT-2로 VLA 개념을 본격화했고, 2025년에는 제미나이 위에 로봇 제어를 얹은 Gemini Robotics를 내놨어요. 엔비디아는 휴머노이드용 기반 모델 GR00T를 공개했고, Physical Intelligence는 π0라는 범용 로봇 모델로 빨래 개기 같은 집안일 데모를 보여줬죠. OpenAI와 협업하던 Figure는 2025년 초 협력을 끝내고 자체 모델 Helix로 돌아섰고요.
회사마다 갈리는 지점은 '몸을 직접 만드느냐'예요. 테슬라와 Figure는 로봇 하드웨어부터 모델까지 수직 통합하는 길을, 구글과 엔비디아는 여러 로봇 회사에 두뇌를 공급하는 플랫폼의 길을 가고 있어요. 전담 팀을 없앴다는 이번 소식은 OpenAI가 후자, 즉 '두뇌 공급자' 쪽에 무게를 싣는 신호로 해석할 여지가 있어요. 다만 낙관만 할 일은 아니에요. 거대 모델은 응답이 느려서 초당 수백 번 돌아야 하는 모터 제어를 그대로 맡기기 어렵고, 그래서 '천천히 생각하는 큰 모델'과 '빠르게 반응하는 작은 모델'을 나눠 쓰는 설계가 일반적이에요. 실제 현장 데이터가 부족하다는 2021년의 숙제도 완전히 풀린 건 아니고요.
한국 개발자에게 주는 시사점
한국은 이 변화의 영향권 한가운데 있어요. 현대차그룹은 보스턴다이내믹스를, 삼성전자는 레인보우로보틱스를 품었고, 제조업 현장의 로봇 밀도는 세계 최고 수준이니까요. 하드웨어를 잘 만드는 나라일수록 '두뇌는 누구 걸 쓸 것인가'라는 질문이 무거워져요. 스마트폰 시절 안드로이드가 그랬듯, 범용 모델을 쥔 회사가 로봇의 운영체제 자리를 가져갈 수 있거든요.
개인 개발자 입장에서는 진입 장벽이 낮아졌다는 게 기회예요. 예전에는 로봇을 하려면 제어공학과 기구학부터 파야 했지만, 이제는 웹 개발자가 LLM API를 다루듯 모델을 미세조정하고 데이터 파이프라인을 짜는 역량이 핵심이 되고 있어요. 허깅페이스의 LeRobot 프로젝트를 쓰면 수십만 원대 로봇 팔로 직접 시연 데이터를 모아 모델을 학습시켜볼 수 있고, OpenVLA나 π0처럼 가중치가 공개된 모델도 있어요. 실물 로봇이 없어도 MuJoCo나 Isaac Sim 같은 시뮬레이터로 시작할 수 있고요.
마무리
한 줄로 정리하면, 로봇이 '별도의 연구 분야'에서 '범용 모델의 또 하나의 출력 장치'로 바뀌고 있다는 신호예요. 여러분은 로봇의 두뇌가 스마트폰 OS처럼 소수의 범용 모델로 수렴할 거라고 보시나요, 아니면 공장·물류·가정처럼 현장마다 특화된 모델이 살아남을 거라고 보시나요?
🔗 출처: Hacker News