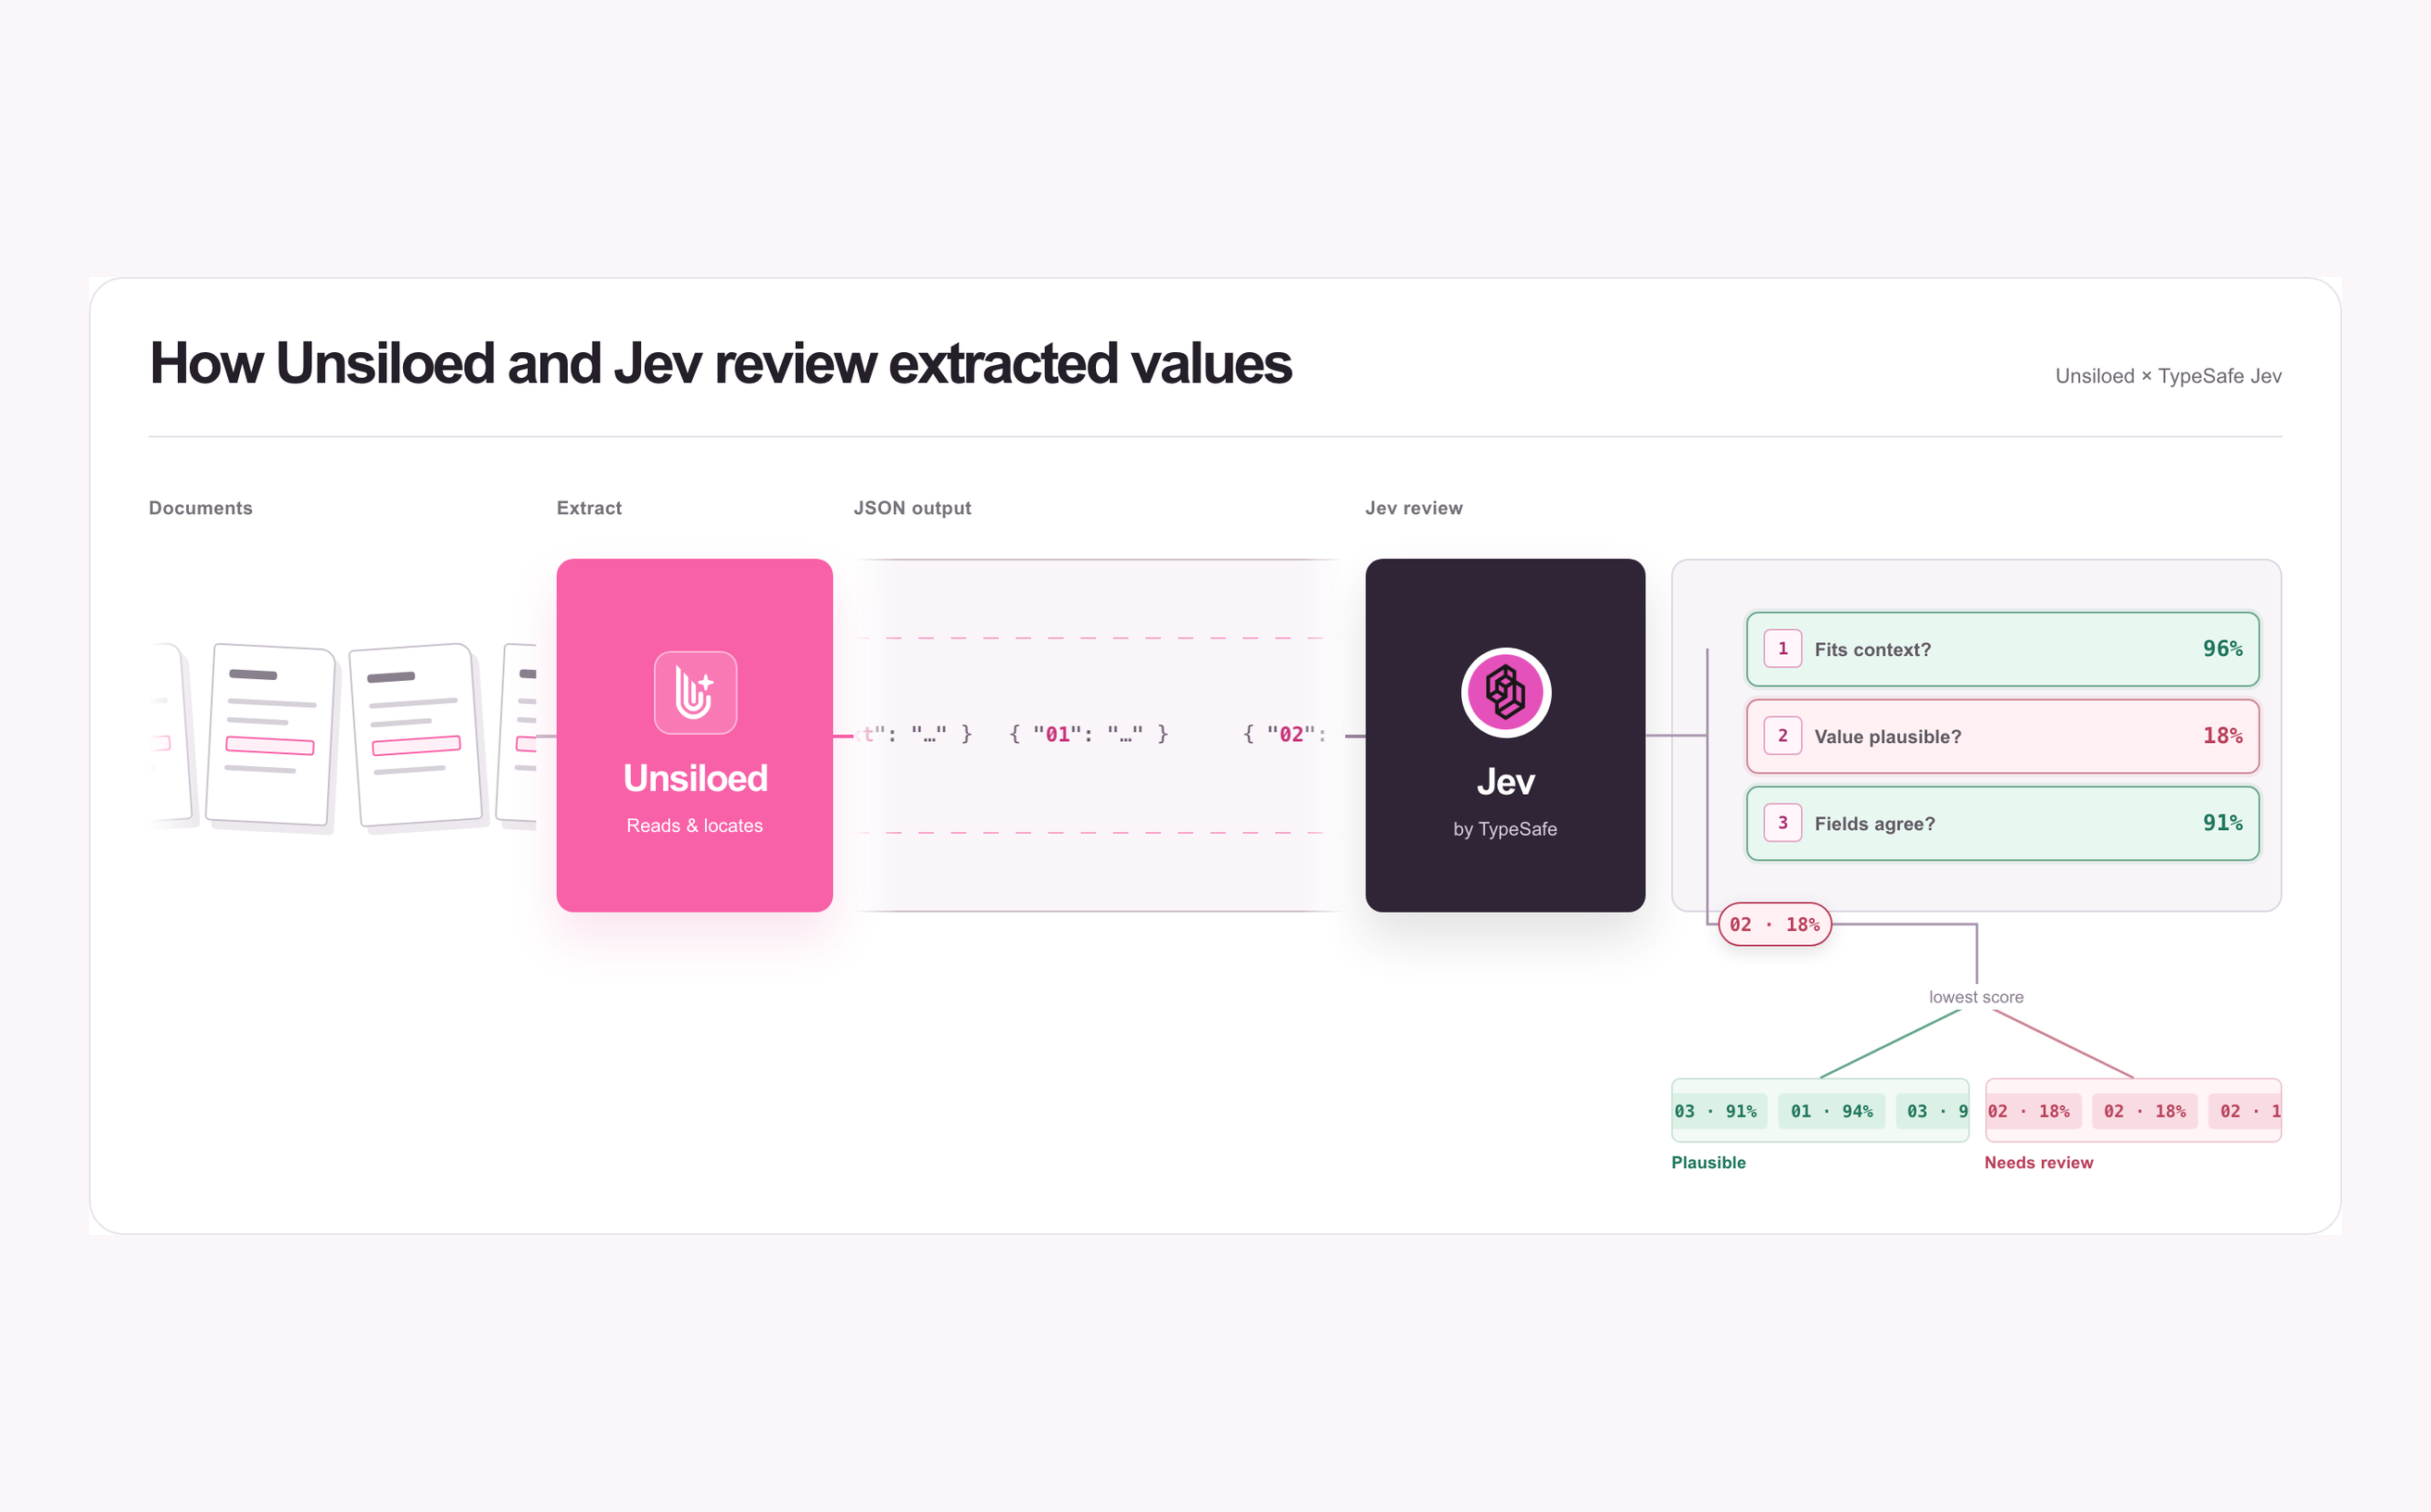
문서 자동화의 숨은 함정은 글자를 틀리게 읽는 데만 있지 않다. 추출 파이프라인이 값을 정확히 읽고도 잘못된 데이터를 하류로 넘길 수 있다. 예컨대 또렷하게 인쇄된 '0' 하나가 더 붙어 있어도 우수한 광학 문자 인식(OCR)은 그 글자를 완벽하게 읽어낸다. 읽기는 성공했지만 값 자체가 비현실적인 것이다. 이 글이 소개하는 접근은 문서 추출 도구 Unsiloed와 TypeSafe의 판정 엔진 Jev를 결합해, '잘못 읽은 경우'와 '제대로 읽었지만 말이 안 되는 경우'를 각각 다른 방식으로 걸러낸다.
추출과 판정을 분리하다
Unsiloed는 문서에서 구조화된 필드를 추출하고 그 값이 페이지의 어디에 있는지까지 지정한다. 각 필드에는 두 가지 신뢰도 점수가 붙는데, extraction_score는 추출한 값 자체에 대한 확신을, grounding_score는 그 값을 문서 안에서 제대로 찾아냈는지에 대한 확신을 나타낸다. 둘 다 0에서 1 사이이며, 인용(citation)은 페이지 번호와 원문 텍스트를 둘러싼 바운딩 박스 좌표를 함께 제공한다. 추출 스키마는 수량과 단위를 포함한 복용량 셀 전체를 요구하되, 놀라운 수량을 임의로 교정하거나 가려진 글자를 일반적 처방 관행으로 추측하지 않도록 지시한다. 즉 인쇄된 그대로를 보존한다.
Jev는 여기서 역할이 다르다. Jev 요청은 '고려하는 정보'(state)와 '내리는 판단'(questions)을 분리한다. state에는 Unsiloed가 추출한 레코드와 해석에 필요한 맥락이 들어가고, 각 question은 무엇을 확인할지와 어떤 답 유형을 돌려줄지를 지정한다. 답 유형은 세 가지다. Noul은 어떤 진술이 참일 확률을 반환하고, Choice는 명명된 선택지 중 하나를 고르며, Score는 순서가 있는 등급 루브릭으로 평가한다. Choice와 Score는 확률 분포와 그 집중도를 요약한 신뢰도 값을 함께 주지만, Noul에는 별도의 신뢰도 필드가 없다.
0.04는 '4% 확신'이 아니다
값의 해석을 오해하면 전체 설계가 무너진다. Noul 값 0.04는 질문에 대해 '예'일 확률이 4%라는 뜻, 즉 강한 '아니오'다. 'Jev가 4%만 확신한다'는 의미가 결코 아니다. 양 끝에 가까운 값은 방향이 분명하다는 신호이고, 가운데에 가까운 값일수록 주의해서 다뤄야 한다. 이 차이를 알아야 뒤의 임계값 설계가 성립한다.
여섯 줄 처방전으로 본 실제 동작
예시는 여섯 행짜리 약품 목록이다. 한 행은 커피 얼룩이 복용량을 가렸고, 다른 한 행은 또렷하게 인쇄됐지만 수량이 비현실적이다. enable_citations=true로 인용을 켠 뒤 추출 작업이 끝나기를 기다려 Jev의 state를 구성한다. 각 행에는 row-5 같은 ID를 부여해 추출 필드·인용과 함께 보관하고, 나중에 Jev의 답과 같은 행을 맞춘다. Jev에는 추출된 값과 맥락만 보내며, Jev는 이미지나 Unsiloed 점수를 보지 않은 채 '이 약에 이 복용량과 빈도가 타당한가'를 행마다 하나의 Noul 질문으로 독립 평가한다. 여섯 행이 한 요청을 공유하고, 요청은 서버에서 TypeSafe API 키를 Bearer 헤더에 담아 https://api.typesafe.ai/v1/systemone 으로 JSON 전송한다. 질문 ID 자체는 모델에 전달되지 않으므로, 어떤 레코드를 판정할지는 instructions 안에 row_id로 따로 넣어준다.
검수 여부를 가르는 규칙은 단순하다. 읽기 점검은 한 행의 필드 중 가장 낮은 Unsiloed 점수를 쓰고, 타당성 점검은 Jev의 noul 값을 쓴다. 이 데모에서는 읽기 점수가 0.90 미만이거나 타당성이 0.50 미만이면 검수로 보낸다. 핵심 원칙은 둘을 상쇄시키지 않는 것이다. 타당해 보이는 지시에도 잘못 읽은 글자가 숨어 있을 수 있으므로, 높은 Jev 값이 낮은 Unsiloed 점수를 덮어써서는 안 된다. 두 점검이 모두 걸리면 두 사유를 모두 남기고, 원본 추출과 Jev 요청·응답을 검수자의 결정과 함께 저장해 두어야 왜 걸렸고 어떻게 해결됐는지 되짚을 수 있다.
두 문제 행이 서로 다른 이유로 걸린다는 점이 이 설계의 핵심이다. 얼룩진 세티리진 행은 Unsiloed가 '1 tablet'을 추출(extraction 0.74, grounding 0.76)했고 Jev는 타당성 0.94를 돌려줬다. 그러나 Jev는 얼룩을 본 적이 없으므로 그 판정은 추출된 텍스트가 옳다는 전제에 의존한다. 가려진 표식을 사람이 확인해야 하므로 읽기 점검이 이 행을 잡아낸다. 반대로 이부프로펜 행은 '10 tablets, three times daily'를 두 점수 모두 0.99로 또렷하게 읽었지만 Jev가 같은 질문에 0.04를 반환했다. 어느 모델도 의도된 복용량을 멋대로 대체하지 않는다. 한 점검이 놓치는 것을 다른 점검이 잡는 구조다. 다만 임계값 0.90과 0.50은 예시일 뿐이며, 0.50 부근 답은 어느 쪽도 분명치 않아 역시 검수 대상이 될 수 있으므로 운영 투입 전 수작업 검토 문서로 반드시 보정해야 한다.
비용과 남는 질문
비용 감각도 공개됐다. 이 데모의 약품 목록 하나는 여섯 질문·1,812 입력 토큰을 만들었고, Jev 1.13.0의 공시 단가인 입력 10억 토큰당 42달러(출력 무료, 2026년 9월 30일 확인) 기준으로 문서당 약 0.000076달러가 추가된다. 유사 문서 10만 건이면 Jev 요금은 약 7.61달러다. 다만 이는 Jev만의 추정치로, Unsiloed 추출과 사람 검수 비용은 별도이며 실제 요금은 보내는 텍스트와 질문에 따라 달라진다. 정확한 추정은 대표 응답의 input_tokens에 공시 단가를 곱해 구하라는 것이 원문의 권고다. 결국 이 사례가 보여주는 실무적 교훈은 명확하다. OCR 신뢰도와 '말이 되는가'라는 판단은 서로 다른 축이며, 둘을 분리해 측정하고 상쇄하지 않을 때라야 자동 추출이 사람 검수로 올릴 행을 믿을 만하게 추려낼 수 있다.