무슨 일이 있었나요?
중국 상하이에 본사를 둔 AI 기업 MiniMax가 새 언어 모델 M3.1 Flash를 공개했어요. 이름에 'Flash'가 붙었으니 짐작하셨겠지만, 플래그십 모델의 능력을 최대한 지키면서 더 빠르고 더 싸게 돌아가도록 만든 경량 버전이에요. 구글 Gemini Flash, Anthropic Haiku, OpenAI mini 계열이 맡고 있는 바로 그 자리죠.
'작은 모델 하나 더 나온 것뿐 아니야?' 싶을 수도 있어요. 그런데 요즘 흐름을 보면 이런 모델이 생각보다 훨씬 중요해지고 있거든요. 코딩 에이전트가 일 하나를 처리하면서 모델을 몇 번 부르는지 떠올려 보세요. 파일 읽고, 검색하고, 코드 고치고, 테스트 돌리고, 결과를 보고 다시 고치고… 작업 하나에 수십에서 수백 번씩 호출하는 게 보통이에요. 그런데 호출할 때마다 몇 초씩 걸리고 비용도 비싸다면 에이전트는 느리고 비싼 장난감이 돼버려요. 그래서 요즘은 '가장 똑똑한 모델' 못지않게 '충분히 똑똑하면서 빠르고 싼 모델'이 중요해졌어요.
MiniMax는 어떤 회사인가요?
국내에서는 아직 낯선 이름일 수 있는데요, 영상 생성 서비스 하이뤄(Hailuo)와 캐릭터 대화 앱 Talkie로 먼저 알려진 회사예요. 언어 모델 쪽에서도 꽤 독특한 길을 걸어왔어요.
2025년 초에 나온 MiniMax-01은 라이트닝 어텐션이라는 선형 어텐션 계열 기법을 대거 넣어서, 수백만 토큰짜리 긴 문맥도 처리할 수 있게 만들었어요. 어텐션이 뭐냐면, 모델이 글을 읽을 때 '이 단어를 이해하려면 앞에 나온 어떤 단어들을 참고해야 하지?'를 계산하는 과정이에요. 일반적인 방식은 모든 단어 쌍을 일일이 비교해서, 글이 두 배 길어지면 계산량은 네 배로 늘거든요. 선형 어텐션은 이걸 글 길이에 비례하는 수준까지 줄여 보려는 시도예요.
재미있는 건 코딩과 에이전트에 집중한 후속작 M2에서는 다시 전통적인 풀 어텐션으로 돌아갔다는 점이에요. 효율은 좋았지만 실제로 복잡한 작업을 시켜 보니 품질에서 손해가 있다고 판단한 거죠. 이런 시행착오를 공개적으로 공유해 온 회사라서, 새 모델이 나올 때마다 '이번엔 어떤 선택을 했을까?' 지켜보는 재미가 있어요.
Flash 모델은 어떻게 빨라질까요?
경량 모델을 만드는 대표적인 방법 두 가지만 알아 두면 이런 발표를 훨씬 쉽게 읽을 수 있어요.
첫째는 MoE(Mixture of Experts, 전문가 혼합) 구조예요. 큰 종합병원을 떠올리면 쉬워요. 병원에 의사가 수백 명 있어도 환자 한 명은 증상에 맞는 몇 명에게만 진료를 받잖아요. MoE 모델도 전체 파라미터는 아주 크지만, 토큰 하나를 처리할 때는 그중 일부 '전문가'만 깨워서 써요. 그래서 발표 자료를 보면 '총 파라미터'와 '활성 파라미터'가 따로 적혀 있는데, 실제 속도와 비용을 좌우하는 건 활성 파라미터 쪽이에요. 전작 M2만 해도 총 2천억 개가 넘는 파라미터 가운데 토큰마다 약 100억 개만 쓰는 구조였어요.
둘째는 증류(distillation)예요. 큰 선생님 모델이 문제를 푸는 방식을 작은 학생 모델이 따라 배우게 하는 기법이에요. 학생은 몸집이 작아서 빠른데, 선생님의 노하우를 물려받았으니 같은 크기 모델을 처음부터 학습시킨 것보다 똑똑해져요.
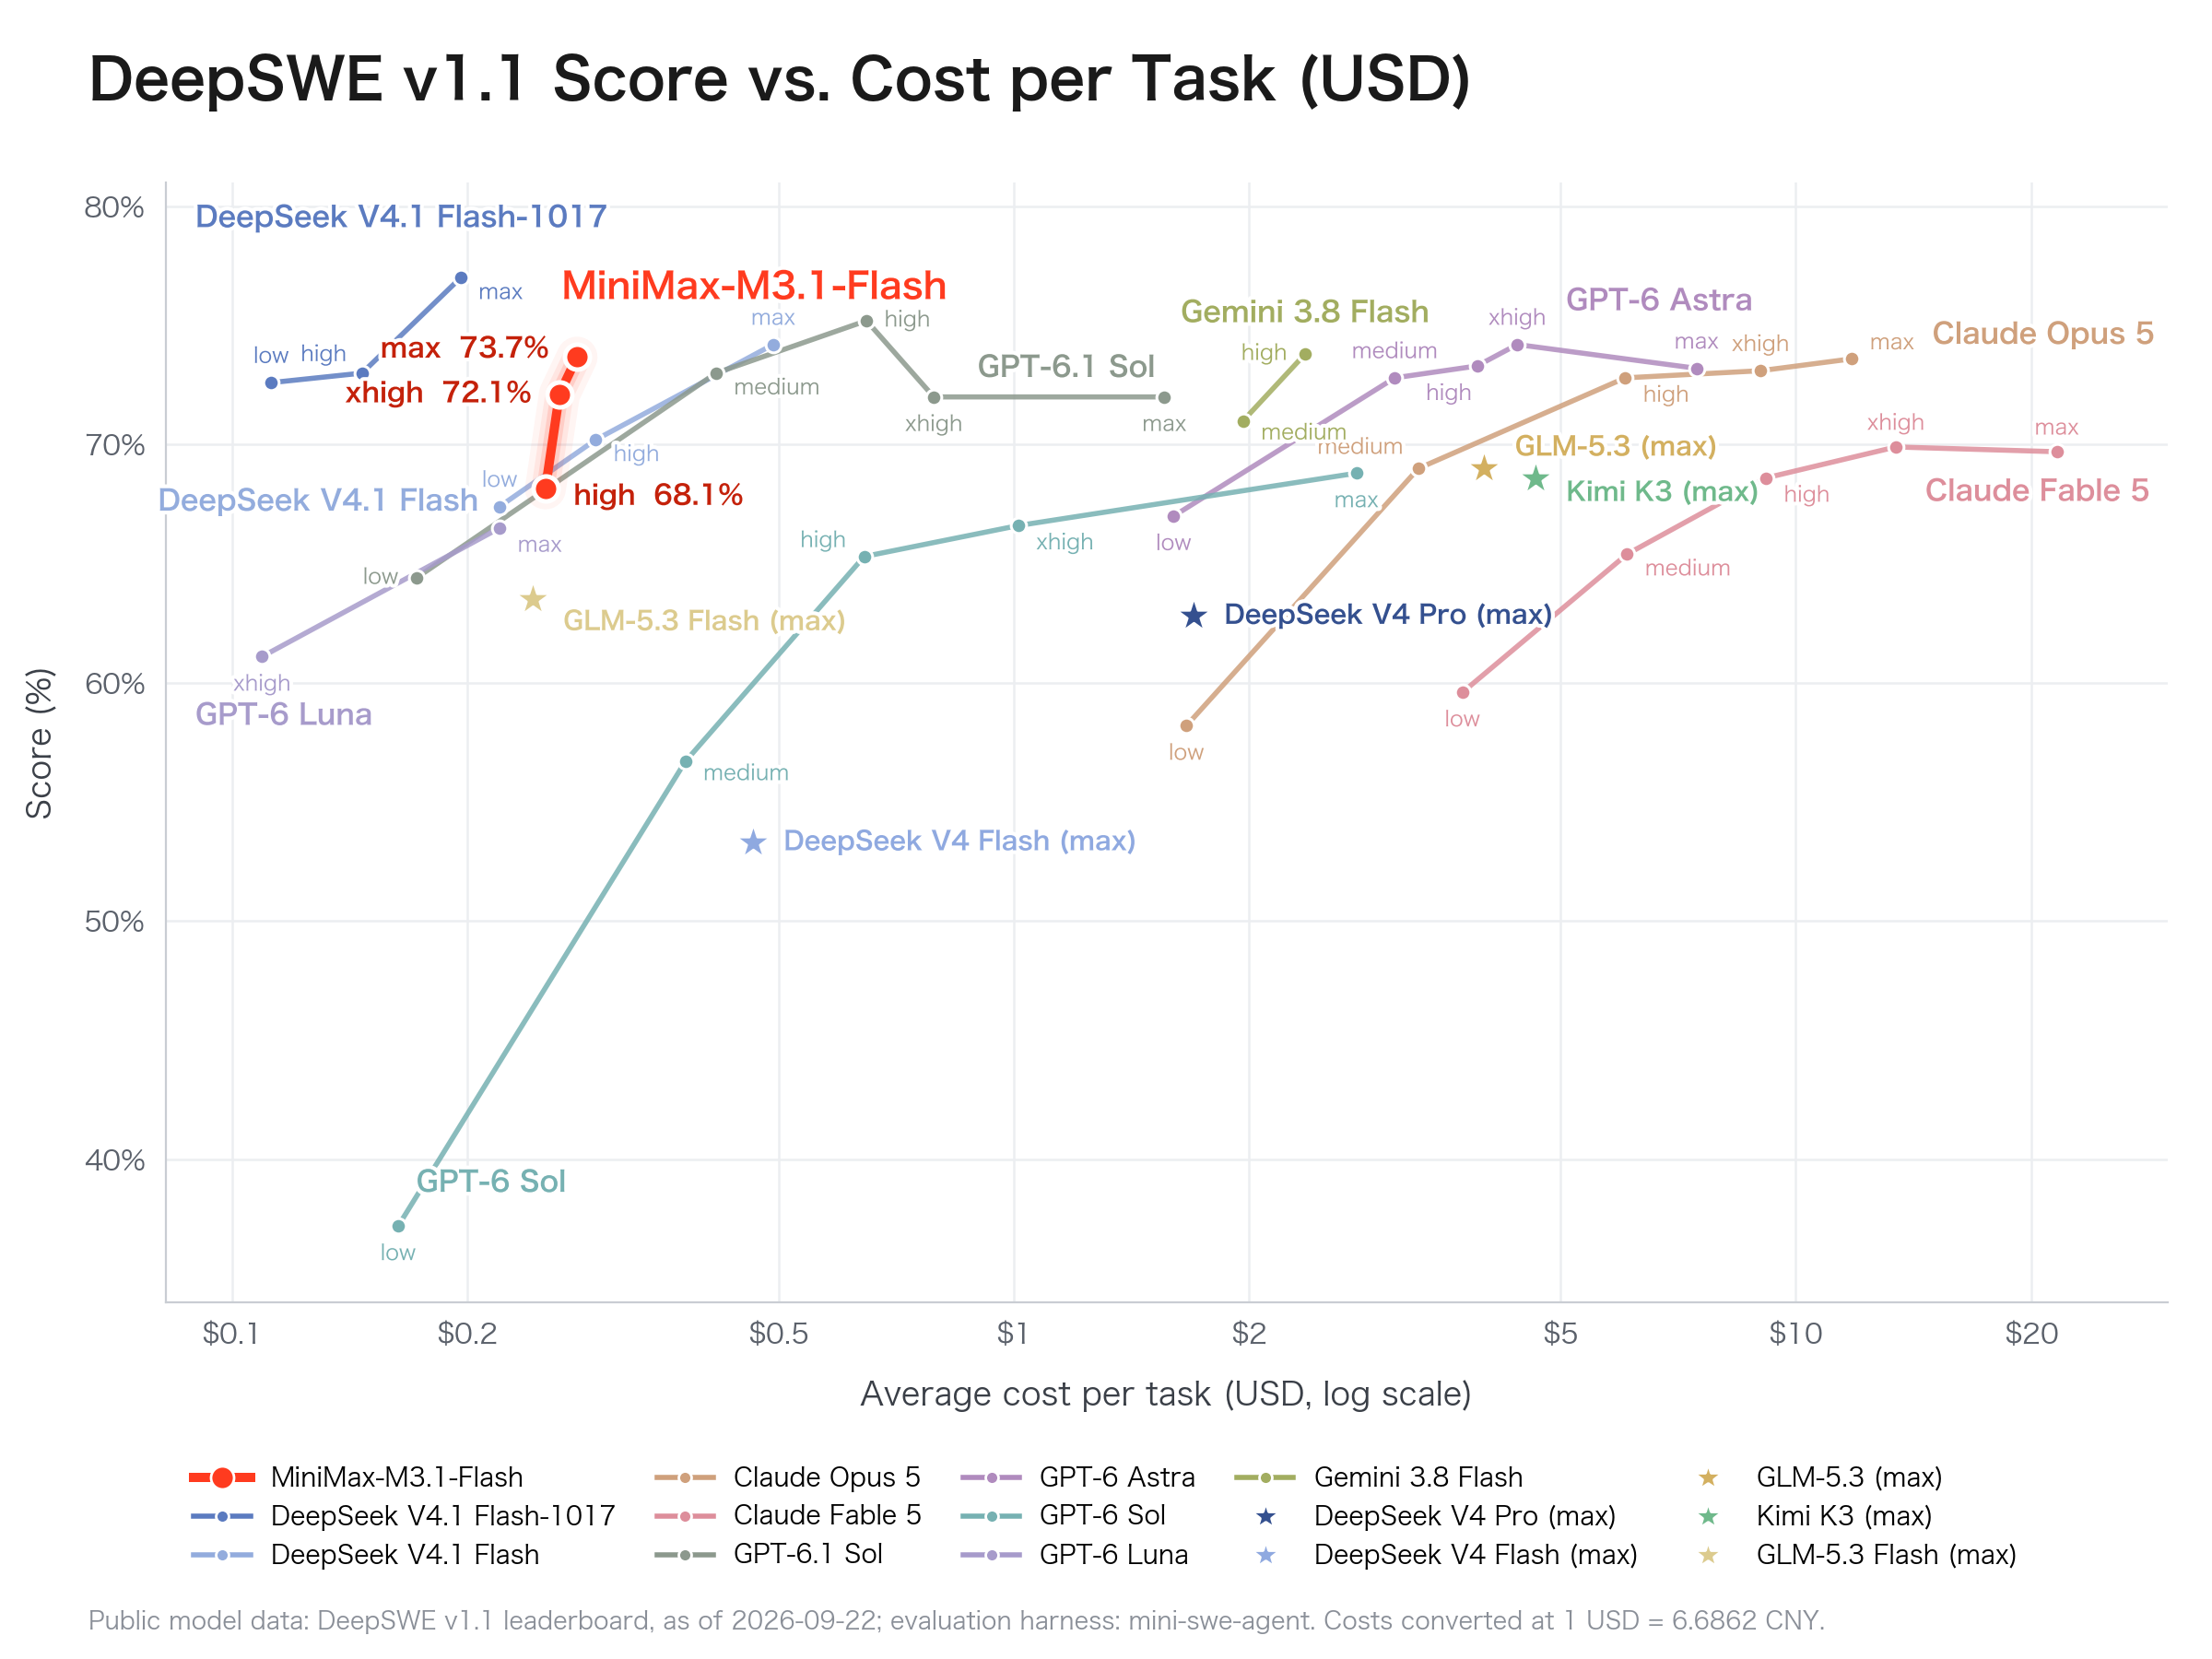
M3.1 Flash의 정확한 파라미터 구성, 벤치마크 점수, API 가격은 공식 블로그에 정리되어 있으니 도입을 고민한다면 원문 수치를 꼭 직접 확인해 보세요. 경량 모델은 벤치마크 종류에 따라 잘하는 것과 못하는 것이 크게 갈리는 편이에요. 그래서 평균 점수보다는 내 작업과 비슷한 항목(코딩, 도구 호출, 긴 문서 처리 등)을 골라서 보는 게 훨씬 의미 있어요.
업계에서는 어떤 위치일까요?
경량 모델 시장은 크게 두 진영으로 나눠 볼 수 있어요. 한쪽은 구글, OpenAI, Anthropic 같은 미국 빅테크의 클로즈드 API 모델이에요. 인프라가 안정적이고 생태계가 탄탄하지만 모델 내부는 공개하지 않죠. 다른 한쪽은 DeepSeek, Qwen(알리바바), Kimi(문샷), GLM(즈푸), 그리고 MiniMax 같은 중국 진영이에요. 이쪽은 가중치 공개와 공격적인 저가 API를 앞세워 개발자 생태계를 빠르게 넓혀 왔어요.
중국 모델들은 OpenAI나 Anthropic과 호환되는 API 형식을 제공하는 경우가 많아요. 그래서 이미 쓰던 코딩 에이전트 도구에서 주소와 키만 바꾸면 모델을 갈아 끼울 수 있죠. 개발자 입장에서는 옮겨 가는 부담이 거의 없으니 '한번 써 볼까?' 하는 마음이 쉽게 들어요. 경량 모델 경쟁이 결국 가격 대비 성능과 속도 싸움이라는 걸 생각하면 꽤 영리한 전략이에요.
한국 개발자에게 주는 시사점
- 모델 라우팅을 고민해 보세요. 요청마다 모델을 골라 보내는 방식이에요. 모든 요청을 가장 비싼 모델로 보낼 필요는 없거든요. 설계나 까다로운 디버깅은 플래그십에 맡기고, 파일 요약, 로그 분류, 간단한 리팩터링처럼 반복적인 일은 Flash급 모델로 돌리면 비용이 크게 줄어요.
- 한국어 성능은 직접 재 보세요. 벤치마크는 대부분 영어 기준이에요. 우리 서비스에 실제로 들어오는 질문 20~50개로 작은 평가셋을 만들고, 기존 모델과 나란히 비교하는 게 가장 정확해요.
- 데이터가 어디로 가는지 확인하세요. 해외 API를 쓸 때는 데이터를 어디서 처리하고 얼마나 보관하는지 꼭 따져 봐야 해요. 개인정보나 사내 코드가 오가는 서비스라면 보안팀과 먼저 이야기하고, 가중치가 공개된 모델이라면 직접 서버에 올려 쓰는 방법도 검토해 볼 만해요.
마무리
한 줄 정리: 에이전트가 모델을 수백 번씩 부르는 시대에는 '가장 똑똑한 모델'보다 '충분히 똑똑하고 빠르고 싼 모델'이 실제 서비스의 주력이 돼요.
여러분은 서비스나 개인 프로젝트에서 경량 모델을 어떻게 쓰고 계신가요? 비용 때문에 중국계 모델로 갈아타 본 경험이 있다면 품질이나 한국어 성능은 어땠는지 댓글로 나눠 주세요!
🔗 출처: Hacker News