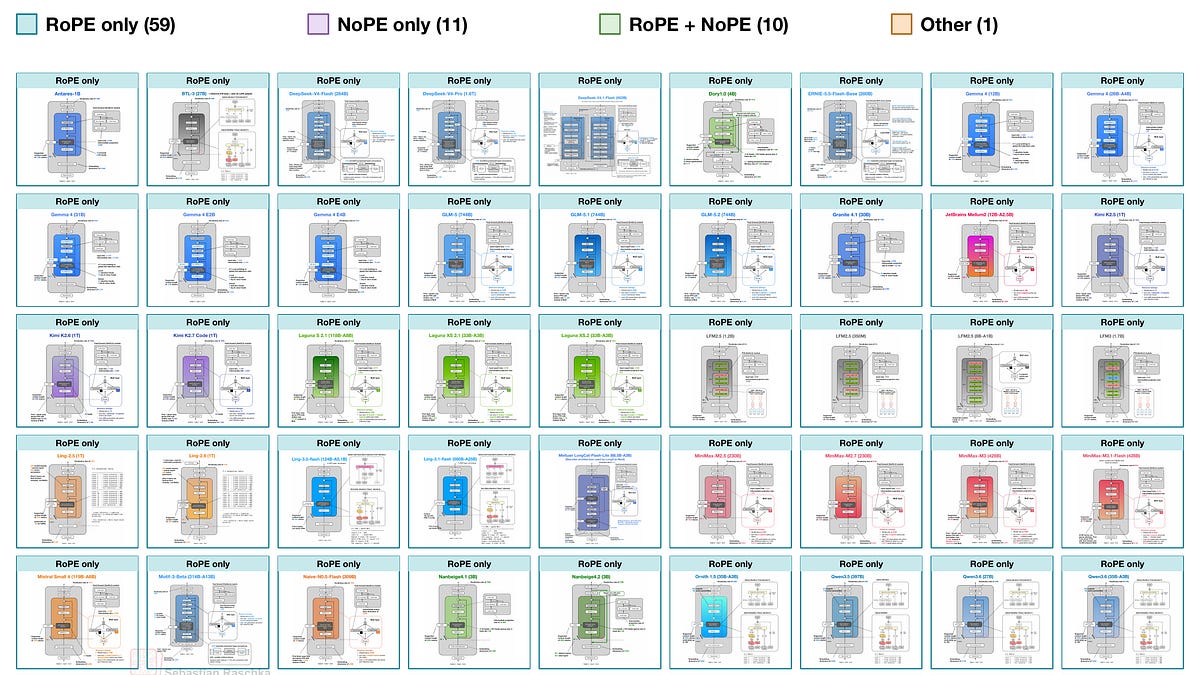
트랜스포머 기반 대규모 언어모델(LLM)은 입력을 토큰 단위로 병렬 처리한다. 덕분에 연산 효율은 높지만, 어텐션 연산 자체는 토큰의 순서를 본질적으로 구분하지 못한다는 약점이 따라붙는다. 머신러닝 교육 저자 세바스찬 라시카(Sebastian Raschka)는 최신 LLM 아키텍처 분석을 준비하던 중, 그동안 다루지 않았던 위치 정보 처리 방식을 독립적인 기초 해설로 정리했다. 사소해 보이지만 모델의 문맥 이해와 컨텍스트 확장 비용을 좌우하는 핵심 구성 요소이기 때문이다.
문제의 출발점은 단순하다. 같은 단어는 문장 안에서 몇 번째에 등장하든 동일한 토큰 ID를 받고, 임베딩 계층에서 동일한 벡터로 변환된다. 한 문장에 'fox'가 두 번 나와도 둘의 임베딩은 똑같다는 뜻이다. 위치 인코딩이 없고 인과 마스크(causal mask)도 없는 순수 셀프 어텐션에서는 'red'와 'gray'처럼 두 단어의 자리를 바꿔도 어텐션 점수가 동일하게 나온다. 즉 모델이 어순 변화를 감지하지 못한다.
암묵적 순서와 명시적 신호
흥미로운 점은 GPT 계열이 쓰는 인과 마스크가 이미 어느 정도 순서 정보를 암묵적으로 제공한다는 사실이다. 각 토큰은 자기 자신과 그 이전 토큰만 참조할 수 있으므로, 'jumps'가 참조하는 앞쪽 단어가 달라지면 이론상 두 문장을 구분할 여지가 생긴다. 라시카는 이 성질이 뒤에서 다룰 'NoPE'(위치 인코딩을 아예 생략하는 접근) 논의와 연결된다고 설명한다. 다만 인과 마스크만으로는 한계가 뚜렷하다. 어떤 토큰이 접근 가능한지는 알려주지만, 한 칸 떨어진 것과 열 칸 떨어진 것의 '거리'를 구별하지는 못하기 때문이다. 그래서 대부분의 LLM은 어텐션에 위치를 직접 알려주는 명시적 신호를 함께 넣는다.
가장 직관적인 방법은 각 위치마다 고유한 벡터를 하나씩 두고 토큰 임베딩에 더해주는 것이다. GPT-2가 이 방식을 쓴다. 토큰 임베딩과 동일한 차원의 위치 임베딩 테이블을 학습으로 만들어, 토큰 ID를 조회한 직후이자 첫 트랜스포머 블록에 들어가기 전 단계에서 원소별로 더한다. 위치 2의 'fox'와 위치 7의 'fox'는 서로 다른 위치 벡터를 더하게 되므로, 블록에 진입하기 전부터 값이 달라지고 쿼리·키·밸류 벡터에도 위치 정보가 반영된다. 이처럼 임베딩이 토큰 자신의 위치 m에 의존하는 방식을 절대적(absolute) 위치 인코딩이라 부른다.
학습형 테이블의 비용 함정
이 학습형 절대 위치 방식에는 현실적인 제약이 있다. GPT-2는 학습된 위치 벡터를 1,024개만 갖고 있어 1,024 토큰 이하 입력에서만 동작한다. 테이블이 다른 계층처럼 학습 대상이라, 컨텍스트 길이를 학습 시작 전에 확정해야 하고 나중에 늘리려면 매우 비싸다. 라시카가 제시한 비교가 인상적이다. GPT-2 Medium에서 1,024 위치일 때 위치 임베딩 가중치는 전체의 0.30%에 불과하지만, 요즘 흔한 10만 토큰 수준으로 늘리면 그 비중이 22%를 넘어선다. 순전히 위치를 저장하는 데 모델 용량의 5분의 1 이상을 쓰는 셈이라 경제성이 떨어진다.
학습 없이 위치 벡터를 계산으로 만드는 대안도 2017년 원조 트랜스포머(Attention Is All You Need)에서 이미 등장했다. 더하는 메커니즘은 같지만, 위치 벡터를 사인·코사인 함수로 고정 계산한다. 여기서는 토큰 임베딩을 √(dmodel)로 스케일링한 뒤 위치 벡터를 더하는데, 라시카는 논문에 설명이 없는 이 계수가 초기화 시점에 토큰 임베딩과 위치 인코딩의 수치 스케일을 비슷하게 맞춰 위치 벡터가 합산을 압도하지 않게 하려는 의도일 것이라고 본다. GPT-2는 토큰 임베딩 표준편차를 0.02, 위치 임베딩을 0.01로 초기화해 이미 비슷한 스케일이었기에 별도 스케일링이 필요 없었다.
사인·코사인 방식의 핵심은 위치 벡터를 어떻게 계산하느냐에 있다. 벡터의 특징(feature)들을 둘씩 짝지어, 각 쌍마다 서로 다른 주파수의 사인과 코사인 값을 넣는다. 예를 들어 특징이 8개인 작은 벡터라면 네 쌍이 생기고, 그 주파수는 각각 위치당 1, 0.1, 0.01, 0.001 라디안이 된다. 위치 m=2에서 첫 번째 쌍은 (sin 2, cos 2), 즉 약 (0.909, −0.416)로 계산된다. 이렇게 주파수가 다른 여러 파형을 겹쳐 쓰면, 가까운 위치와 먼 위치를 모두 구별할 수 있는 좌표계가 만들어진다. 이 사인·코사인 구조는 이후 현대 모델이 널리 채택한 RoPE(회전 위치 인코딩)에서 다시 등장한다.
실무자가 주목할 지점
MiniMax-M3를 비롯한 올해 공개 가중치 모델들은 GPT-2처럼 첫 블록 앞에서 위치를 더하는 대신, 각 트랜스포머 블록의 어텐션 내부에서 RoPE로 위치를 주입한다. 이 전환이 중요한 이유는 긴 컨텍스트 경제성과 직결되기 때문이다. 학습형 절대 테이블은 길이를 늘릴수록 가중치가 선형으로 불어나지만, 상대적 방식은 그런 테이블 없이 위치 관계를 표현한다. 실무에서 긴 컨텍스트 모델을 평가하거나 컨텍스트 확장을 검토할 때, 그 모델이 어떤 위치 인코딩을 쓰는지가 확장 가능성과 비용 구조를 가늠하는 단서가 된다. 다만 이 글은 RoPE의 구체 구현과 현대 아키텍처별 선택을 본격적으로 다루기 전 단계의 기초 해설이며, 각 방식이 실제 다운스트림 성능에 미치는 영향까지 정량적으로 비교하지는 않는다. 위치 인코딩이라는 '작은 블록'을 제대로 이해하는 것은, 결국 LLM이 왜 그런 구조로 수렴해 가는지를 읽어내는 출발점이다.