언어 모델이 계산기 흉내를 넘어 진짜 CPU가 된다면
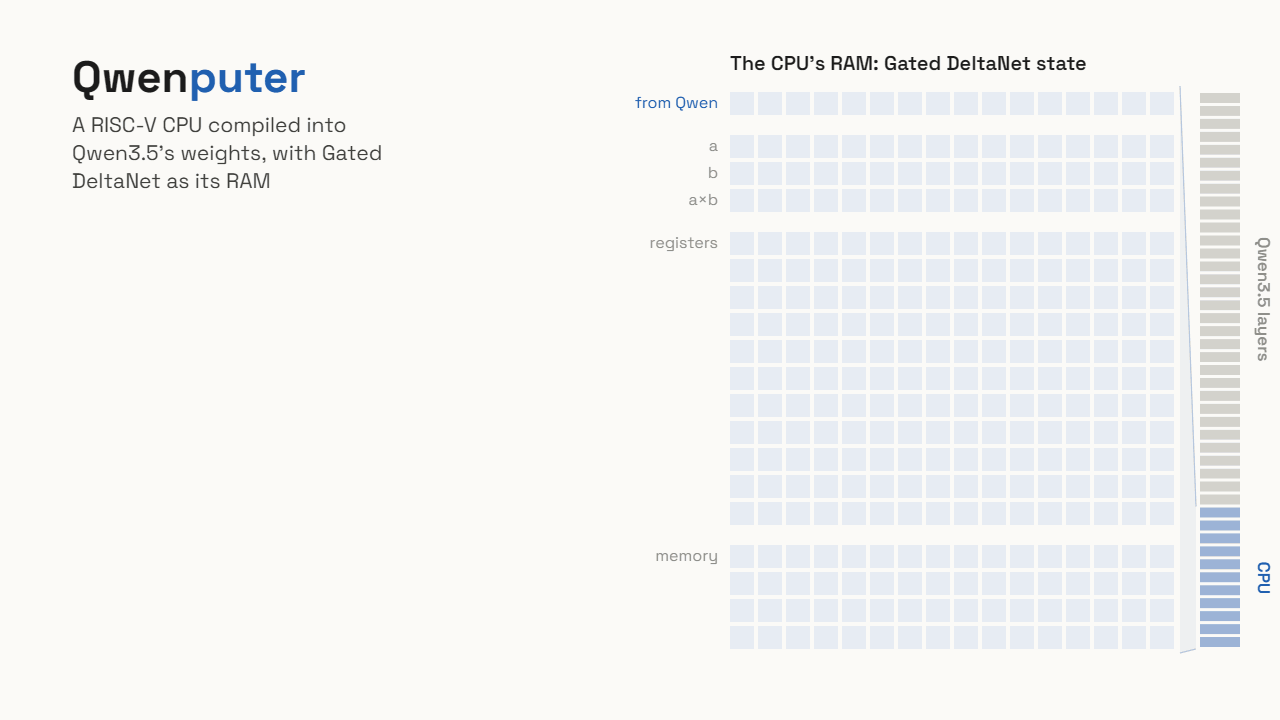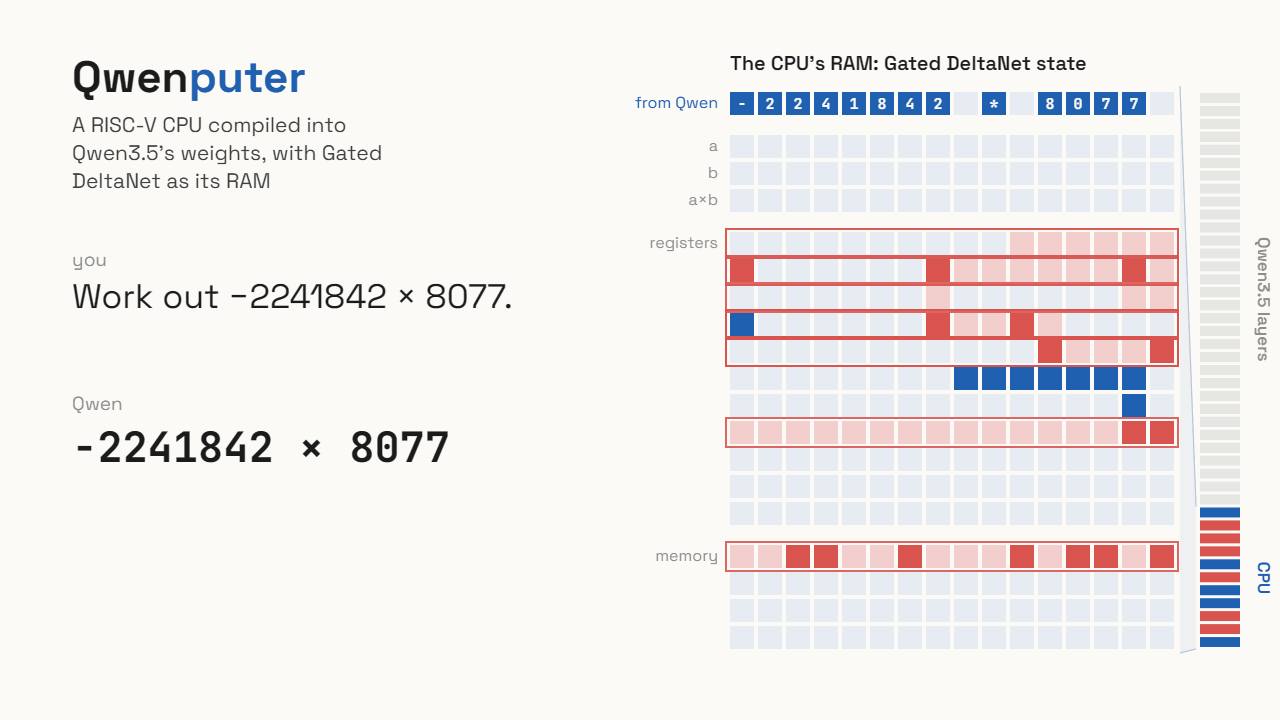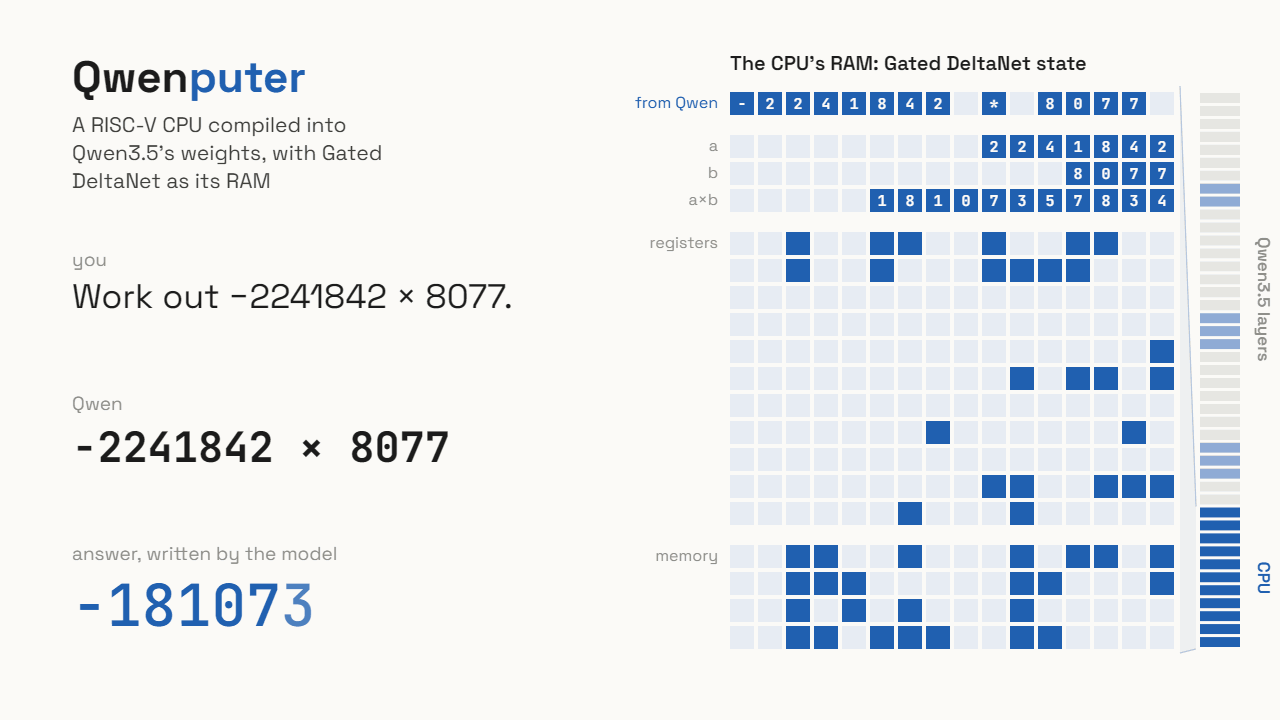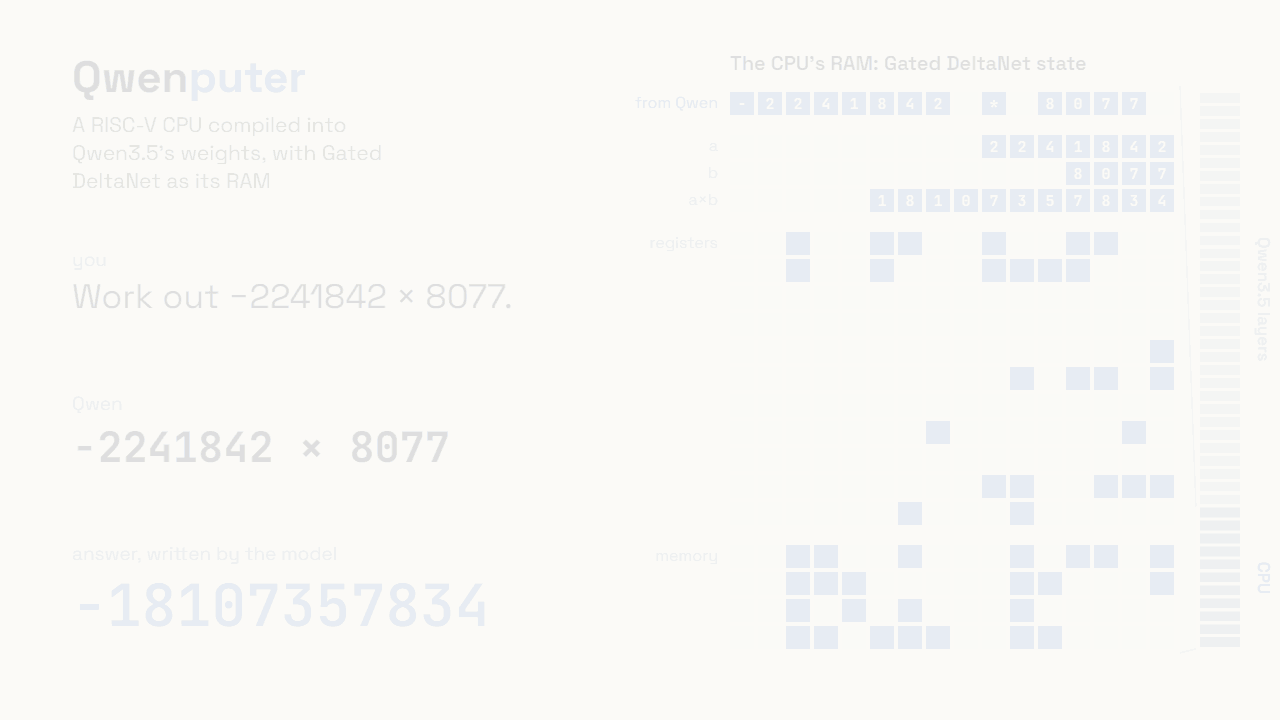
LLM한테 "123 × 456은?" 하고 물어보면 대부분 맞히긴 하는데요, 사실 이건 계산을 하는 게 아니라 그럴듯한 다음 토큰을 예측하는 거예요. 그래서 자릿수가 길어지거나 단계가 많아지면 슬쩍 틀리곤 하죠. 이번에 소개할 Qwenputer는 정반대 방향을 노린 실험이에요. 알리바바의 오픈 웨이트 모델인 Qwen3.5 안에 실제로 동작하고 결정론적인(deterministic) RISC-V CPU를 구현했다는 거거든요.
여기서 '결정론적'이라는 말이 핵심인데요, 같은 입력을 넣으면 언제나 똑같은 결과가 나온다는 뜻이에요. 보통 LLM은 확률 분포에서 토큰을 고르기 때문에 같은 질문에도 답이 조금씩 달라지잖아요. CPU는 그러면 안 되죠. add x1, x2, x3를 실행할 때마다 결과가 달라지는 CPU는 쓸 수가 없으니까요. 그러니까 이 프로젝트는 "LLM이 CPU처럼 보이게 하기"보다 "LLM의 연산 구조 위에서 CPU가 정확하게 돌아가게 하기"에 가까운 도전이에요.
RISC-V CPU가 하는 일부터 짚고 가요
RISC-V는 누구나 라이선스 비용 없이 쓸 수 있는 오픈 명령어 집합(ISA)이에요. 명령어 집합은 CPU가 알아듣는 '기계어 단어장' 같은 거예요. x86이나 ARM이 유료 단어장이라면 RISC-V는 공개된 단어장인 셈이죠. 기본 정수 명령어 세트(RV32I)는 작고 규칙적이라서 에뮬레이터나 교육용 CPU를 만들 때 단골로 쓰여요.
CPU가 하는 일을 아주 단순하게 줄이면 이 루프를 계속 반복하는 거예요.
1. Fetch: 프로그램 카운터(PC)가 가리키는 메모리에서 명령어를 읽어요.
2. Decode: 그 32비트 숫자를 쪼개서 "덧셈이고, 레지스터 2번과 3번을 더해 1번에 넣어라"로 해석해요.
3. Execute: 실제로 계산해요.
4. Write back: 결과를 레지스터나 메모리에 쓰고 PC를 다음 명령어로 옮겨요.
이 루프 전체를 트랜스포머라는 전혀 다른 기판 위에서, 그것도 오차 없이 돌린다는 게 Qwenputer의 흥미로운 지점이에요.
트랜스포머로 어떻게 CPU를 만들 수 있을까
신경망으로 CPU를 만든다니 황당하게 들리지만, 이론적인 뿌리는 꽤 탄탄해요. 연구자들은 오래전부터 트랜스포머가 원리적으로 범용 계산을 표현할 수 있다는 걸 보여왔거든요. 대표적인 게 RASP라는 '트랜스포머용 프로그래밍 언어'와, 이걸 실제 가중치로 컴파일해 주는 DeepMind의 Tracr예요. 학습을 시키는 대신 사람이 짠 프로그램을 가중치 행렬로 직접 변환하는 거죠. 루프를 도는 트랜스포머로 간단한 컴퓨터를 흉내 내는 연구(Looped Transformers as Programmable Computers)도 있었고요.
이런 류의 연구에서는 트랜스포머 부품을 보통 이렇게 바라봐요.
- 어텐션은 '주소로 찾아보기'예요. 컨텍스트 안에 메모리나 레지스터 값이 토큰으로 깔려 있으면, 어텐션은 "주소가 0x100인 칸"을 쿼리로 삼아 그 값을 정확히 집어 올 수 있어요. 일종의 사전 조회죠.
- MLP(피드포워드 레이어)는 '조합 논리 회로'예요. 비트를 쪼개 opcode를 판별하거나 덧셈·비교 같은 연산을 하는 부분을 가중치로 표현할 수 있어요.
- 토큰을 하나 생성하는 걸 '클럭 사이클'로 보면 이해가 쉬워요. 모델이 출력을 내놓을 때마다 CPU 상태가 한 단계씩 전진하는 그림이에요.
- 트랜스포머 내부를 이해하기 좋은 교보재예요. 어텐션을 "Q·K·V 행렬곱"으로만 외웠다면, "주소 기반 조회"로 다시 보는 경험이 꽤 신선할 거예요.
- 컴퓨터 구조 복습도 돼요. 학부 때 배운 fetch-decode-execute를 완전히 다른 기판 위에서 다시 만나는 거니까요. RISC-V 에뮬레이터를 짜본 적이 없다면 주말 프로젝트로 RV32I 에뮬레이터부터 만들어 보는 것도 추천해요.
- LLM 신뢰성에 대한 감각도 길러져요. "모델이 계산을 잘한다"와 "모델 안에 정확한 계산 회로가 있다"는 완전히 다른 얘기거든요. 금융이나 정산처럼 정확성이 생명인 서비스에 LLM을 붙인다면, 계산은 여전히 코드나 도구에 맡기는 게 맞아요.
결정론을 지키려면 어텐션이 "거의 맞는 곳"이 아니라 "정확히 그곳"에만 몰리도록 해야 하고, 출력도 확률 샘플링 대신 가장 높은 값 하나를 고르는 방식으로 고정해야 해요. 이걸 이미 학습이 끝난 대형 모델인 Qwen3.5 안에서 해냈다는 게 이번 실험의 묘미예요. 구체적으로 어떤 방식으로 CPU를 모델 안에 넣었는지, 지원하는 명령어 범위가 어디까지인지는 원문에서 직접 따라가 보시길 추천해요.
업계 맥락: 도구 호출 vs 내장 계산
지금 업계가 LLM의 계산 약점을 푸는 주류 방식은 도구 호출(tool use)이에요. 계산이 필요하면 모델이 파이썬 인터프리터나 계산기를 부르고 결과만 받아오는 거죠. 실용적이고 정확하지만, 모델 바깥으로 나갔다가 들어와야 해요.
Qwenputer 같은 시도는 반대로 "정확한 계산 능력을 모델 내부에 박아 넣을 수 있는가"를 물어요. 이 방향은 기계적 해석 가능성(mechanistic interpretability) 연구와도 맞닿아 있어요. 신경망 내부를 뜯어보면서 "이 뉴런 묶음이 덧셈을 담당한다"처럼 회로 단위로 이해하려는 분야예요. 사람이 의도한 회로를 직접 심어보고 기존 능력과 어떻게 공존하는지 보는 건, 모델이 내부에서 어떻게 계산하는지 이해하는 데도 힌트를 줘요.
물론 효율로 따지면 진짜 CPU랑 비교할 수가 없어요. 수십억 개 파라미터를 곱해서 명령어 하나를 실행하는 셈이니까요. 그래서 이 실험은 "더 빠른 컴퓨터"가 아니라 "트랜스포머가 무엇을 표현할 수 있는가"를 보여주는 데모로 보는 게 맞아요.
한국 개발자에게 주는 시사점
당장 실무에 쓸 기술은 아니지만 배울 거리는 정말 많아요.
마무리
한 줄 정리: Qwenputer는 LLM이 확률적인 흉내를 넘어 정확한 기계를 품을 수 있다는 걸 보여주는, 트랜스포머 구조에 대한 흥미로운 증명이에요.
여러분은 어떻게 보세요? 정확한 계산 회로를 모델 안에 심는 방식이 언젠가 도구 호출을 대체할 수 있을까요, 아니면 끝까지 연구용 장난감으로 남을까요?
🔗 출처: Hacker News