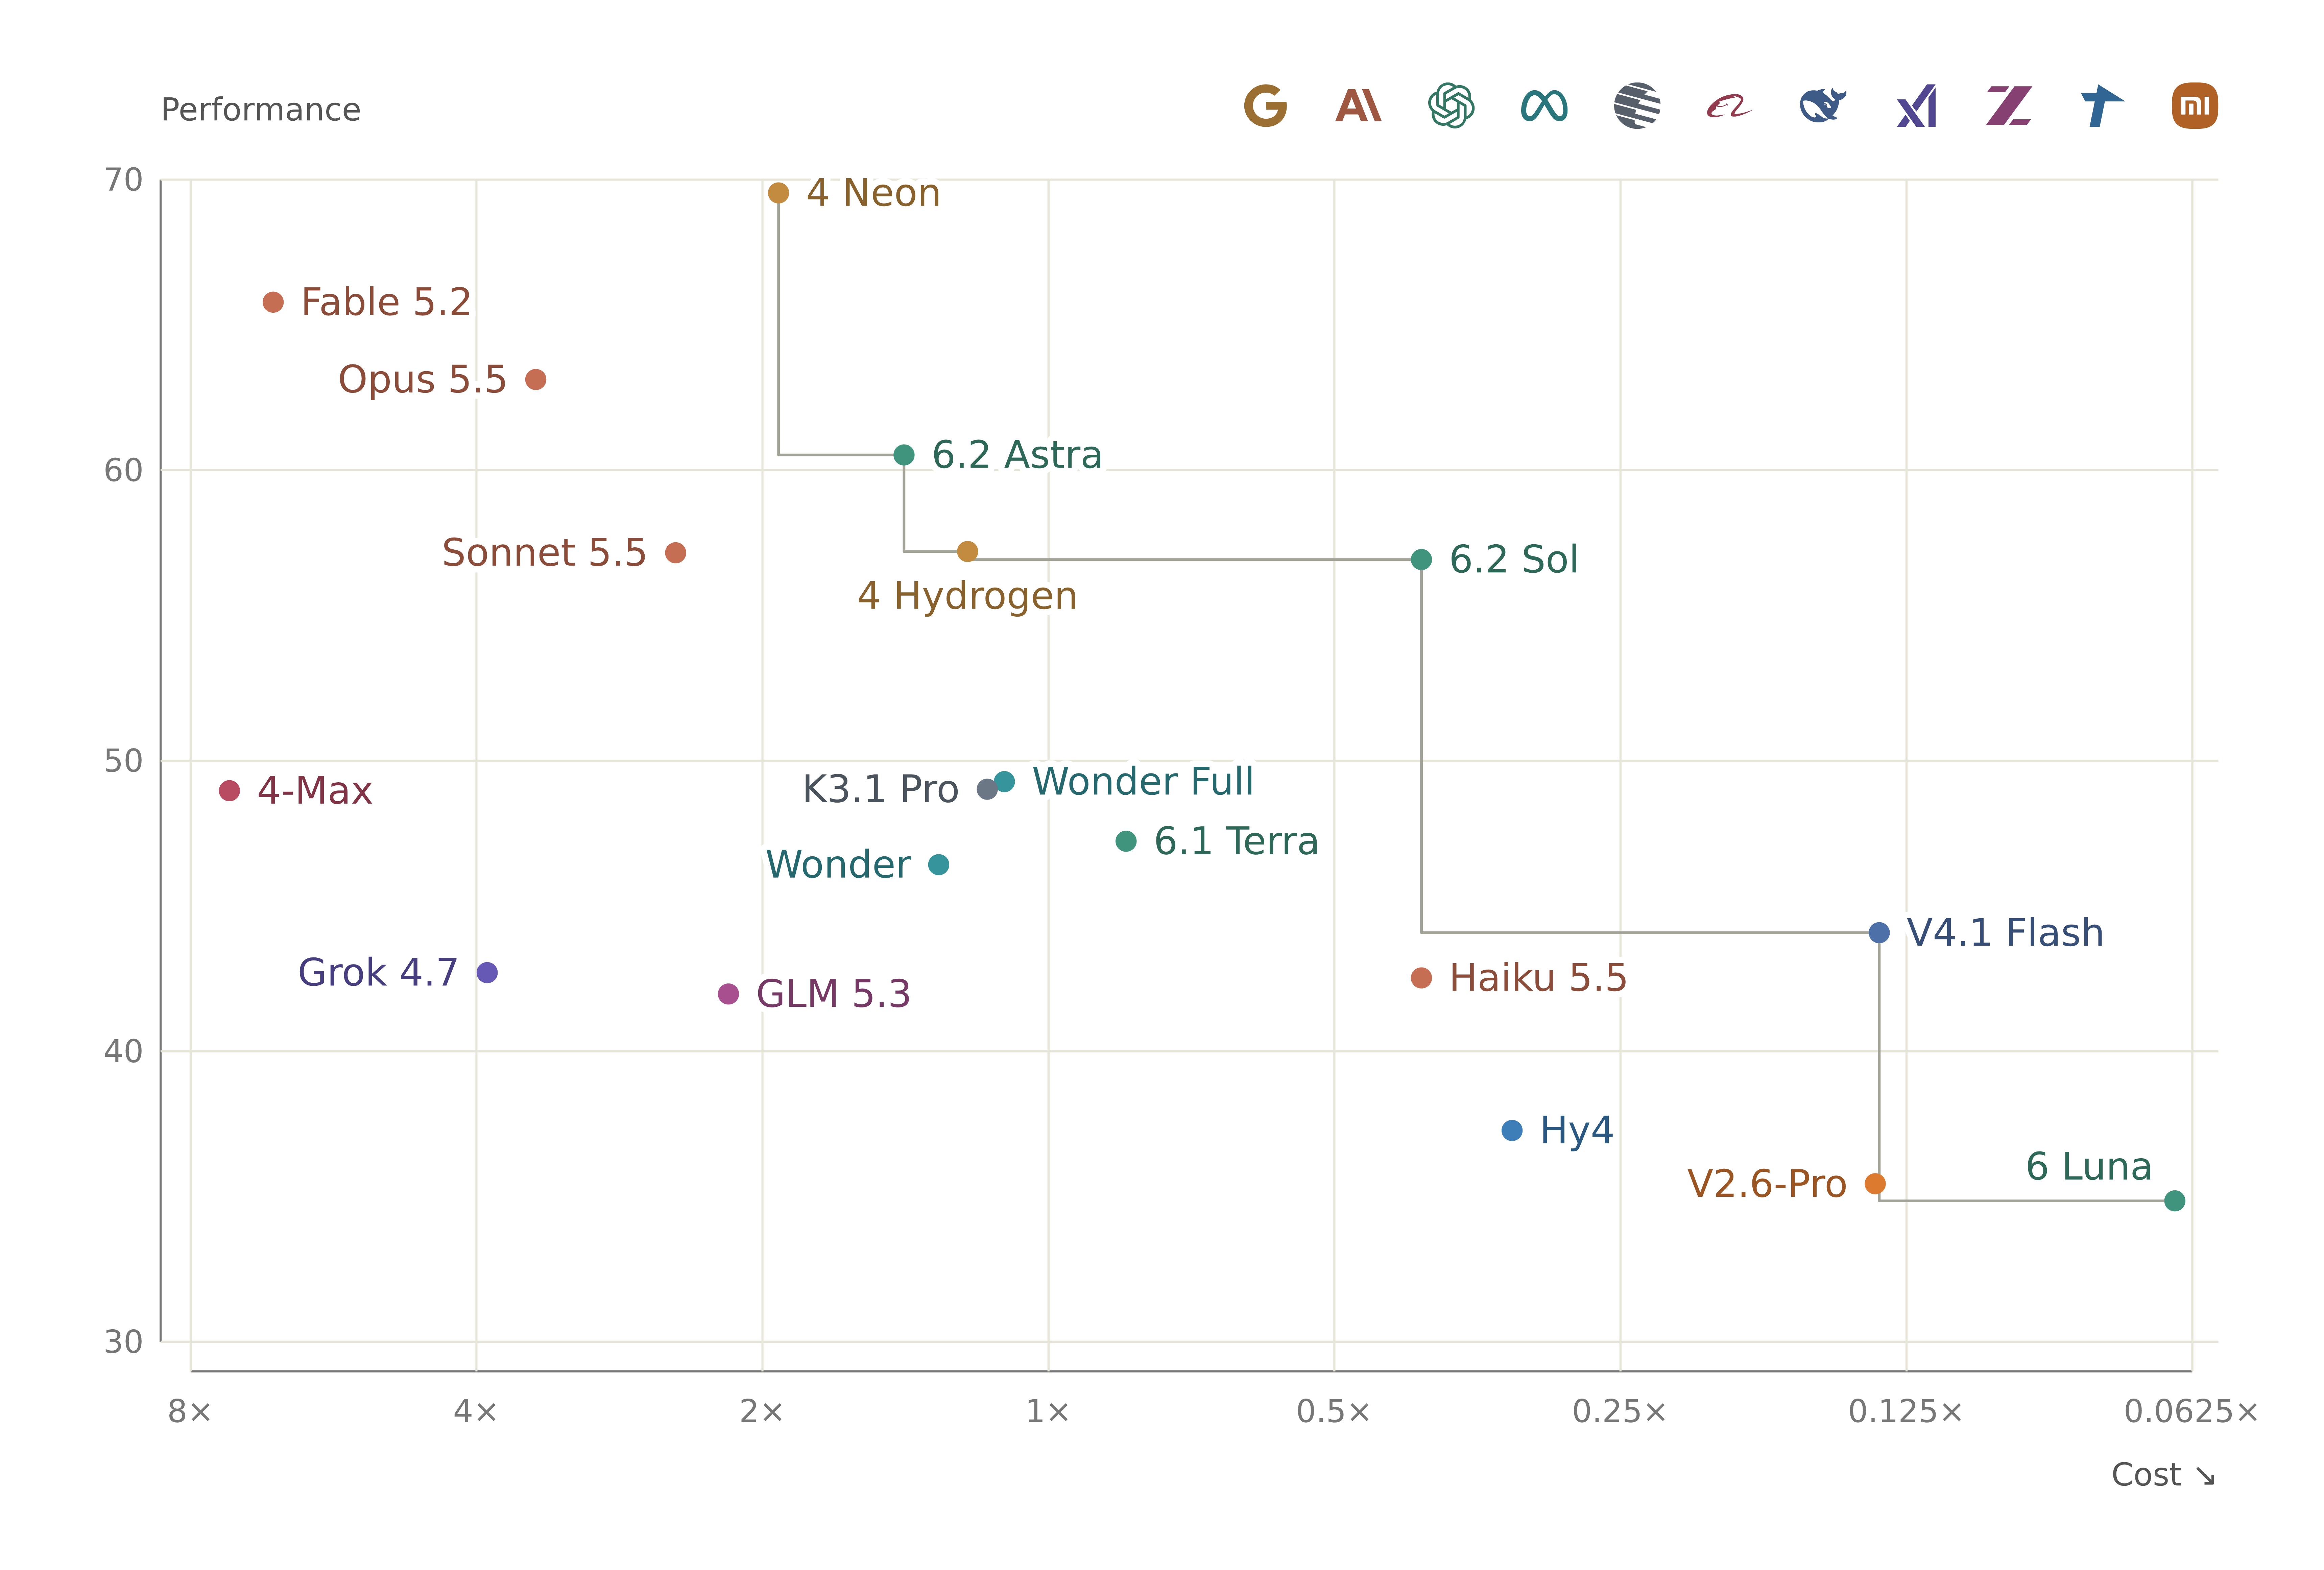
언어 모델의 성능을 가늠하는 지표가 범용 추론이나 지식 시험에서 점차 '실무에서 얼마나 쓸 만한가'로 옮겨가고 있다. 최근 공개된 MEI(Models Engineering Index)는 바로 그 흐름 위에 있는 지수다. MEI는 언어 모델이 엔지니어링 과제를 실제로 얼마나 잘 수행하는지를 측정한다고 밝히고 있으며, 이번 집계에서 'Gemini 4 Neon'이 새롭게 1위에 올랐다. 수십 종의 모델을 한자리에 놓고 비교하는 형태이지만, 공개된 정보의 핵심은 결국 '엔지니어링 작업 기준으로 순위를 매긴다'는 점에 있다.
범용 벤치마크와 무엇이 다른가
그동안 모델 성능 논의는 수학·상식·독해 같은 범용 시험 점수에 크게 기대왔다. 이런 지표는 모델의 기초 체력을 보여주기에는 좋지만, 개발 현장에서 체감하는 유용성과는 간극이 있었다. 같은 고득점 모델이라도 실제 코드 작성, 버그 수정, 기존 코드베이스 이해, 여러 단계에 걸친 작업 수행 능력은 제각각이기 때문이다. MEI처럼 '엔지니어링 과제에서의 실무 성능'을 전면에 내세운 지수가 주목받는 이유가 여기에 있다. 이는 리더보드를 보는 관점을 추상적 지능에서 구체적 작업 수행력으로 이동시킨다.
실무자 입장에서 이런 구분은 단순한 명칭 차이가 아니다. 코드 생성 도구나 에이전트를 도입할 때 정작 중요한 것은 '이 모델이 우리 레포에서 실제 과제를 끝까지 처리하는가'이지, 추상적인 추론 점수가 아니다. 엔지니어링 중심 지수는 그 판단에 더 가까운 신호를 제공한다는 점에서 실용적 가치가 있다.
치열해진 상위권 경쟁
MEI가 비교 대상으로 올린 모델의 수는 상당히 많다. 특정 한두 기업의 제품뿐 아니라 서로 다른 계열의 여러 모델이 같은 기준 위에서 나란히 평가된다. 이는 현재 모델 시장이 소수 선두 주자의 독주가 아니라, 세대 교체와 변형 버전이 빠르게 쏟아지는 다자 경쟁 국면에 들어섰음을 보여준다. 어제의 1위가 오늘 바뀌는 구조에서 'Gemini 4 Neon의 1위'라는 표현 자체가 순위의 유동성을 전제한 것이기도 하다.
이런 환경에서는 특정 시점의 1위 모델을 기준으로 기술 스택을 고정하는 접근이 위험하다. 리더보드 상단은 수개월 단위로 재편되며, 상위 모델 간 격차가 좁을수록 순위 변동은 사소한 측정 조건 차이에서도 발생할 수 있다. 따라서 '현재 1위'는 선택의 출발점일 뿐 결론이 되어서는 안 된다.
지수를 읽을 때의 한계
다만 MEI를 실무 판단 근거로 삼기에는 분명한 한계가 있다. 현재 공개된 내용만으로는 지수가 어떤 과제 집합으로 구성됐는지, 점수를 어떻게 산출하고 가중하는지, 각 모델의 구체적 수치가 얼마인지 확인하기 어렵다. 측정 방법론이 투명하게 드러나지 않으면, 순위는 참고용 신호일 뿐 그대로 신뢰하기는 어렵다. 어떤 벤치마크든 설계자가 선택한 과제의 성격에 따라 특정 모델에 유리하거나 불리하게 기울 수 있다는 점도 유념해야 한다.
결국 이런 지수는 모델을 좁히는 1차 필터로 활용하고, 최종 선택은 자사 코드베이스와 실제 워크플로를 대상으로 한 자체 검증으로 확정하는 것이 바람직하다. MEI가 전하는 '엔지니어링 실무 성능 중심 평가'라는 방향성은 유의미하지만, 1위라는 타이틀보다 그 평가가 겨냥하는 질문—우리 현장의 작업을 끝까지 해내는가—이 더 오래 남을 기준이다.