도입
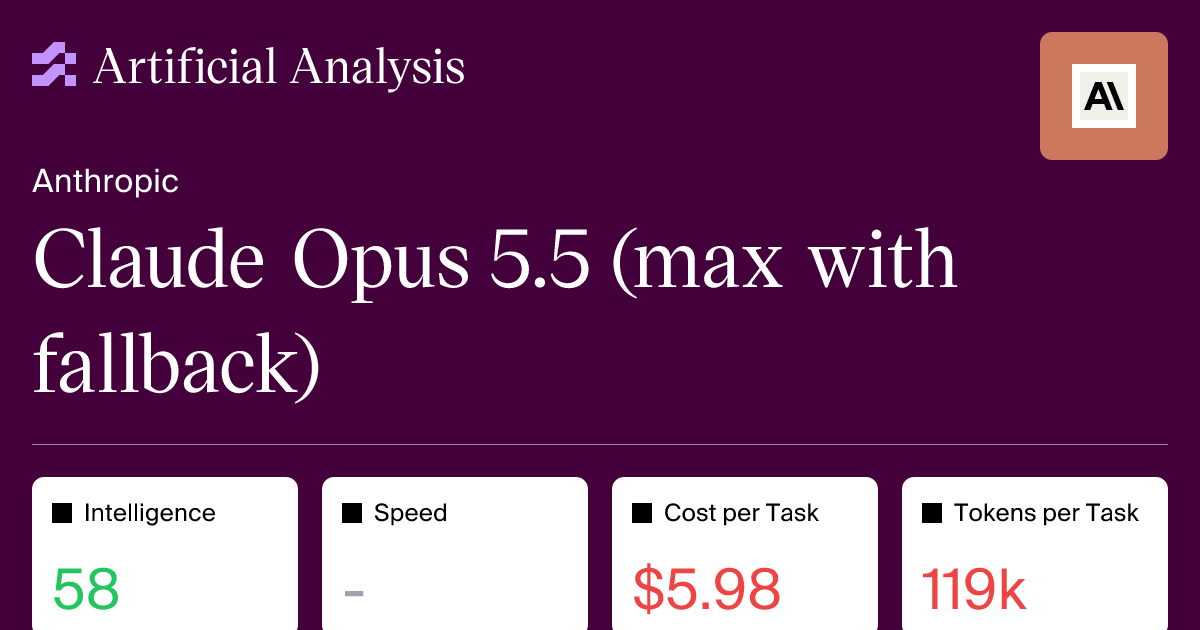
새 프론티어 모델이 나오면 요즘은 발표 블로그보다 Artificial Analysis 페이지를 먼저 여는 분들이 많아요. 모델 회사가 직접 고른 벤치마크 말고, 제3자가 똑같은 조건으로 잰 지능·속도·가격을 한눈에 볼 수 있거든요. 이번에 올라온 건 Anthropic의 최신 플래그십인 Claude Opus 5.5, 그것도 추론 노력을 최대로 올린 'Max' 설정에 대한 분석이에요. 그런데 이런 페이지를 볼 때 종합 점수 하나만 보고 '1등이네, 이거 쓰자'로 끝내면 실무에서 낭패를 봐요. 이 글에서는 특정 숫자를 외우는 것보다 중요한 것, 즉 이 지표들이 각각 무엇을 재는지, 'Max'가 붙으면 뭐가 달라지는지, 한국 개발자가 모델을 고를 때 어느 칸을 봐야 하는지 이야기해볼게요.
Artificial Analysis가 뭐냐면
독립 벤치마크 사이트예요. 각 모델 회사의 API를 직접 호출해서 똑같은 문제 세트를 풀게 하고, 그 결과를 Intelligence Index라는 종합 점수로 묶어요. 이 안에는 대학원 수준 과학 문제(GPQA Diamond), 전문가도 어려워하는 종합 시험(Humanity's Last Exam), 코딩(LiveCodeBench, SciCode), 수학(AIME), 지시 따르기(IFBench), 긴 문맥 이해(AA-LCR), 터미널에서 실제 작업을 수행하는 에이전트 평가(Terminal-Bench Hard), 도구를 쓰며 대화하는 에이전트 평가(τ²-Bench) 같은 항목이 들어가요. 지능과 별개로 출력 속도(초당 토큰 수), 첫 토큰이 나올 때까지의 지연 시간(TTFT), 입력과 출력 100만 토큰당 가격, 컨텍스트 창 크기를 같이 보여줘요.
핵심은 이거예요. 종합 점수는 '평균적으로 얼마나 똑똑한가'이고, 여러분에게 필요한 건 '내 작업에서 얼마나 똑똑한가'예요. 이 둘은 자주 달라요.
'Max'가 붙으면 뭐가 달라지나
요즘 프론티어 모델은 답하기 전에 '생각'을 해요. 이게 뭐냐면, 최종 답변을 내기 전에 내부적으로 풀이 과정을 토큰으로 써 내려가는 건데, 이 생각의 양을 개발자가 조절할 수 있어요. 낮음, 중간, 높음, 최대 같은 단계로요. 'Max'는 그 다이얼을 끝까지 올린 상태예요. 어려운 문제일수록 점수가 올라가지만, 대신 출력 토큰이 몇 배로 늘고 답이 나오기까지 시간도 길어져요.
그래서 Artificial Analysis는 같은 모델이라도 추론 설정별로 항목을 따로 만들어요. 사실상 다른 제품으로 취급하는 거죠. 이게 중요한 이유는, 표에서 '토큰당 가격'이 같아 보여도 실제 청구 금액은 전혀 다르기 때문이에요. 생각 토큰도 출력 토큰으로 과금되거든요. 그래서 이 사이트가 함께 제공하는 'Intelligence Index를 한 바퀴 돌리는 데 든 총비용' 항목이 토큰 단가보다 훨씬 실무에 가까운 숫자예요.
어느 칸을 봐야 하나
첫째, 토큰 단가가 아니라 작업당 비용을 보세요. 단가는 싼데 생각을 많이 해서 토큰을 열 배 쓰는 모델과, 단가는 비싼데 짧게 답하는 모델 중 어느 쪽이 싼지는 실제로 돌려봐야 알아요.
둘째, 속도와 지연을 구분하세요. 초당 토큰 수는 긴 답변을 스트리밍할 때 체감되고, TTFT는 채팅 UI에서 '멈춘 것 같은' 느낌을 결정해요. 추론 모델은 생각하는 동안 첫 토큰이 늦게 나오니까, 사용자와 실시간으로 대화하는 화면에 Max 설정을 붙이면 체감이 나빠져요.
셋째, 종합 점수 말고 하위 항목을 보세요. 코딩 에이전트를 만든다면 Terminal-Bench와 LiveCodeBench, 고객 응대 봇이라면 τ²-Bench와 IFBench, 문서 분석이라면 AA-LCR이 여러분 작업과 가까워요.
넷째, 컨텍스트 창과 가격의 관계를 보세요. 컨텍스트가 크다고 다 넣으면 입력 비용이 그대로 늘어요. 프롬프트 캐싱 지원 여부와 캐시 히트 시 할인율이 실제 비용을 좌우해요.
업계 맥락
지금 프론티어 경쟁은 OpenAI의 GPT 계열, 구글의 Gemini 계열, Anthropic의 Claude 계열이 상위권을 번갈아 차지하고, DeepSeek나 Qwen 같은 오픈 웨이트 모델이 바로 아래에서 가격을 압박하는 구도예요. 흥미로운 변화는 '모델 하나에 다이얼 하나'라는 흐름이에요. 예전에는 작은 모델과 큰 모델 중에 골랐다면, 이제는 같은 모델의 추론 노력을 조절해서 가격과 성능 사이를 슬라이더처럼 오가요. Opus 5.5 (Max)라는 항목 이름 자체가 이 흐름을 보여줘요. 한국에서는 네이버 HyperCLOVA X, LG 엑사원, 업스테이지 솔라 같은 모델들이 한국어 특화와 비용을 무기로 다른 자리를 노리고 있고요.
한국 개발자에게 주는 시사점
실무에서 모델을 고를 때 이렇게 해보세요. 먼저 여러분 서비스에 실제로 들어오는 요청 50~100개를 모아서 작은 평가 세트를 만드세요. 정답이 명확한 것과 사람이 채점해야 하는 것을 섞어서요. 그다음 후보 모델을 여러 추론 설정으로 돌려서 정확도, 지연, 실제 청구 토큰을 표로 만드세요. 이 표 하나가 어떤 외부 벤치마크보다 정확해요.
그리고 라우팅을 고려하세요. 모든 요청을 Opus Max로 보낼 필요는 없어요. 분류나 단순 추출은 소형 모델, 복잡한 코드 수정이나 다단계 추론만 최상위 모델로 보내는 구조가 비용을 몇 배 줄여줘요. 배치 API(급하지 않은 요청을 모아 싸게 처리)와 프롬프트 캐싱도 꼭 챙기시고요. 마지막으로 비용을 추정할 때는 반드시 '생각 토큰 포함 실제 출력 토큰'으로 계산하세요. 단가만 보고 예산 잡았다가 청구서 보고 놀라는 경우가 정말 많아요.
마무리
한 줄 정리하면, 벤치마크 페이지의 종합 점수는 출발점일 뿐이고, 여러분 작업에서의 정확도와 작업당 비용과 지연을 직접 재는 것이 모델 선택의 전부예요.
여러분 팀은 모델을 고를 때 자체 평가 세트를 갖고 계신가요? 추론 노력 설정을 실제로 바꿔가며 써보신 분은 어떤 작업에서 차이를 느끼셨는지, 그리고 최상위 모델의 가격이 실무 도입의 벽이 되는지 아니면 결과물 대비 충분히 감당할 만한지 의견이 궁금해요.
🔗 출처: Hacker News