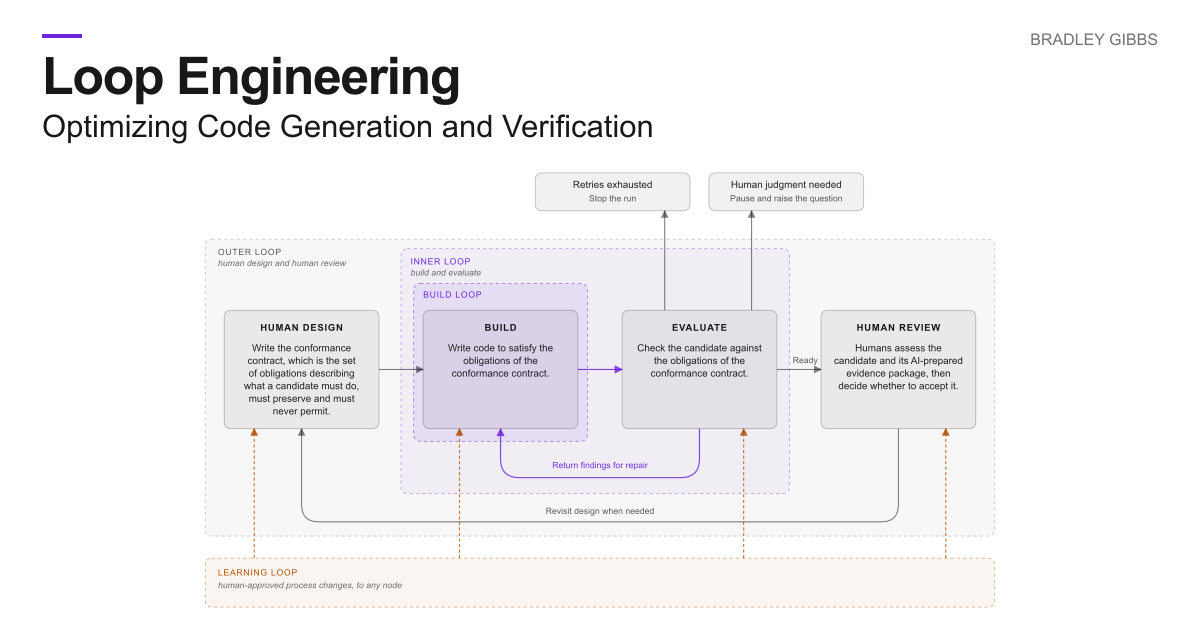
AI 코딩 도구가 확산되면서 개발 생산성 논의의 무게중심이 '얼마나 빨리 짜느냐'에서 '짜낸 코드를 어떻게 믿느냐'로 옮겨가고 있다. 브래들리 깁스가 정리한 '루프 엔지니어링(Loop Engineering)'은 바로 이 지점을 다룬다. 그는 AI 보조 개발의 두 가지 근본 과제를 의도를 정확하고 완전하게 명세하는 일과 생성된 코드가 그 명세를 만족하는지 검증하는 일로 나누고, 이 글에서는 후자, 즉 검증에 초점을 맞춘다. 핵심 주장은 단순하다. 생성이 빨라질수록 평가에 드는 인간의 시간·주의·판단을 아끼도록 프로세스 자체를 설계해야 한다는 것이다.
더 많은 코드가 만들어내는 하류 병목
생성 속도가 빨라졌다는 것은 수치로도 확인된다. 50만 명이 넘는 깃허브 개발자를 다룬 NBER 워킹페이퍼는 대화형 코딩 에이전트 도입 후 21~30주 차에 주당 변경 라인이 958%, 생성된 PR이 86% 늘었고 주당 저장소 릴리스도 20% 증가했다고 추정했다. 문제는 아이디어에서 제품 출시까지의 전 과정에서 코드를 쓰고 테스트하는 일이 차지하는 비중이 베인(Bain) 추정으로 약 25~35%에 불과하다는 점이다. 한 단계의 산출량만 폭증하면 나머지 단계가 병목이 된다.
깁스는 검증이 더 버거워지는 이유를 다섯 가지로 짚는다. 첫째, 코드가 사람이 읽을 수 있는 속도보다 빠르게 쏟아진다. 파로스(Faros) 텔레메트리는 높은 AI 도입과 함께 병합 PR이 98% 늘고 리뷰 시간은 91% 길어졌다고 보고했으며, 2026년 더 큰 데이터셋에서는 사람이든 에이전트든 어떤 리뷰도 거치지 않고 병합된 PR이 31.3% 증가했다. 둘째, 틀린 코드도 그럴듯해 보인다. 소나(Sonar)의 2026년 조사에서 개발자 61%가 'AI가 맞아 보이지만 신뢰할 수 없는 코드를 만들 수 있다'는 데 동의했다.
셋째, '이해 부채(comprehension debt)'다. 구현을 팀의 누구도 직접 쓰지 않았다면 리뷰는 저자가 으레 갖는 이해 없이 시작된다. 앤트로픽이 새 라이브러리를 익히는 엔지니어 52명을 대상으로 한 실험에서, AI 보조를 쓴 쪽은 완료 시간은 비슷했지만 후속 이해도 퀴즈에서 17%포인트 낮은 점수(50% 대 67%)를 받았다. 넷째, 변경이 커지고 문제도 함께 커진다. 파로스는 평균 PR 크기가 154% 늘었다고 보았고, 코드래빗(CodeRabbit)이 오픈소스 PR 470건을 분석한 결과 AI가 공동 저자로 참여한 변경은 PR당 약 1.7배 많은 이슈를 안고 있었다. 다섯째, 검증 장치 자체도 믿기 어렵다. AI가 동작을 바꾸면서 수백 개의 테스트를 거기에 맞춰 수정하면, 질문은 '코드가 맞는가'에서 '그 테스트 수정이 필요했는가'로 옮겨간다. 통과한 테스트 스위트가 사실은 코드에 맞춰 다시 쓰인 결과일 수 있다는 것이다.
평가자를 빌더의 권한 밖에 두기
여기서 깁스가 제시하는 핵심 설계 원칙이 나온다. 그는 먼저 '최종 평가(terminal evaluation)' 개념을 설명한다. AI 시스템은 주어진 작업과 성공 기준에 따라 스스로 결과를 낼 때까지 자율적으로 작업하고, 그 결과물(후보)을 평가자가 합의된 명세와 대조한다. 다만 최종 판정은 결과가 기준을 충족했는지는 알려줘도 어떻게 거기에 도달했는지는 설명하지 못한다. 그래서 평가의 신뢰성은 구성(모델·하네스·도구·컨텍스트·제약)에 달려 있고, 구성이 바뀌면 역량과 신뢰성을 다시 측정해야 한다.
실무적 장치는 '적합성 계약(conformance contract)'이다. 코드가 무엇을 해야 하고, 무엇을 보존해야 하며, 무엇을 결코 허용해선 안 되는지를 인간과 AI가 함께 번역해 승인한 의무의 집합이다. 각 의무에는 적합 여부를 가릴 검사, 기대 결과, 증거 요건이 construction 이전에 마련되어야 한다. 중요한 것은 검사 설계가 의도된 동작뿐 아니라 위반도 다뤄야 한다는 점이다. 올바른 구현도 통과시키지만 결함 있는 구현도 함께 통과시키는 검사는 사실상 아무것도 입증하지 못한다. 그리고 계약과 권위 있는 검사는 한 번의 바운드된 실행 동안 고정된다. 어떤 에이전트도 실행 도중 의무나 검사를 몰래 바꿀 수 없으며, 변경을 제안할 수는 있되 그것이 수용되면 프로세스를 다시 돌려야 한다.
이 원칙을 담보하는 것이 빌드 루프 바깥에 사는 독립 평가자다. 컨트롤러 코드가 평가자를 호출해 후보를 계약과 대조하고, 어떤 후보가 어떤 검사를 거쳐 무엇이 확인되고 무엇이 미검증으로 남았는지 기록한다. 빌더의 '완료' 선언은 자격을 결정하지 않으며, 증거가 없는 항목은 통과로 칠 수 없다. 정지 조건에 따라 자격을 갖춘 후보는 인간 리뷰로 올라가고, 거부된 후보는 실패한 의무와 근거를 안고 재시도가 남아 있을 때만 다시 construction으로 돌아간다. 재시도가 소진되면 실행은 자격을 갖춘 후보 없이 멈추고, 판단이 필요한 모호함은 프로세스를 멈추고 질문을 올린다.
한국 실무자가 얻을 것과 한계
이 설계가 겨냥하는 효과는 분명하다. 결정적으로 검증 가능한 것(테스트, AST 검사, 런타임 관측)은 기계가 처리해 확정된 사실로 남기고, 사람의 주의와 판단이라는 한정된 예산은 기계가 가를 수 없는 주장—요구사항이 의도를 담았는지, 동작이 제품에 필요한 것인지, 변경이 주변 시스템에 어떻게 맞물리는지—에 집중시킨다. AI는 각 의무별로 의무 자체와 검사 결과, 생성된 코드, 미해결 질문을 한데 모은 뷰를 조립해, 리뷰어가 증거를 처음부터 재구성하지 않고 판단이 필요한 지점에서 출발하도록 돕는다. 다만 이 신뢰는 검사 커버리지와 후보에 묶인 증거에 달려 있어, 약한 검사는 여전히 아무것도 보장하지 못한다.
주의할 점은 저자 스스로 밝힌 한계다. 이 글은 측정된 절감 효과를 보고하지 않으며, 예시 코드 상당수는 가설적이다. 지난 12개월간 자체 파이프라인으로 코드를 생성해 왔지만, 방법론은 각자의 워크플로에서 직접 검증해 보라고 권한다. 결국 루프 엔지니어링이 던지는 메시지는 도구 교체가 아니라 역할 재배치다. 평가자의 검사와 기대 결과를 빌더의 수정 권한 밖에 두고, 사람의 승인을 자율 작업의 양 끝(의무 승인과 병합 결정)에 배치하는 것. AI 생성량을 자랑하기 전에 '검증 가능한 것과 판단이 필요한 것'을 조직의 프로세스로 분리해 두었는지를 먼저 물어야 한다.