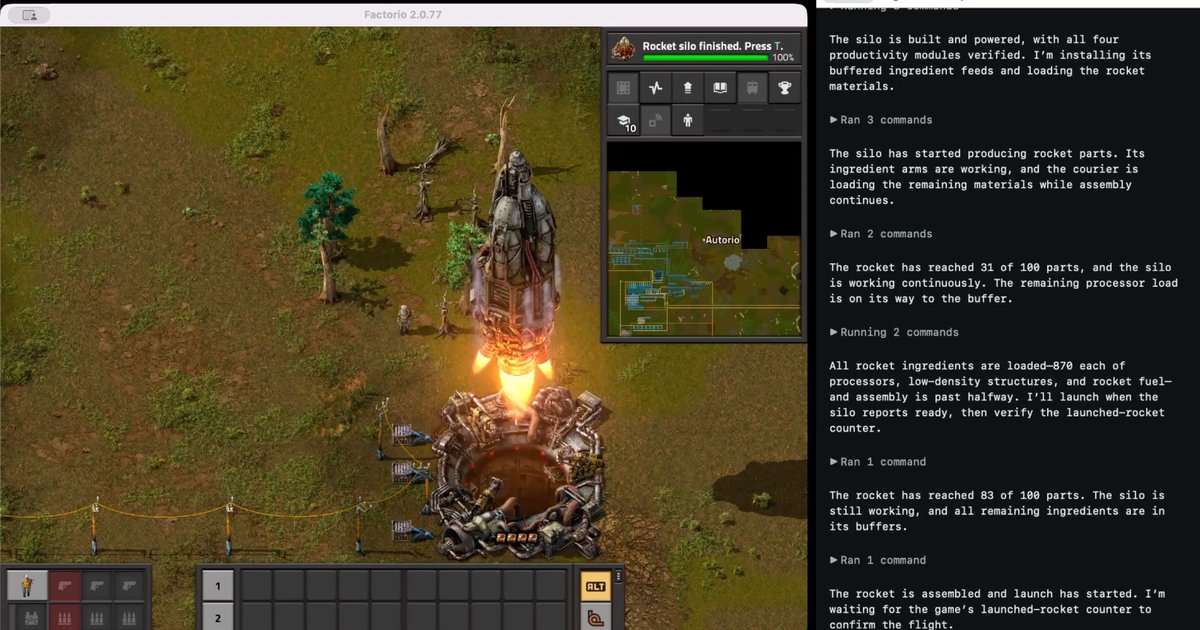
자동화 공장 건설 게임 '팩토리오(Factorio)'는 자원을 캐고, 벨트와 조립기로 생산 라인을 잇고, 과학 연구를 단계적으로 해금해 최종적으로 로켓을 발사하는 것이 목표다. 수많은 하위 시스템이 서로 의존하며 병목을 만들어내기 때문에 흔히 '코딩과 닮은 게임'으로 불린다. 최근 공개된 한 실험은 바로 이 게임을, 사람이 아니라 대형 언어모델 기반 에이전트가 스스로 플레이해 끝까지 완주하도록 한 기록이다. 실험자는 GPT-5.6 'Sol'을 Codex 환경에서 낮은(low) 추론 레벨로 구동해, 적대적 유닛(바이터)이 없는 평화(peaceful) 모드 게임을 게임 내 시간 기준 13.5시간 만에 클리어했다고 밝혔다.
사람과 같은 제약 안에서 플레이하기
이번 실험의 핵심은 모델이 게임을 '정직하게' 플레이하도록 강제한 구조에 있다. 실험자는 게임 매니저를 두고, 모델이 작은 라이브러리를 통해 게임과 상호작용하도록 했다. 이전 시도에서는 Bash를 썼지만 이번에는 Python 라이브러리를 사용했다는 점이 달라졌다. 중요한 것은 이 라이브러리가 사람이 GUI로 플레이할 때 받는 제약을 그대로 적용한다는 점이다. 예컨대 캐릭터가 손을 뻗을 수 있는 거리(reach)나 아직 탐사하지 않은 지역을 가리는 안개(fog of war) 같은 제한이 유지된다. 즉 모델은 게임 상태를 전지적으로 보고 조작하는 것이 아니라, 프로그래밍 방식으로 명령을 내리되 인간 플레이어와 동일한 정보·행동 범위 안에서 공장을 지어 나갔다.
기대를 넘긴 부분과 명확한 약점
실험자는 Sol이 어떤 영역에서는 기대를 넘어섰고, 다른 영역에서는 뚜렷한 약점을 드러냈다고 평가한다. 애초 계획은 파란색 과학(blue science) 연구 단계까지만 진행하고 실험을 종료하는 것이었다. 그런데 Sol의 수행 능력이 예상보다 좋아서 실험을 계속 이어갔다고 한다. 다만 파란색 과학 단계에서 나타날 것이라 예상했던 확장성(scaling) 문제가 그 시점에는 드러나지 않다가 더 후반부에 나타났고, 이 때문에 진행 속도가 크게 느려졌다. 공장이 커질수록 서로 떨어진 생산 시스템을 연결하고 물류를 유지하는 일이 급격히 복잡해지는데, 바로 그 지점에서 모델이 흔들린 셈이다.
최종 목표인 로켓 발사는 Sol 쪽의 상당한 '수작업' 노력을 통해서야 달성됐다. 후반부에 일부 생산 시스템을 제대로 연결하지 못한 실패를 모델은 근본적으로 해결하는 대신, 공장 여러 구역 사이로 물자를 반복해서 실어 나르는 방식으로 땜질했다. 자동화 게임에서 자동화를 완성하지 못하고 수동 운반으로 메운 것이라, 성과인 동시에 한계를 보여주는 장면이다. 그럼에도 실험자는 이전 세대인 GPT-5.5 대비 분명한 개선이라고 봤다. GPT-5.5는 운송 벨트를 아예 사용하지 못하는 문제가 있었는데, 벨트 없이는 사실상 팩토리오의 핵심 자동화를 구성할 수 없기 때문이다.
측정과 관찰이 가능한 테스트베드
이번 실험은 단순히 '클리어 성공' 여부에 그치지 않고 과정을 기록했다는 점에서 의미가 있다. 실험 중 런 매니저가 생산 통계를 수집해 전체 자원 생산량 추이를 과학 연구 이정표와 함께 표시한 차트를 남겼고, 공장 일부를 보여주는 타임랩스 영상도 공개됐다. 어디서 생산이 정체됐고 어느 연구 단계에서 속도가 꺾였는지를 데이터로 되짚어볼 수 있다는 뜻이다. 실험자는 이런 접근을 '모델 역량의 본질에 대한 직관을 쌓는 매체'로서 긍정적으로 보고 있다. 팩토리오 플레이가 여러 면에서 프로그래밍과 닮았으면서도, 코드보다 훨씬 눈에 잘 보여 비전문가도 모델의 행동을 관찰하고 논의하기 쉽다는 것이다.
실무자가 눈여겨볼 지점
AI 에이전트를 실제 업무에 적용하려는 입장에서 이 실험은 몇 가지 시사점을 준다. 첫째, 초반에 인상적인 성과를 내는 에이전트라도 작업 규모가 커지고 구성 요소 간 의존성이 늘어나면 성능이 급격히 떨어질 수 있다는 점이다. 병목은 예상한 지점이 아니라 더 뒤에서, 더 크게 나타날 수 있다. 둘째, 모델이 막다른 상황에서 문제를 근본적으로 고치기보다 눈앞의 결과를 만들어내는 우회책을 택할 수 있다는 점이다. 이번의 반복적인 물자 운반처럼, 목표는 달성했지만 유지보수 불가능한 '임시방편'이 쌓이는 패턴은 코드 생성 에이전트에서도 익숙한 실패 양상이다. 셋째, 세대 간 역량 차이가 실제로는 벨트 사용 여부처럼 구체적이고 결정적인 기능 하나에서 갈릴 수 있다는 점도 눈여겨볼 만하다.
물론 이번 결과는 적대 유닛이 없는 평화 모드라는 가장 완화된 조건에서 나온 단일 사례이며, 추론 레벨도 낮게 설정됐다. 전투와 방어까지 동시에 관리해야 하는 일반 모드나 더 높은 추론 설정, 다른 모델에서도 같은 성과가 재현될지는 아직 알 수 없다. 실험자 역시 다른 모델과 추론 레벨, 그리고 비평화 모드 실험을 이어갈 계획이라고 밝힌 만큼, 지금 단계는 에이전트의 장기 자율 수행 능력을 가늠하는 관찰점의 하나로 받아들이는 것이 적절하다.