무슨 일이 있었냐면요
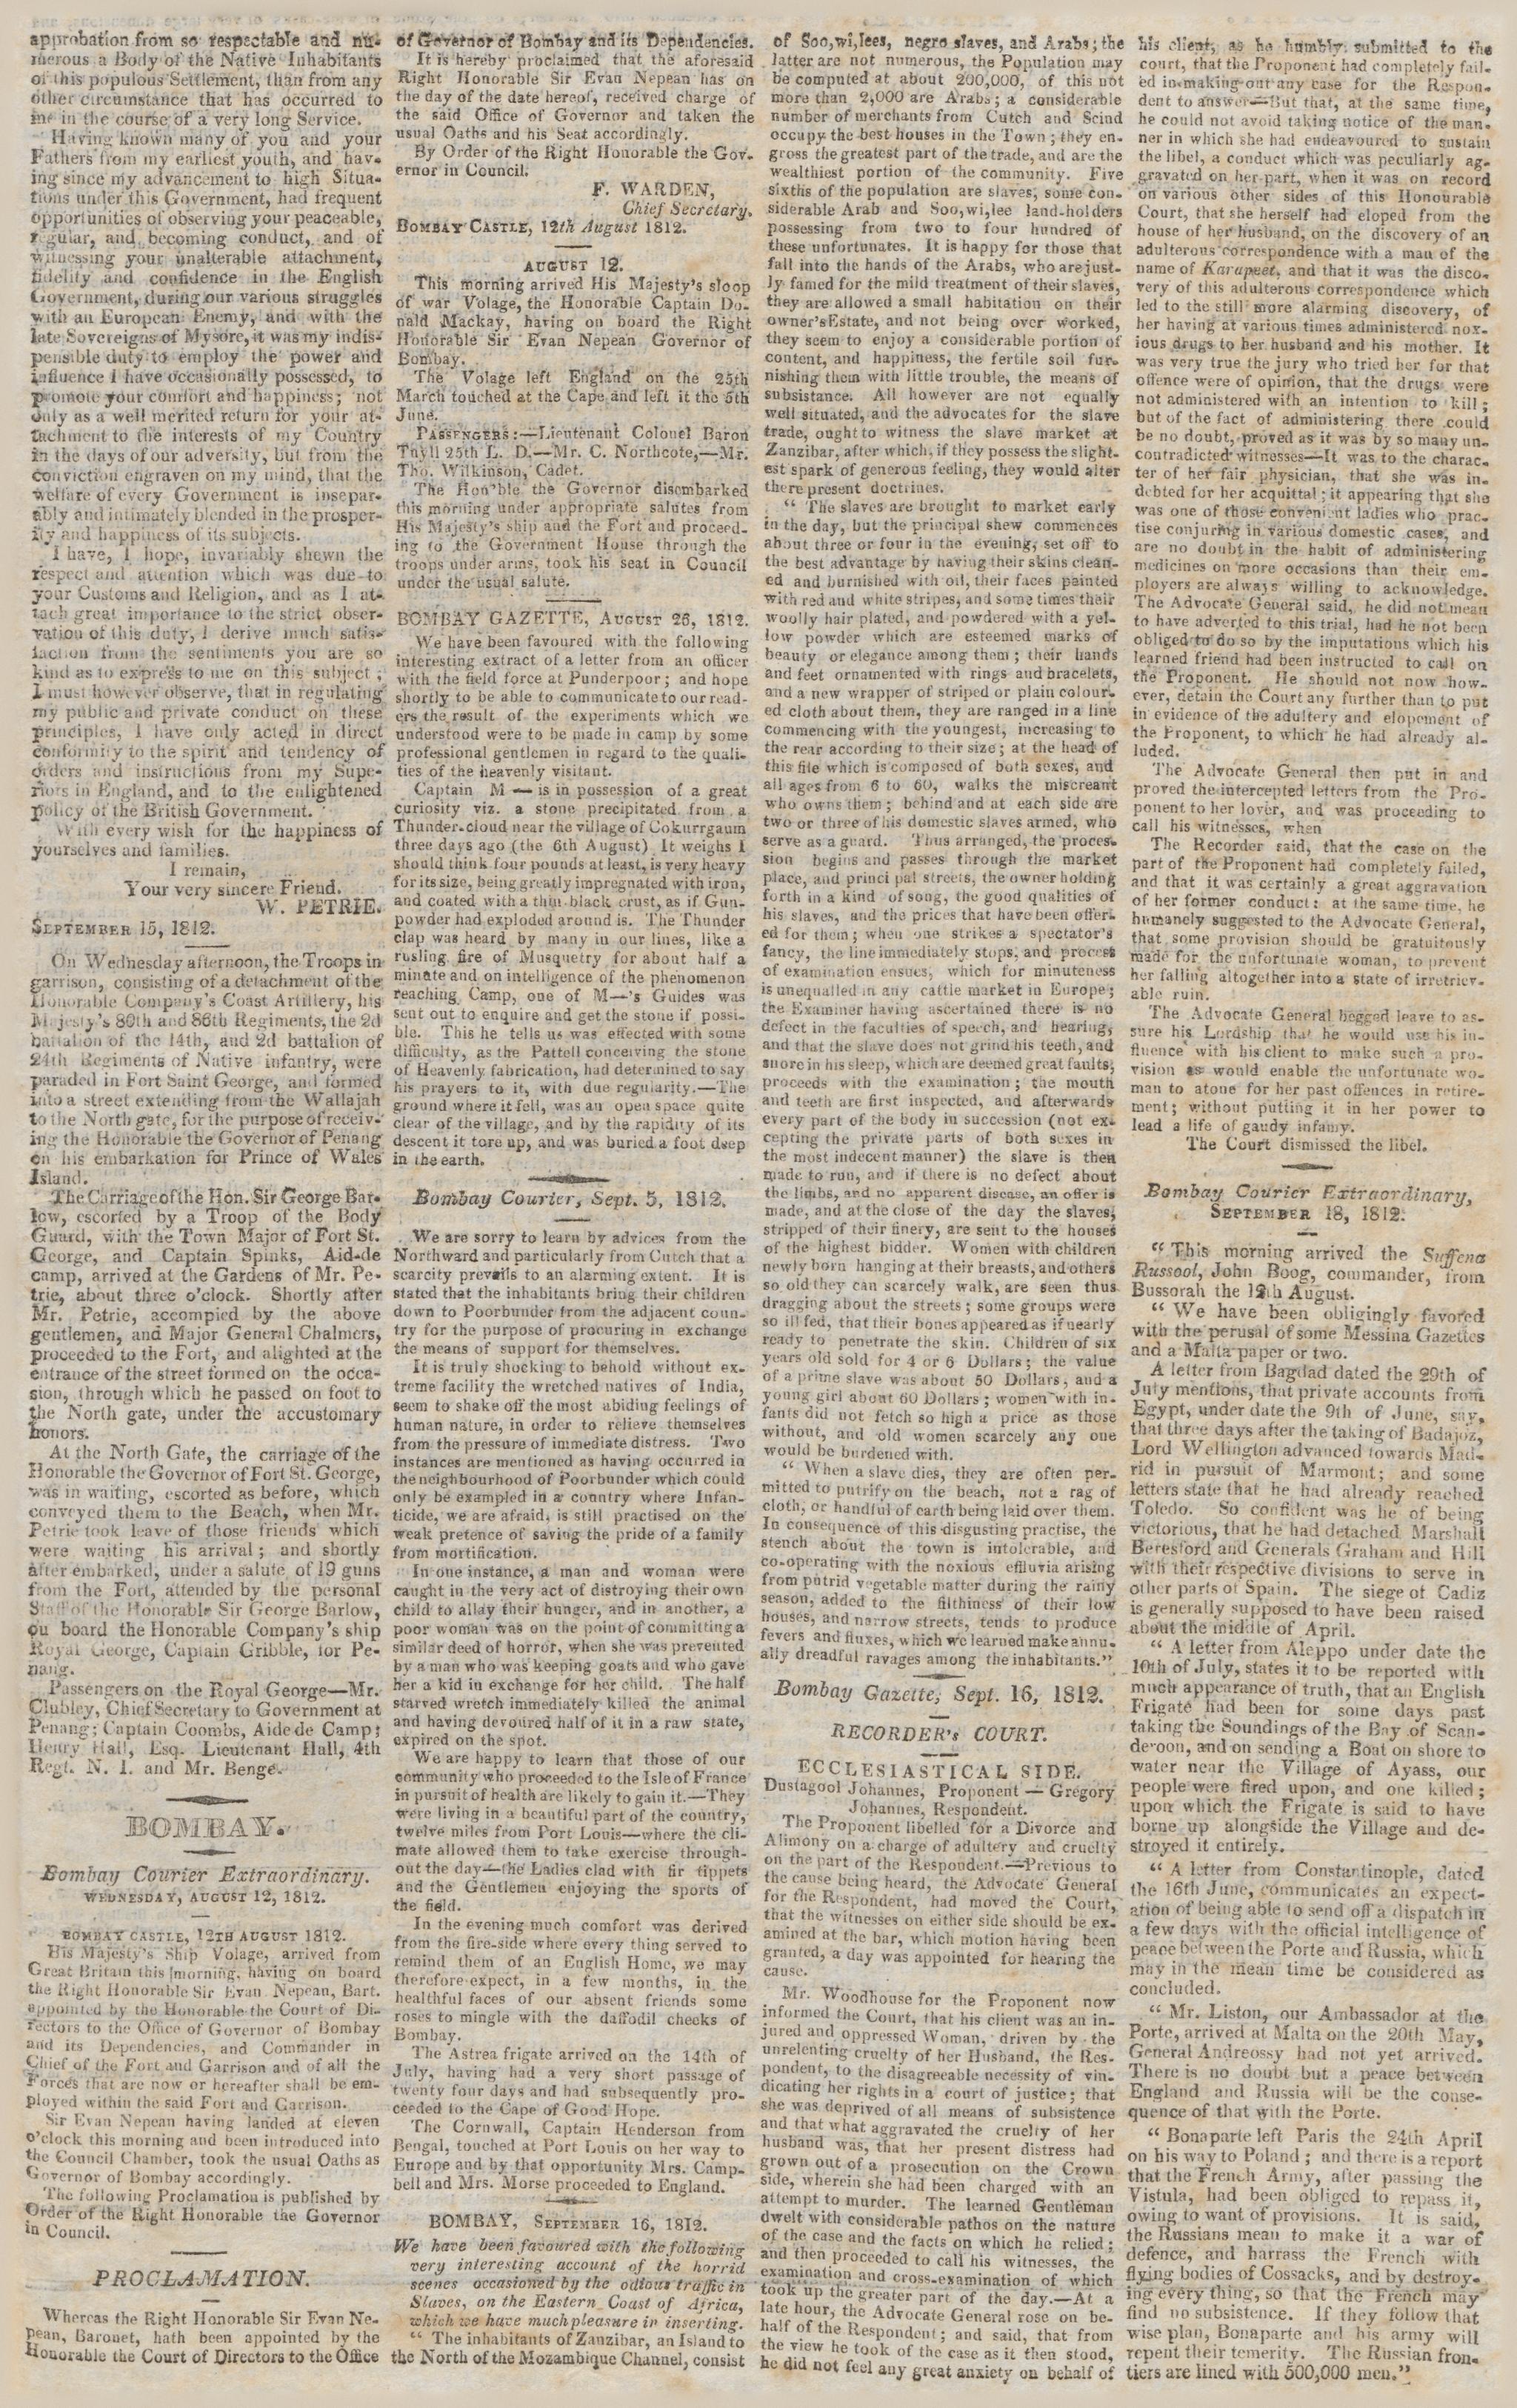
한 개발자가 약 400년에 걸친 디지털 아카이브를 AI에게 읽혀봤더니, 학계에서 잊혀졌던 운석 기록과 자취를 감춘 코뿔소에 대한 기록 같은 ‘보물’이 튀어나왔다는 경험담을 블로그에 올렸어요. 거창한 연구소 프로젝트가 아니라 개인이 해볼 수 있는 규모라는 점이 특히 흥미로워요.
왜 이게 지금 가능해졌을까요? 지난 20여 년 동안 전 세계 도서관과 박물관은 엄청난 양의 옛 책, 신문, 학회지, 탐험 기록을 스캔해서 온라인에 올렸어요. 그런데 대부분은 ‘디지털화는 됐지만 아무도 끝까지 읽지 않은’ 상태로 잠들어 있어요. 비유하자면 창고 문은 활짝 열어뒀는데 안에 불이 하나도 안 켜져 있는 거죠. LLM은 이 창고에 처음으로 손전등을 들고 들어갈 수 있게 해준 도구인 셈이에요.
왜 지금까지 못 찾았을까?
그냥 검색하면 되는 거 아니냐고 생각할 수 있는데, 옛 기록은 키워드 검색이 잘 안 먹혀요. 이유가 세 가지쯤 있어요.
첫째는 OCR 품질이에요. OCR은 이미지 속 글자를 텍스트로 바꿔주는 기술인데, 옛 활자체나 번진 잉크, 손글씨 앞에서는 오류가 많아요. 예를 들어 옛 영어 인쇄물은 s를 ‘ſ(긴 s)’로 찍은 경우가 많아서, OCR이 이걸 f로 읽으면 stone(돌)이 ftone으로 저장돼버려요. 그러면 검색에 안 걸리죠.
둘째는 표현 자체가 달라요. 몇백 년 전 사람들은 운석을 meteorite라고 부르지 않았을 수 있어요. ‘하늘에서 불덩이가 떨어져 들판에 돌이 박혔다’ 같은 식으로 묘사했겠죠. 동물 이름 표기도 시대와 지역마다 제각각이고요. 키워드 검색은 ‘정확히 그 단어’를 찾는 방식이라 이런 기록을 놓쳐요.
셋째는 양이 너무 많다는 거예요. 사람이 수백 년 치를 다 읽는 건 사실상 불가능하죠.
LLM은 이 세 가지를 한꺼번에 건드려요. 단어가 아니라 의미를 이해하니까 ‘불덩이가 떨어져 돌이 박혔다’를 운석 낙하 기록으로 알아보고, OCR 오류가 좀 있어도 문맥으로 메워서 읽어내고, 지치지도 않거든요.
직접 해본다면: 흔히 쓰는 파이프라인
원문 블로그의 구체적인 구현과는 다를 수 있지만, 이런 ‘아카이브 발굴’ 작업은 보통 이런 단계로 짜게 돼요.
1. 소스 수집: Internet Archive, Biodiversity Heritage Library(옛 자연사 문헌 아카이브), 미국 의회도서관의 Chronicling America(옛 신문) 같은 퍼블릭 도메인 아카이브를 활용해요.
2. 텍스트 정리: 기존 OCR 텍스트를 쓰거나, 품질이 너무 나쁘면 비전 모델로 다시 읽혀요.
3. 1차 필터링: 저렴한 소형 모델로 ‘이 페이지에 특이한 자연현상이나 생물 관찰 기록이 있나?’만 빠르게 판별해요. 비용 대부분은 여기서 아낄 수 있어요.
4. 구조화 추출: 걸러진 후보만 고성능 모델에 넘겨서 날짜, 장소, 사건, 그리고 원문 인용을 JSON으로 뽑아요.
5. 현대 데이터와 대조: 예를 들어 운석이라면 국제운석학회가 관리하는 Meteoritical Bulletin Database에 이미 등록된 건지 확인해요. 등록이 안 돼 있다면 그게 바로 ‘잊혀진’ 후보가 되죠.
6. 사람의 검증: 마지막엔 반드시 사람이 원문을 직접 확인해요.
개발자에게 익숙한 말로 바꾸면, 이 작업의 진짜 가치는 ‘옛 기록’과 ‘지금 우리가 아는 것’ 사이의 diff를 뽑는 것이에요. AI가 뭔가를 읽어냈다는 것보다, 현대 데이터베이스에 없는 항목을 골라내는 단계가 발견을 만들어요.
꼭 기억해야 할 함정도 있어요. LLM은 환각, 그러니까 그럴듯한 거짓말을 만들어낼 수 있어요. 그래서 추출할 때 원문 문장과 페이지 위치를 반드시 함께 뽑게 하고, 그 문장이 원문에 실제로 존재하는지 코드로 문자열 대조를 해보는 게 좋아요. 이 단계 하나로 엉터리 ‘발견’ 대부분을 걸러낼 수 있거든요.
업계 맥락: 크라우드소싱에서 AI로
옛 기록에서 지식을 캐내는 시도 자체는 새롭지 않아요. 시민과학 플랫폼 Zooniverse의 Old Weather 프로젝트는 자원봉사자들이 옛 선박 항해일지를 한 줄씩 옮겨 적어서 과거 기후 데이터를 복원했어요. 손글씨 인식 플랫폼 Transkribus는 유럽 기록관들이 고문서를 판독하는 데 널리 쓰이고 있고요. 화산 폭발로 숯덩이가 된 고대 두루마리를 머신러닝으로 읽어낸 Vesuvius Challenge도 같은 흐름에 있어요.
달라진 점은 ‘1차 독자’가 사람에서 AI로 바뀌고 있다는 거예요. 예전엔 수천 명이 나눠 읽어야 했던 일을 이제는 개인이 API 비용 정도로 시도해볼 수 있어요. 사람은 AI가 골라낸 후보를 검증하고 해석하는, 더 가치 있는 일에 집중하게 되고요.
한국 개발자에게 주는 시사점
한국에도 이런 실험을 해볼 만한 거대한 아카이브가 있어요. 국사편찬위원회의 조선왕조실록과 승정원일기, 한국고전번역원의 한국고전종합DB, 네이버 뉴스 라이브러리의 옛 신문들이 대표적이에요. 실제로 조선왕조실록에 남은 혜성과 유성 관측 기록은 천문학 연구에 활용돼 왔어요. 조선시대 호랑이와 표범 출몰 기록을 모아 한반도 대형 포식자의 분포를 복원해보는 것도 충분히 해볼 만한 사이드 프로젝트죠.
회사 업무에도 그대로 써먹을 수 있어요. 오래된 사내 위키, 이슈 트래커, 회의록을 이 방식으로 훑으면 ‘이 시스템이 왜 이렇게 설계됐는지’ 같은 잊혀진 결정 이유를 찾아낼 수 있어요. 참고로 이건 흔히 쓰는 RAG(질문하면 관련 문서를 찾아서 답해주는 방식)와 결이 달라요. RAG가 ‘뭘 모르는지 알 때’ 쓰는 도구라면, 전수 스캔은 ‘뭘 모르는지조차 모를 때’ 쓰는 도구거든요.
마무리
AI의 가치는 새로운 걸 만들어내는 데만 있지 않고, 이미 기록돼 있었지만 아무도 읽지 않은 것을 다시 읽어내는 데에도 있어요.
여러분이라면 어떤 아카이브에 AI를 돌려보고 싶으세요? 조선왕조실록, 옛 신문, 아니면 회사의 10년 묵은 위키?
🔗 출처: Hacker News