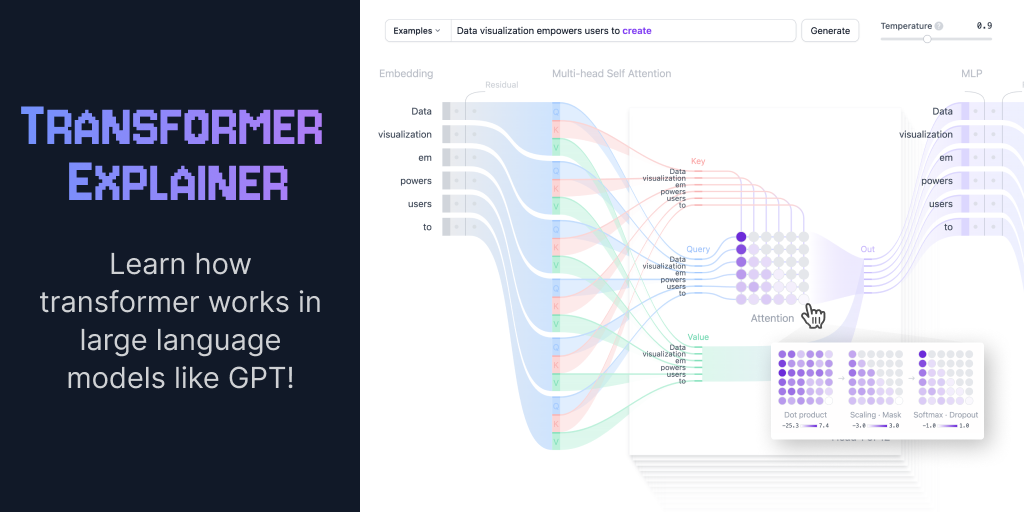
거대 언어 모델(LLM)이 실무 곳곳에 스며들었지만, 정작 그 내부에서 무슨 일이 벌어지는지는 여전히 블랙박스처럼 여겨진다. 조지아공대 연구진(Aeree Cho, Grace C. Kim, Alexander Karpekov 등)이 공개한 'Transformer Explainer'는 이 간극을 시각화로 메우려는 시도다. 실제 GPT-2 스몰(파라미터 1억 2,400만 개) 모델을 브라우저에서 그대로 구동하며, 사용자가 입력한 프롬프트가 토큰으로 쪼개지고 확률 분포를 거쳐 다음 단어로 이어지는 과정을 단계별로 보여준다. 최신 모델은 아니지만 현재 최고 성능 모델과 아키텍처의 뼈대를 공유하기에, 기초를 익히기에는 오히려 적합한 출발점이다.
텍스트가 숫자로 바뀌는 첫 관문
트랜스포머는 2017년 논문 'Attention is All You Need'에서 처음 제시된 이후 GPT, 라마, 제미나이를 비롯한 생성 모델의 표준 구조로 자리 잡았고, 텍스트를 넘어 오디오 생성·이미지 인식·단백질 구조 예측·게임 플레이까지 확장됐다. 그 작동 원리의 핵심은 의외로 단순하다. 주어진 입력 다음에 올 가장 확률 높은 토큰(단어 또는 단어의 일부)을 예측하는 것, 즉 '다음 토큰 예측'이다.
모델이 텍스트를 처리하려면 먼저 숫자로 변환해야 한다. 예를 들어 "Data visualization empowers users to"라는 문장은 토큰화 단계에서 잘게 나뉜다. 'Data'와 'visualization'은 각각 하나의 토큰이 되지만 'empowers'는 두 개로 쪼개진다. GPT-2의 어휘 사전은 5만 257개의 고유 토큰으로 구성되며, 각 토큰은 768차원 벡터로 표현된다. 이 임베딩 행렬은 (50,257, 768) 형태로 약 3,900만 개의 파라미터를 담고 있어, 의미가 비슷한 토큰끼리는 고차원 공간에서 가깝게 배치된다. 여기에 각 토큰의 문장 내 위치 정보를 담은 위치 인코딩을 더해 최종 임베딩이 완성된다. GPT-2는 이 위치 인코딩 행렬을 학습 과정에서 직접 훈련시킨다.
어텐션과 MLP가 반복되는 12개의 블록
임베딩이 준비되면 트랜스포머 블록이 본격적인 처리를 맡는다. 각 블록은 멀티헤드 셀프 어텐션과 다층 퍼셉트론(MLP)으로 구성되며, GPT-2 스몰은 이런 블록을 12개 쌓아 올렸다. 토큰의 표현은 첫 블록에서 마지막 블록으로 흐르며 점점 더 정교해진다. 셀프 어텐션의 핵심은 각 토큰의 임베딩을 쿼리(Q)·키(K)·값(V) 세 벡터로 변환한 뒤, 이들로 어텐션 점수를 계산해 어떤 토큰에 얼마나 주목할지 정하는 것이다. 이 과정은 12개의 헤드로 나뉘어 병렬로 이뤄지는데, 어떤 헤드는 짧은 범위의 문법적 연결을, 다른 헤드는 넓은 의미적 맥락을 포착한다. 또한 마스킹을 적용해 미래 토큰을 미리 참조하지 못하도록 막는다.
어텐션을 거친 결과는 MLP 층으로 넘어간다. MLP는 768차원을 3,072차원으로 네 배 확장했다가 다시 768차원으로 압축하는 두 번의 선형 변환과 그 사이의 GELU 활성화 함수로 이뤄진다. 확장 단계에서는 원래 차원에서 보이지 않던 복잡한 패턴을 포착하고, 압축 단계에서는 그 비선형 변환의 이득을 유지한 채 크기를 되돌린다. 어텐션이 토큰들 사이의 정보를 뒤섞는다면, MLP는 각 토큰을 독립적으로 처리한다는 점이 다르다.
온도와 샘플링, 출력을 조율하는 손잡이
모든 블록을 통과한 표현은 마지막 선형 층에서 5만 257차원 공간으로 투영되어 각 토큰마다 로짓(logit) 값을 얻는다. 여기에 소프트맥스를 적용하면 합이 1이 되는 확률 분포로 바뀌고, 이 분포에서 다음 토큰을 샘플링한다. 이때 온도(temperature) 하이퍼파라미터가 결정적 역할을 한다. 연산 자체는 로짓을 온도로 나누는 단순한 것이지만, 값을 낮추면 결정적이고 안정적인 출력이, 높이면 다양한 출력이 나온다. 여기에 top-k와 top-p를 함께 조정하면 결정성과 다양성 사이의 균형을 실무 목적에 맞게 조율할 수 있다. 프롬프트 엔지니어링에서 흔히 만지는 이 값들이 실제로 어느 지점에서 작동하는지 눈으로 확인할 수 있다는 점이 이 도구의 실용적 가치다.
이 밖에도 층 정규화(Layer Normalization), 드롭아웃, 잔차 연결(Residual Connection)이 성능을 뒷받침한다. 층 정규화는 학습을 안정시켜 수렴을 돕고 각 블록에서 어텐션과 MLP 앞에 두 번 적용된다. 드롭아웃은 학습 중 일부 가중치를 무작위로 0으로 만들어 과적합을 막지만 추론 시에는 비활성화된다. 2015년 ResNet에서 도입된 잔차 연결은 층을 건너뛰는 지름길을 만들어 기울기 소실 문제를 완화하며, GPT-2에서는 각 블록 내 MLP 전후로 두 번 쓰인다.
실무자가 얻을 수 있는 것과 한계
이 도구는 안드레이 카파시의 nanoGPT PyTorch 구현을 ONNX 런타임으로 변환해 브라우저에서 직접 돌리며, Svelte와 D3.js로 시각화를 구성했다. 사용자가 입력을 바꾸면 수치가 실시간으로 갱신되어 인과 관계를 직관적으로 파악하기 좋다. 다만 대상이 GPT-2 스몰이라는 점은 분명한 한계다. 최신 모델이 채택한 회전 위치 임베딩이나 대체 어텐션 기법, 대규모 파라미터에서만 드러나는 창발적 특성은 이 시각화로 확인할 수 없다. 그럼에도 토큰화, 임베딩, 셀프 어텐션, 샘플링이라는 골격은 최신 모델에도 그대로 이어지므로, LLM을 서비스에 붙이거나 프롬프트를 다루는 실무자가 '왜 이렇게 동작하는가'를 스스로 설명할 수 있게 되는 데 유용한 참고 자료다.