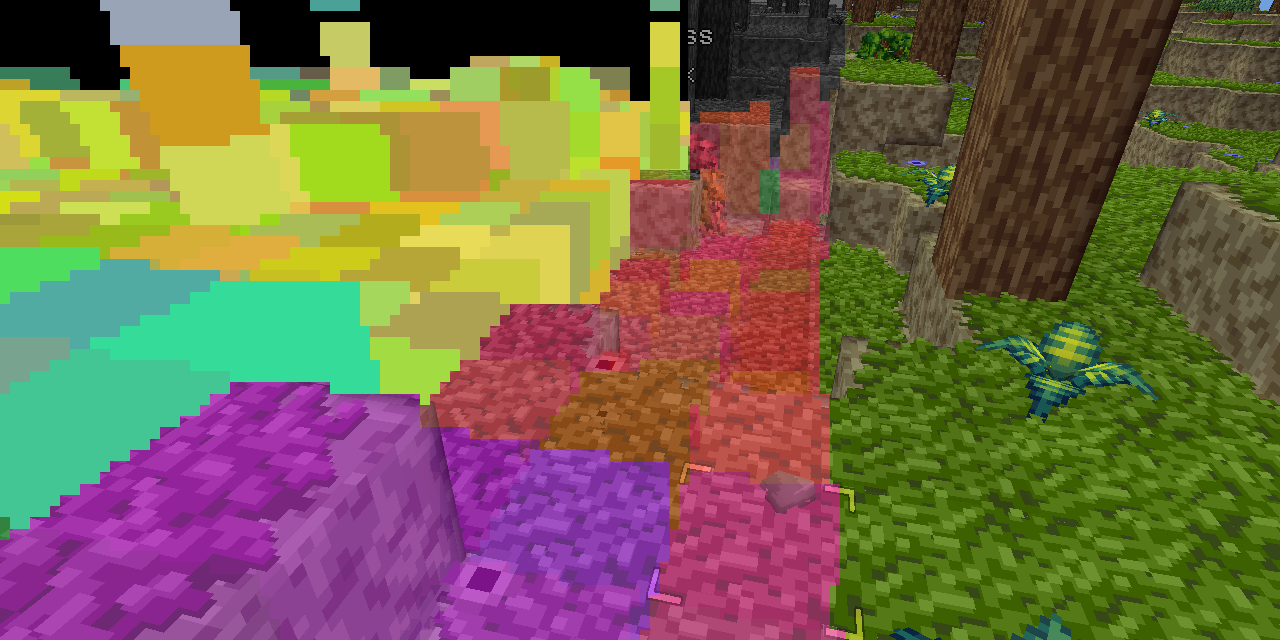
고사양 그래픽 카드를 전제로 최적화를 짜는 것은 편하지만, 실제 사용자층은 낡은 노트북이나 내장 그래픽으로 게임을 돌리는 경우가 많다. 한 개인 개발자가 작업명 '블록 게임(Block Game)'에서 시도한 소프트웨어 렌더링 기반 오클루전 컬링은 바로 이런 저사양 환경을 정면으로 겨냥한 사례다. 개발자는 AMD 라이젠 7 5700G에 내장된 라데온 베가 8을 쓴다고 밝혔는데, 이 iGPU조차 2012년에 산 저가 노트북 GPU를 UserBenchmark 기준 48% 앞서는 정도라며 자신의 작업 환경이 결코 강력하지 않음을 강조한다. '감자 같은 기기에서도 잘 돌아가는 게임'을 만들겠다는 것이 이 작업의 출발점이다.
왜 GPU가 아니라 CPU인가
오클루전 컬링의 기본 개념은 단순하다. 장면의 깊이 버퍼(depth buffer)를 만들어 두고, 그려야 할 대상의 픽셀이 그 버퍼에서 하나라도 앞에 보이면 '보임', 전부 가려지면 '컬링(생략)'으로 판정한다. 현대적 기법이라면 계층적 Z 버퍼, GPU 활용, 모션 벡터를 통한 이전 프레임 재사용, 비동기 리드백 등을 동원할 수 있다. 그러나 이 개발자는 FNA 프레임워크로 게임을 만들고 있어 상대적으로 오래된 기술에 묶여 있고, GPU에서 깊이 버퍼를 되읽어 오려면 비동기가 아닌 동기 리드백뿐이라 GPU 정지(stall)를 피할 수 없다. 그래서 아예 CPU에서 직접 깊이 버퍼를 렌더링하는 길을 택했다. 블록 게임 특유의 축 정렬된 정육면체 구조와 지하 동굴처럼 숨겨진 지오메트리가 많다는 특성이 이 단순한 접근을 유리하게 만든다.
큐브를 큐브로 가리는 구조
핵심 구현은 256x128 픽셀이라는 낮은 해상도의 깊이 버퍼(단순한 float 배열)에 큐브를 그리고, 다시 다른 큐브를 그 버퍼에 대조해 판정하는 방식이다. 16x16x16 크기의 청크가 변경으로 재구성될 때, 개발자는 밉맵과 비슷한 5단계의 오클루더(가림막) 체인을 미리 구축한다. 가장 세밀한 단계에서는 보이는 면을 가진 완전 불투명 블록을 오클루더로 표시하고, 단계를 내려가며 전부 불투명 블록으로 채워지고 보이는 면을 가진 큐브 묶음을 상위 오클루더로 삼는다. 카메라 위치가 갱신되면 렌더러는 주변 청크를 모아 보이는 면이나 엔티티가 없는 것을 버리고 월드 공간에서 절두체 컬링을 한 뒤, 남은 청크를 오클루전 컬러로 넘긴다. 개별 블록 오클루더는 카메라 반경 20블록 이내에서만 모으고, 나머지 단계는 청크 거리에 따라 수집한다. 흥미롭게도 8x8x8 오클루더는 많지만 16x16x16 오클루더는 거의 나타나지 않는다고 한다.
연산 자체도 저사양을 의식해 다듬었다. 표준적인 4x4 투영 행렬 곱은 16회 곱셈과 나눗셈, 이후 버퍼 크기 곱까지 합쳐 곱셈 21회에 나눗셈 1회를 요구한다. 대신 이 구현은 3x3 회전 행렬 곱과 덧셈 기반 이동을 쓰고, 텍스처를 그릴 일이 없으니 z축 깊이를 스케일하지 않고 선형 뷰 공간 깊이를 그대로 사용한다. 그 결과 곱셈 13회, 나눗셈 1회로 줄어 곱셈량이 62% 수준이 됐다. 또 삼각형이나 면을 실제로 래스터화하는 대신, 버퍼의 각 행마다 최소·최대 x 좌표를 담는 1차원 배열로 큐브의 '윤곽'만 추적한다. 8개 코너의 최소·최대 y를 찾고 12개 모서리를 훑으며 각 행의 x 범위를 기록한 뒤, 행별로 가장 먼 깊이 값을 채워 넣는 식이다.
오클루전 후보 판정은 반대로 가장 가까운 거리를 기록하며, 깊이가 버퍼의 어느 값보다 작거나 같으면 그 지점에서 보이는 것으로 확정하고 검사를 멈춘다. 실제 판정에서 특히 눈여겨볼 두 가지 안전장치가 있다. 하나는 오클루더 큐브를 가로세로로 1픽셀씩 줄여, 낮은 해상도 탓에 실제로는 보일 청크가 잘못 가려지는 위양성(false positive)을 막는 것이다. 다른 하나는 후보 청크의 코너 정점이 카메라 근평면 뒤에 놓여 유효하지 않을 경우, 검사를 수행할 수 없으므로 그냥 '보임'으로 처리해 안전 쪽으로 기운다는 점이다. 데이터 수집이 끝나면 오클루전 컬러는 더 이상 청크 원본 데이터를 건드리지 않아 스레드 안전성이 확보되고, 실제 작업은 백그라운드 스레드로 넘어간다.
처음부터 매끄럽진 않았다
이 시스템이 처음부터 완성형이었던 것은 아니다. 초기 버전은 청크를 고정 개수(모서리당 2개 또는 4개)의 서브청크로 나눠 불투명 여부만 기록하고, 정식 절두체 컬링도 없이 전체 4x4 행렬 변환을 돌렸다. 결과적으로 컬링은 '작동'했지만 렌더 거리 12청크에서 처리에 150~200밀리초가 걸릴 만큼 느렸다. 개발자 스스로도 이 격차를 최적화로 메울 수 있을지 불안했다고 털어놓는다. 앞서 언급한 연산 축소와 윤곽 추적, 오클루더 수를 거리로 제한하는 조치들이 이 간극을 메운 최적화의 실체다.
최종 성과는 기대 이상이었다. 스레드 처리 기준 60 FPS 이하에서 반 프레임 안에 끝나고, 절두체 컬링을 통과한 청크의 최소 50% 이상을 추가로 걸러낸다. 지평선을 바라보는 지상에서는 50~60%, 실내나 지하 동굴에서는 최대 95%까지 컬링돼 약한 시스템에서도 400 FPS를 넘긴다고 한다. 다만 개발자는 이 방식이 무너지는 예외 상황이 존재한다고 밝히면서도 이 발췌 범위에서는 구체적으로 다루지 않았다. 한국의 인디·소규모 게임 개발자에게 이 사례가 주는 시사점은 분명하다. GPU 최신 기능에 기대지 않고도, 도메인의 기하학적 특성(축 정렬 큐브)과 낮은 해상도 버퍼, 스레드 분리, 연산량 자체를 줄이는 수학적 단순화만으로 저사양 타깃에서 실용적인 가시성 컬링을 확보할 수 있다는 점이다. 동시에 낮은 해상도가 필연적으로 부르는 위양성과 근평면 예외 처리를 어떻게 보수적으로 설계하느냐가 이런 접근의 성패를 가른다는 점도 함께 기억할 만하다.