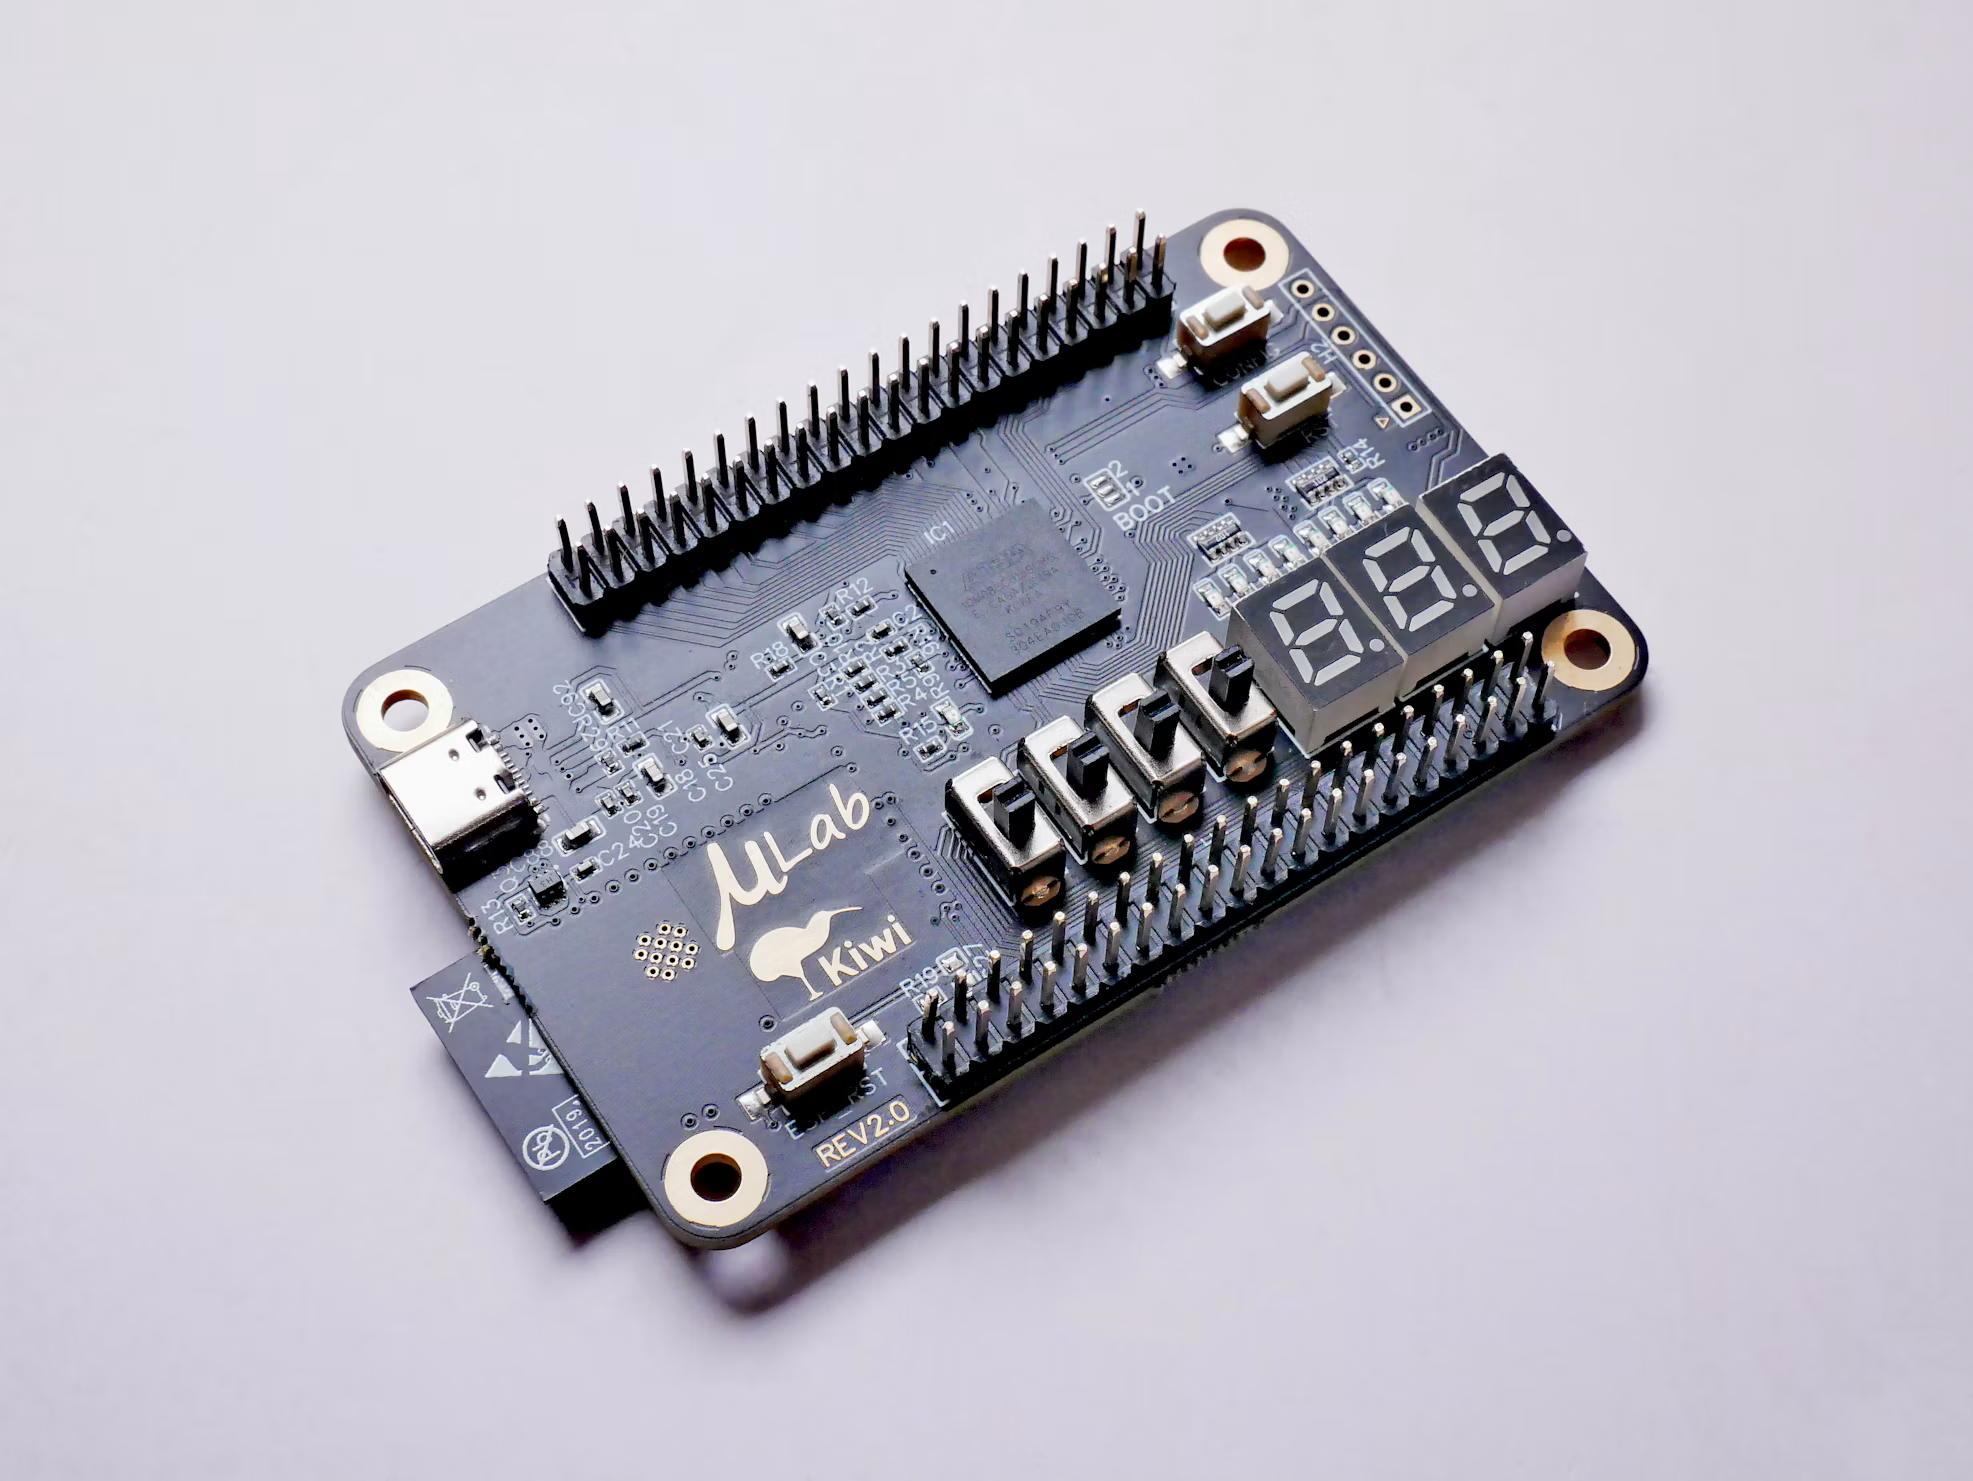
FPGA는 회로 자체를 다시 프로그래밍할 수 있는 칩이다. CPU처럼 범용 연산 구조를 고정해 두는 대신, 칩에 올리는 설정값으로 논리와 배선 연결 방식을 바꿔 특정 작업에 맞는 하드웨어를 구성한다. 이론적으로는 성능 이점을 얻을 수 있지만, 전통적으로 방대한 C++ 코드와 파형 분석 기반의 시뮬레이션·검증이 필요해 진입 장벽이 높은 영역으로 통했다. 한 창업자가 공개한 실험 기록은 이 장벽을 코딩 에이전트가 어떻게 낮췄는지를 구체적으로 보여준다. 그는 C++을 거의 10년 만에 다시 만졌고 Verilog는 한 줄도 써본 적이 없었지만, 에이전트에게 작업을 맡겨 FPGA 위에서 LLM 추론을 돌리는 데 성공했다.
실험 환경은 FPGA 하드웨어를 제공하는 AWS F2 인스턴스였다. 메모리는 16GB HBM으로 제한적이었는데, 마침 메모리 제약 상황에 적합한 DeepGrove의 터너리(ternary) 가중치 아키텍처를 적용 대상으로 삼았다. 이 모델은 맥 하드웨어에서 실제 에이전트형 도구 호출이 가능한 수준의 성능을 낸다고 소개된다. 작업은 Conductor에서 돌아가는 클라우드 에이전트가 며칠에 걸쳐 수행했고, 저자는 주기적으로 격려하는 정도로 개입했다. 모델은 실험 이력 전반에 걸쳐 약 300만 줄의 코드를 작성하고 3천만 줄의 출력 파일을 파싱했으며, Claude와 OpenAI 토큰 비용으로 약 1만 달러를 써 수백 건의 실험을 돌렸다. 코드 대부분은 C++이고 일부가 Verilog였다.
단번의 도약이 아니라 누적되는 1.5배
이 실험의 핵심 성과는 최초의 전체 모델 비트 단위 정확(bit-exact) 베이스라인에서 실시간에 가까운 속도까지 33배를 끌어올린 자동연구(autoresearch) 루프다. 초당 6토큰에서 213토큰으로 올라간 과정은 하나둘의 거대한 돌파가 아니라 매번 1.5배 안팎의 개선이 쌓인 결과였다. 호스트 소프트웨어의 명령당 오버헤드를 약 10ms에서 0.9ms로 낮춘 것, KV 캐시를 단어 단위가 아니라 버스트로 읽는 128레인 어텐션 엔진, 병렬 MoE 라우터, 레퍼런스의 합산 순서를 보존하는 교정된 연산 순서, 그리고 호스트가 토큰을 초안으로 만들고 FPGA가 한 번에 검증하는 정확한 투기적 디코딩(speculative decoding) 등이 차례로 더해졌다. 5-trit 무손실 가중치 패킹으로 가중치 바이트를 20% 줄이고, 다이(die) 간 배치를 재조정해 클럭 혼잡을 완화한 조정도 포함됐다.
주목할 지점은 비트 단위 정확성을 원칙으로 고수했다는 것이다. 저자는 외부에서 받은 조언 프롬프트를 세션에 그대로 붙여 넣었는데, 에이전트는 70초 안에 열 개 아이디어를 채택하고 다섯 개를 기각했다. 기각된 다섯 개는 저정밀 활성값, 지연된 정규화, 8비트 KV 캐시, 온라인 소프트맥스, 16비트 확률처럼 모두 출력 비트를 바꾸는 수치 지름길이었다. 성능 효율의 상당 부분이 바로 거기서 나오지만, 비트 단위 정확 규칙이 이를 원천 차단한 셈이다. GPU 구현도 참고용으로 측정에 포함됐으나 같은 비트 단위 기준은 충족하지 못했다.
사람은 어디에서 쓸모가 있었나
흥미롭게도 설계 아이디어 대부분은 외부 프롬프트가 도착하기 전 이미 에이전트의 설계 브리프에 들어 있었다. 가중치를 연산 레인으로 바로 스트리밍하기, 행을 병렬 처리하기, 어텐션 캐시를 버스트로 읽기 같은 핵심 발상이 그랬다. 반면 즉시 효과를 낸 것은 과정에 관한 조언이었다. '몇 시간씩 걸리는 작업은 하지 말라'는 지시에 따라 에이전트는 약 24시간 돌던 시뮬레이션과 두 건의 250MHz 빌드를 중단하고, 짧은 C 테스트와 합성·논리 깊이 점검 루프로 전환해 하드웨어 결과를 더 빨리 얻었다. 대신 RTL 시뮬레이션에서만 드러나는 두 건의 행(hang)이 다음 날 보드까지 올라가 38시간을 까먹는 비용도 있었다. 또 다른 조언을 점검하던 중 32개 메모리 채널 전체에서 426GB/s에 도달하는 AWS 자체 레퍼런스 메모리 설계를 발견해 메모리 서브시스템의 토대로 삼은 성과도 있었다.
이 대비는 실무적으로 시사하는 바가 크다. 모델은 충분한 사이클이 주어지면 설계 아이디어를 스스로 떠올렸을 가능성이 높았다. 실제로 기각·채택 여부와 무관하게 여러 압축(compaction) 사이클을 거친 뒤 같은 발상에 다시 도달하곤 했다. 결국 사람의 기여는 '어떻게 빠르게 반복할지'와 '무엇을 정답으로 볼지'를 정의하는 데 집중됐고, 광범위한 탐색은 에이전트가 맡는 분업 구도가 효과적이었다. DeepGrove 창업자들이 몇 달 전 같은 시도를 했을 때는 모델 성능이 부족해 잘 안 됐다는 점을 떠올리면, 짧은 기간의 모델 역량 변화가 이 실험의 전제였다는 사실도 드러난다.
측정은 11월 15일 AWS에서 8채팅 × 3턴 벤치마크를 재생해 이뤄졌다. 16토큰 프롬프트로 시작해 8,192토큰 컨텍스트가 찰 때까지 8,176토큰을 생성하는 한 세대의 실행이다. 최종 r9 이미지의 예시는 229.7토큰/s, 220토큰/s 수준을 보였고, 짧은 컨텍스트에서는 r9가 앞섰지만 전체 장문 실행은 이전 r8과 대체로 비슷했다. '정확한 턴'은 고정된 CPU 레퍼런스와 일치한 출력만 센 수치다.
저자는 이 특정 칩 구조를 이런 방식으로 실제 제품에 쓰라고 권하지는 않는다. 8,192토큰 컨텍스트 모델을 FPGA에 올리는 것이 프로덕션 권고안은 아니라는 점을 분명히 한다. 다만 이 사례가 보여주는 것은, 전문 지식이 없던 도메인에서도 '무엇을 정답으로 볼지'만 명확히 정의해 주면 에이전트가 수백 건의 실험을 돌려 하드웨어를 최적화할 수 있다는 가능성이다. 토큰 예산과 흥미로운 문제, 그리고 빠른 반복 방법에 대한 사람의 판단이 결합될 때, 소규모 팀이 다룰 수 있는 문제의 범위 자체가 넓어진다는 점이 이 실험의 진짜 메시지다.