초당 770 토큰이 어느 정도냐면
요즘 LLM 쓰다 보면 답변이 타자 치듯 한 글자씩 나오는 걸 보게 되죠. 그 속도가 보통 초당 50~150 토큰 정도예요. 토큰이 뭐냐면, 모델이 글을 처리하는 최소 단위인데 영어는 단어 하나가 토큰 한두 개, 한국어는 글자 한두 개가 토큰 하나쯤 돼요. 그러니까 초당 100 토큰이면 사람이 읽는 속도보다 조금 빠른 정도죠.
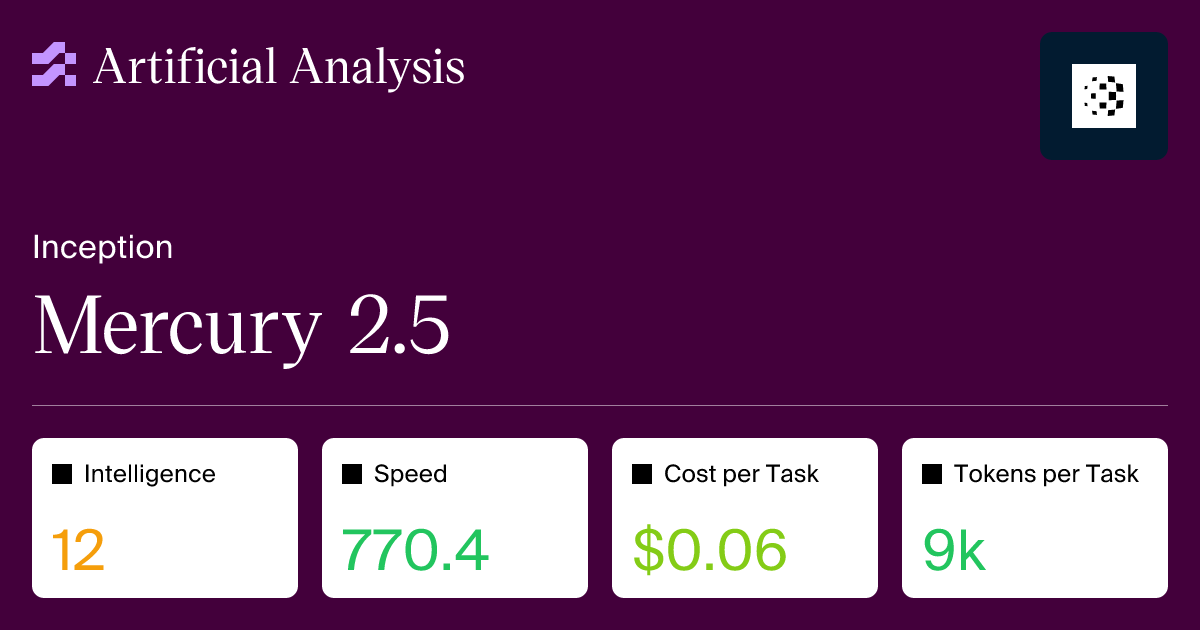
그런데 Inception Labs의 Mercury 2.5라는 모델이 독립 벤치마크 사이트인 Artificial Analysis 측정에서 초당 770 토큰을 기록했어요. 일반적인 모델의 5~10배예요. 사람이 읽는 속도는 진작에 넘어섰고, 화면에 글이 '나타나는' 게 아니라 '한꺼번에 찍히는' 수준이죠. 더 흥미로운 건 이 속도가 전용 칩이 아니라 일반적인 엔비디아 GPU에서 나온다는 점이에요. 어떻게 가능한 걸까요?
지금 LLM들은 왜 느릴까요
GPT, Claude, Gemini, Llama 같은 모델들은 전부 '자기회귀(autoregressive)' 방식이에요. 이게 뭐냐면, 지금까지 나온 글을 전부 읽고 '다음에 올 토큰 하나'를 예측하고, 그걸 붙인 다음 또 다음 하나를 예측하는 식이에요. 1000토큰짜리 답변을 만들려면 모델을 1000번 통과해야 해요.
문제는 한 번 통과할 때마다 수백 GB짜리 모델 가중치를 GPU 메모리에서 몽땅 읽어야 한다는 거예요. 계산 자체보다 '메모리에서 읽어오는 시간'이 병목이 돼요. 이걸 메모리 대역폭에 묶여 있다(memory-bound)고 해요. GPU가 아무리 계산이 빨라도, 토큰 하나 만들려고 매번 전체 가중치를 읽는 구조에서는 속도에 천장이 있어요. 그래서 Groq나 Cerebras 같은 회사는 아예 SRAM(엄청 빠르지만 비싼 메모리)을 잔뜩 박은 전용 칩을 만들어서 이 벽을 뚫었죠.
디퓨전 LLM은 다르게 만들어요
Mercury는 '디퓨전(diffusion) LLM'이에요. 이미지 생성 모델인 Stable Diffusion과 같은 원리를 텍스트에 적용한 거예요. 이게 뭐냐면, 처음부터 답변 전체 길이만큼의 '빈 칸(마스크)'을 깔아 놓고, 매 단계마다 여러 칸을 동시에 채우거나 다듬어서 몇 번 반복 끝에 완성하는 방식이에요.
비유하자면 자기회귀 모델은 받아쓰기하듯 한 글자씩 쓰는 사람이고, 디퓨전 모델은 일단 대충 초안을 전체적으로 갈겨 쓴 다음 여러 번 퇴고해서 완성하는 사람이에요. 퇴고를 열 번 한다 쳐도 1000글자를 한 글자씩 쓰는 것보다 훨씬 빠르죠.
기술적으로는 이 차이가 커요. 한 단계에서 수십, 수백 토큰을 동시에 결정하니까 모델 통과 횟수가 토큰 수보다 훨씬 적고, 한 번 통과할 때 계산량이 커지니까 GPU의 병렬 연산 능력을 제대로 써먹을 수 있어요. 메모리를 한 번 읽어서 많은 일을 하는 구조라 메모리 대역폭 병목이 완화되는 거죠. 그래서 전용 칩 없이 일반 GPU에서 저 속도가 나와요.
또 하나 장점이 있어요. 자기회귀 모델은 왼쪽에서 오른쪽으로만 보는데, 디퓨전 모델은 앞뒤 문맥을 동시에 봐요. 그래서 코드 중간을 채워 넣는 작업(fill-in-the-middle)이나 문서 일부만 고치는 편집 작업에 구조적으로 유리해요. Inception이 처음 내놓은 제품이 코딩용 모델이었던 것도 이 때문이에요.
그럼 왜 다들 안 하나요
단점도 분명해요. 아직까지 디퓨전 LLM은 최상위 프론티어 모델 수준의 지능을 보여주진 못했어요. 이전 Mercury 세대는 속도는 압도적이지만 답변 품질은 소형 모델급이라는 평가가 많았고, Mercury 2.5도 속도 숫자만 보고 판단하지 말고 Artificial Analysis의 지능 지표를 같이 확인하셔야 해요. 특히 수학이나 복잡한 추론처럼 앞 단계의 결과가 뒷 단계를 좌우하는 작업은 '한꺼번에 채우는' 방식이 불리할 수 있다는 지적이 계속 있어요.
인프라 측면도 그래요. 지금 LLM 서빙 생태계(vLLM, KV 캐시, 스트리밍 프로토콜 등)는 전부 자기회귀를 전제로 최적화돼 있어서, 디퓨전 모델은 그 이점을 다시 처음부터 만들어야 해요. 스트리밍 UX도 달라요. 한 글자씩 흘러나오는 게 아니라 문단이 통째로 나타났다가 다듬어지는 식이라 프론트엔드 처리도 손봐야 하고요.
업계 맥락: 속도 경쟁의 두 갈래
LLM 속도 경쟁은 크게 두 방향으로 갈려 있어요. 하나는 하드웨어로 뚫는 길이에요. Groq, Cerebras, SambaNova가 전용 칩으로 초당 1000~3000 토큰을 찍고 있죠. 다른 하나는 알고리즘으로 뚫는 길인데, 자기회귀 진영에서는 작은 모델이 먼저 초안을 뽑고 큰 모델이 검증하는 speculative decoding, DeepSeek가 쓰는 multi-token prediction 같은 기법이 있어요. 디퓨전 LLM은 이 두 번째 갈래에서 가장 급진적인 선택이에요. 생성 방식 자체를 바꿔 버린 거니까요.
디퓨전 진영에서는 Google의 Gemini Diffusion이 실험 버전으로 공개된 바 있고, 오픈소스로는 LLaDA, Dream 같은 모델이 나와 있어요. Inception은 이 중 처음으로 상용 API를 낸 회사고, Mercury 2.5로 그 격차를 더 벌리려는 거죠.
한국 개발자에게 주는 시사점
당장 써볼 수 있는 곳이 분명히 있어요. 첫째, 코드 자동완성이에요. 타이핑하는 사이에 제안이 떠야 하니 지연 시간이 생명인데, 초당 770 토큰이면 사용자가 인식하기 전에 결과가 나와요. 둘째, 에이전트 루프예요. 에이전트가 한 작업을 마치려고 LLM을 수십 번 호출하는 구조에서는 호출당 속도가 전체 체감 시간을 좌우하거든요. 단순한 단계는 빠른 모델에, 판단이 필요한 단계는 큰 모델에 맡기는 라우팅에 딱 맞아요. 셋째, 실시간 음성 대화나 채팅처럼 응답 대기가 UX를 망치는 서비스예요.
Mercury는 OpenAI 호환 API로 제공되니까 기존 코드에서 base URL과 모델 이름만 바꿔 끼워 보는 식으로 실험이 가능해요. 다만 한국어 품질은 영어와 다를 수 있으니, 실제 여러분 데이터로 벤치마크부터 돌려 보고 결정하세요.
정리하며
한 줄로 정리하면, Mercury 2.5는 '한 글자씩'이 아니라 '한꺼번에 채우고 다듬는' 디퓨전 방식으로, 전용 칩 없이 일반 GPU에서 초당 770 토큰이라는 속도를 낸 모델이에요. 지능은 아직 프론티어급이 아니지만, 속도가 곧 기능인 영역에서는 진지하게 고려할 만한 선택지가 됐어요.
여러분 프로젝트에서 '더 똑똑한 모델'과 '5배 빠른 모델' 중 하나를 골라야 한다면 어느 쪽을 고르시겠어요? 속도가 품질을 이기는 작업이 실제로 얼마나 될까요?
🔗 출처: Hacker News