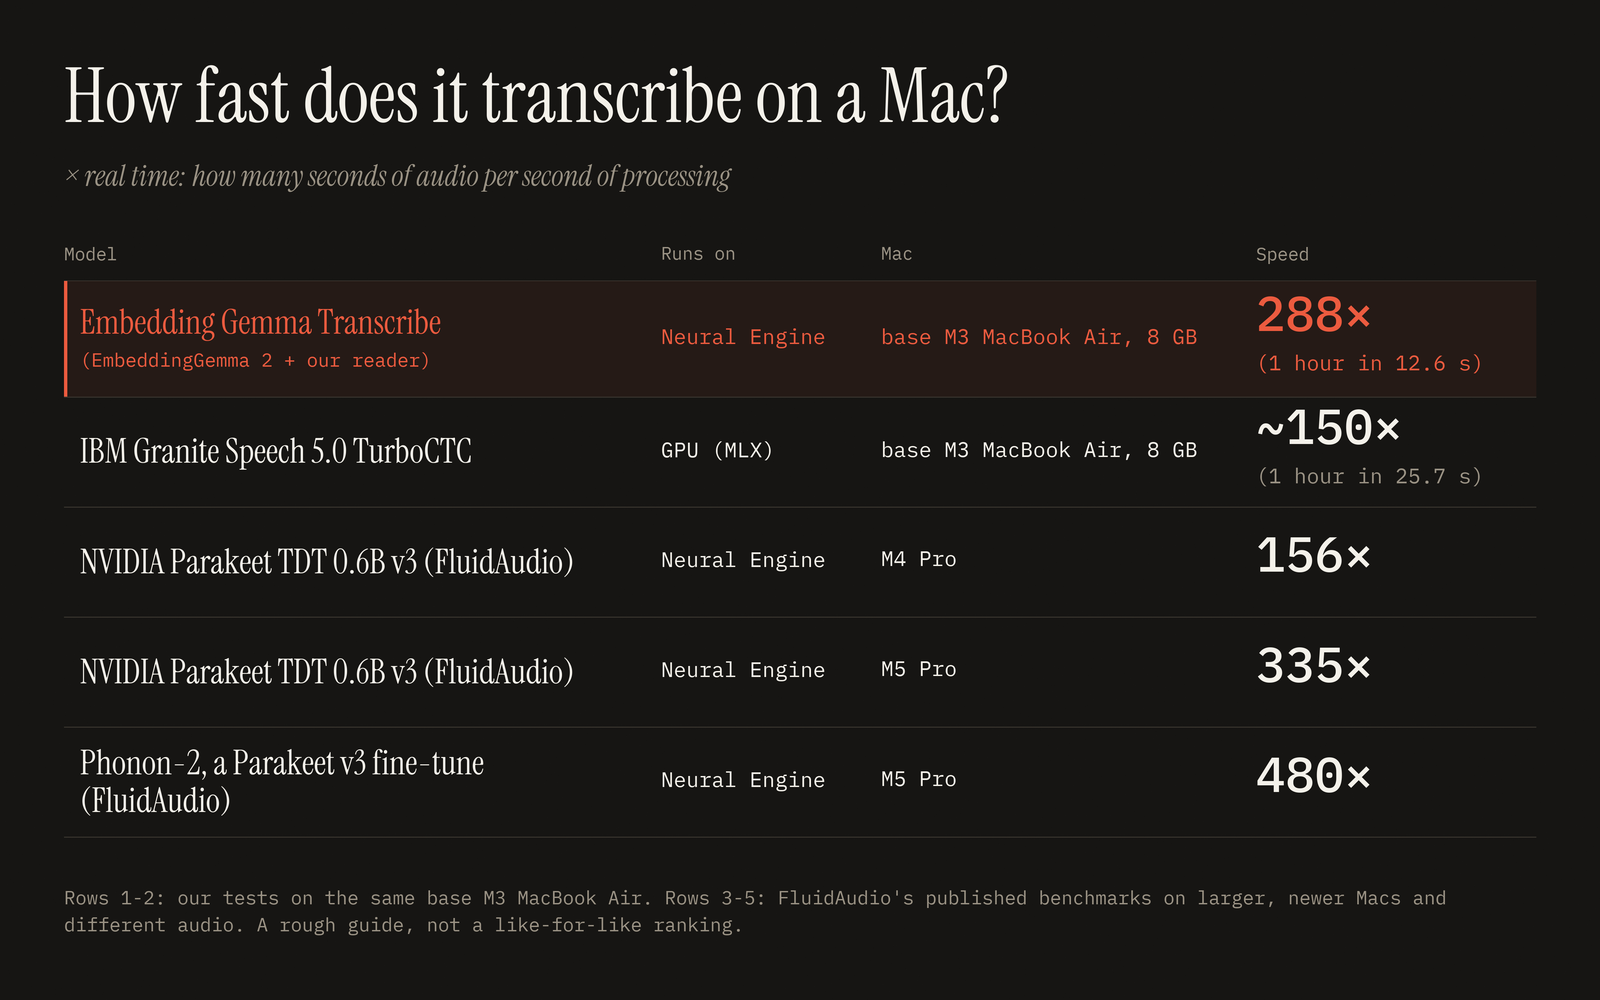
구글의 EmbeddingGemma 2는 본래 음성 인식과는 거리가 먼 모델이다. 텍스트와 이미지, 오디오, 영상을 하나의 공통 공간에 나란히 배치하는 멀티모달 임베딩 모델로, 서로 다른 형태의 데이터를 벡터로 바꿔 유사도를 비교하거나 검색에 활용하는 것이 주된 용도다. 그런데 한 개발자 그룹이 이 모델을 음성을 텍스트로 받아쓰는 도구(speech-to-text)로 변형해 공개했다. 맥북 에어에서 한 시간 분량의 오디오를 약 13초 만에, 그것도 네트워크 전송 없이 기기 안에서 처리한다는 점이 눈길을 끈다.
임베딩 공간에서 단어를 '읽어낸다'는 발상
이 실험의 출발점은 멀티모달 임베딩의 성질 그 자체다. 같은 단어를 소리 내어 말하면 그 오디오의 벡터가 글로 쓴 단어의 벡터와 가까운 위치에 놓인다. 음성과 텍스트가 이미 한 공간 안에서 서로 이웃해 있다면, 그 공간에서 단어를 직접 '읽어내는' 것도 가능하지 않겠느냐는 것이 핵심 아이디어다. 개발팀은 이 공간에서 텍스트를 끄집어내는 역할을 하는 작은 모듈, 즉 '리더(reader)'만을 따로 학습시켰다. 기반이 되는 EmbeddingGemma 2 자체는 음성 인식용으로 전혀 손대지 않았고, 음성을 글자로 옮기는 능력은 오롯이 이 리더가 담당한다.
학습 비용이 매우 가볍다는 점도 특징이다. 리더는 공개 라이선스의 영어 음성 데이터를 사용해 H100 GPU 8장으로 두 시간이 채 안 되는 시간 동안 훈련됐다. 거대한 음성 전용 모델을 처음부터 학습시키는 방식과 비교하면 자원 소모가 현저히 적다. 범용 임베딩 모델이 이미 확보한 표현력 위에 얇은 디코딩 계층만 얹어 특정 작업을 끌어낸다는 접근은, 기존 파운데이션 모델을 재활용하는 방향성을 음성 영역에서 구체적으로 보여준다.
성능의 현주소와 수치 해석의 주의점
실용성 측면에서 가장 중요한 지표는 역시 정확도다. 현재 이 방식의 단어 오류율(WER)은 약 5% 수준으로, 2~3%대를 기록하는 선도적인 음성 인식 모델에는 아직 미치지 못한다. 개발팀은 리더를 더 정교하게 훈련하면 이 격차를 좁힐 수 있다고 보고 다음 버전을 예고했다. 뒤집어 말하면 지금 공개된 결과는 완성형이 아니라 가능성을 입증하는 단계의 산출물이며, 5%라는 숫자를 그대로 상용 서비스 기준에 대입해서는 안 된다는 뜻이기도 하다.
처리 속도를 나타내는 '실시간 배수'(처리 1초당 소화하는 오디오 길이) 비교표도 해석에 조심할 필요가 있다. 개발팀은 자신들의 테스트 두 건은 동일한 기본 M3 맥북 에어에서 측정했지만, 함께 제시된 나머지 수치는 더 크고 새로운 맥에서 다른 오디오로 측정된 FluidAudio의 공개 벤치마크를 가져온 것이라고 분명히 밝혔다. 하드웨어와 입력 조건이 제각각이므로 이는 대략적인 참고용일 뿐 동일 조건의 우열 비교가 아니다. 벤치마크 숫자를 인용할 때 측정 환경을 함께 확인해야 한다는 기본 원칙을 다시 상기시킨다.
온디바이스 받아쓰기라는 실용적 지점
사용 방식은 단순하다. 오디오 파일을 끌어다 넣거나, 오른쪽 옵션(Right Option) 키를 누른 채 말하고 떼면 그 내용이 어떤 앱에든 받아써진다. 연산은 맥의 뉴럴 엔진에서 이뤄지며, 음성 데이터가 기기를 벗어나지 않는다. 받아쓰기 입력이 클라우드로 올라가는 것을 꺼리는 환경, 가령 내부 자료를 다루거나 네트워크가 불안정한 상황에서 온디바이스 처리는 분명한 이점이다.
국내 실무자 입장에서 이 프로젝트는 두 가지 층위로 읽을 수 있다. 하나는 당장 쓸 도구로서의 가치인데, 영어 음성에 한정돼 있고 정확도가 아직 전용 모델에 못 미치므로 받아쓰기 보조 수단 정도로 보는 편이 현실적이다. 다른 하나는 설계 관점의 시사점으로, 멀티모달 임베딩 공간이 이미 품고 있는 정보를 가벼운 어댑터로 끌어내 새로운 작업을 만들어낼 수 있다는 점이다. 한국어 음성이나 다른 과제에 같은 방법이 통할지는 별도의 데이터와 검증이 필요하지만, 범용 모델 하나를 여러 용도로 저렴하게 확장하는 패턴을 고민하는 이들에게는 참고할 만한 사례다.