무슨 프로젝트인가요?
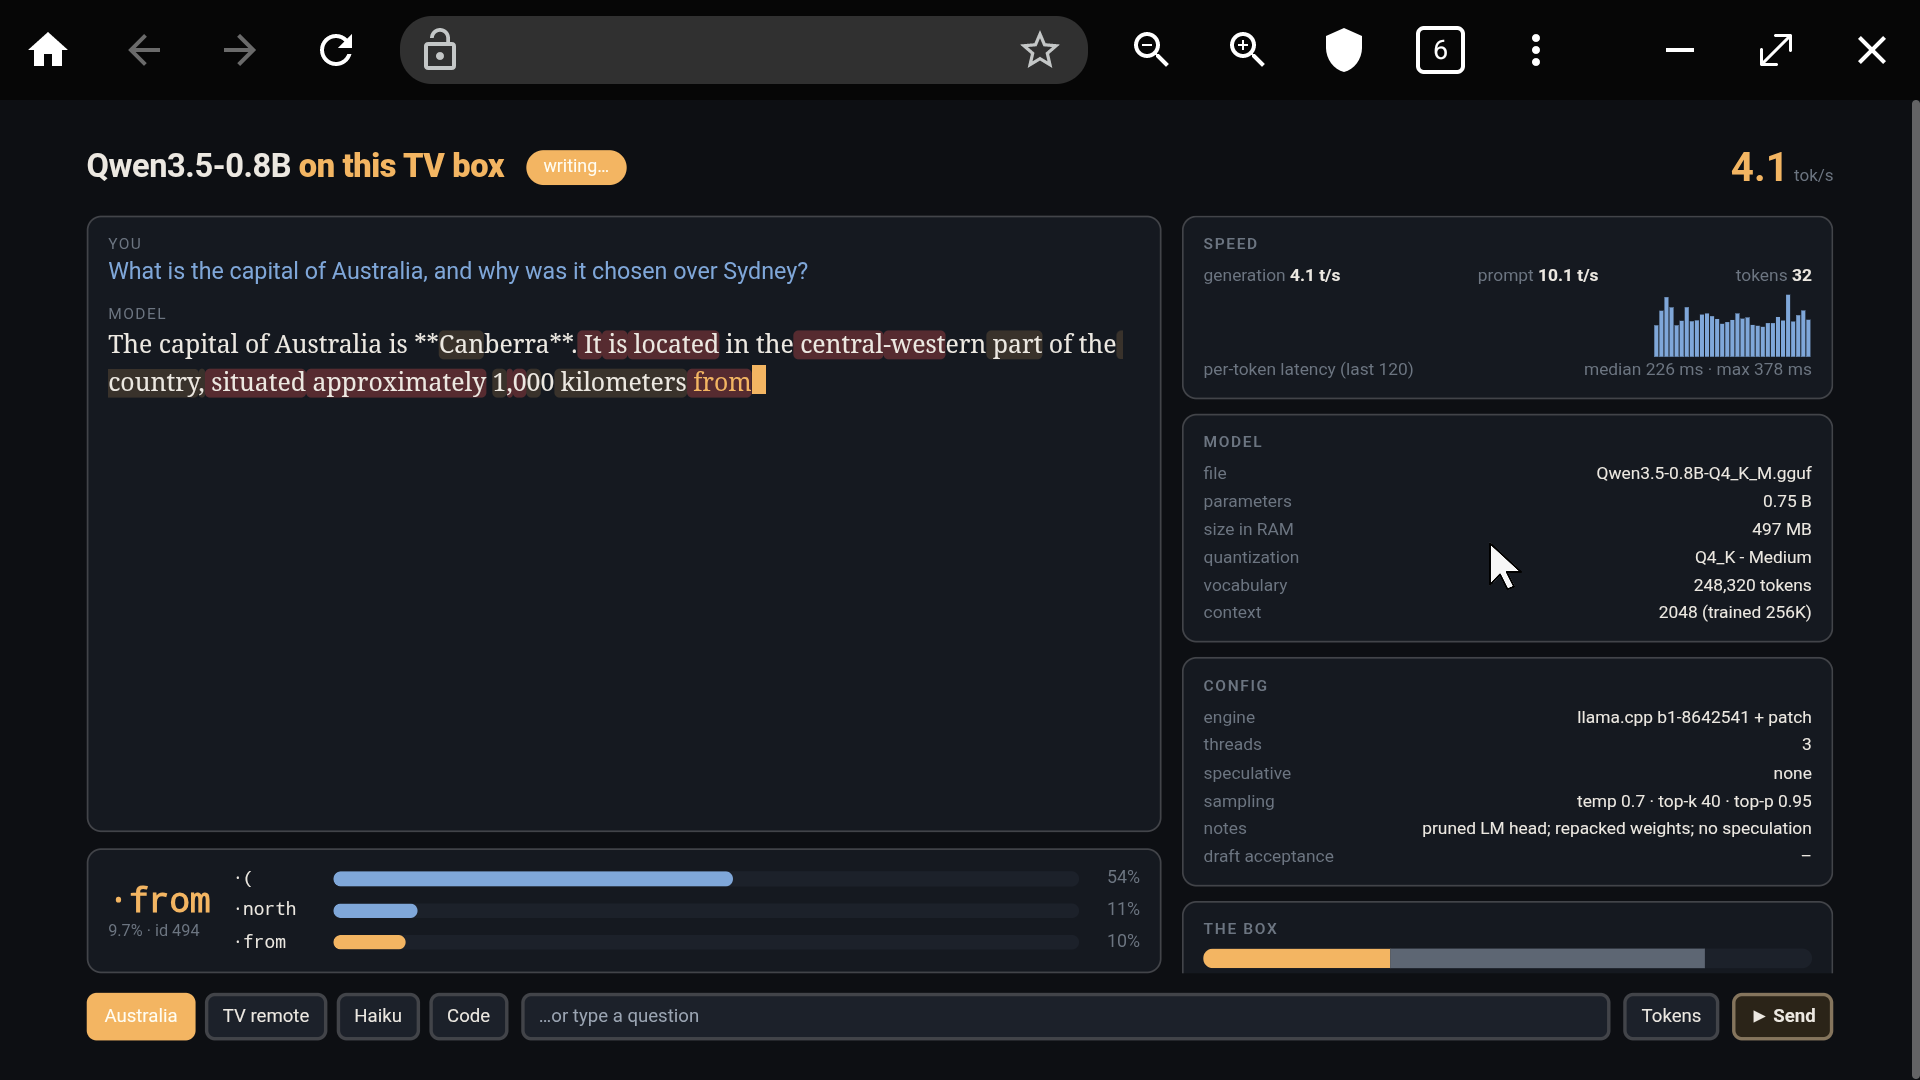
GitHub에 smolmaxxing이라는 저장소가 공개됐어요. 프로젝트를 소개하는 문장은 단순해요. '작고 오래된 기기에서 LLM이 돌아가게 만들고 있다.' 이름부터 재미있는데요, 인터넷에서 small을 귀엽게 부르는 'smol'에, 무언가를 극한까지 끌어올린다는 뜻의 '-maxxing'을 붙인 말로 보여요. 우리말로 옮기면 '작게 만들기에 진심' 정도 되겠네요.
요즘 AI 소식은 더 큰 모델, 더 비싼 GPU, 더 거대한 데이터센터 이야기가 대부분이잖아요. 이 프로젝트는 정반대 방향을 봐요. 서랍 속 구형 스마트폰, 몇만 원짜리 싱글보드 컴퓨터, 10년 넘은 노트북 같은 기기에서 언어 모델을 돌려보자는 거죠. 지원 기기 목록이나 구체적인 구현 방식은 저장소 README에서 직접 확인하시는 게 정확하고요, 이 글에서는 '작은 기기에서 LLM을 돌린다'는 일이 기술적으로 왜 어렵고 어떤 방법으로 풀어가는지를 쉽게 풀어볼게요.
왜 작은 기기에서는 LLM이 힘들까
LLM은 결국 엄청나게 큰 숫자 표예요. 이 숫자들을 파라미터(가중치)라고 부르는데, 모델이 토큰(글자 조각) 하나를 만들 때마다 이 표를 처음부터 끝까지 훑으면서 곱셈과 덧셈을 해야 해요.
여기서 벽이 두 개 생겨요. 첫 번째는 메모리예요. 파라미터가 10억 개인 모델을 숫자 하나당 16비트로 저장하면 약 2GB가 필요해요. 램이 2~3GB뿐인 구형 폰에서는 운영체제 몫을 빼고 나면 올릴 자리조차 없죠. 두 번째는 속도인데요, 의외로 CPU의 계산 능력보다 '메모리에서 숫자를 얼마나 빨리 퍼 올 수 있느냐', 즉 메모리 대역폭이 병목인 경우가 많아요. 요리사 손이 아무리 빨라도 재료가 느리게 배달되면 소용없는 것과 같아요.
오래된 기기에는 불리한 조건이 더 붙어요. 여러 숫자를 한꺼번에 계산하는 벡터 연산 명령어가 없거나 구형이고, 32비트 환경이면 프로세스 하나가 쓸 수 있는 메모리 자체가 제한되고, 조금만 돌려도 발열 때문에 스스로 성능을 낮춰버리기도 해요.
그래서 어떻게 푸나요
가장 강력한 무기는 양자화(quantization)예요. 이게 뭐냐면, 숫자를 덜 정밀하게 저장하는 거예요. 몸무게를 63.472kg 대신 63kg이라고 적어도 대부분의 상황에서는 충분하잖아요. 16비트로 저장하던 숫자를 4비트 수준으로 줄이면 모델 크기가 대략 4분의 1이 돼요. 앞에서 2GB였던 모델이 500~600MB 정도로 줄어드는 거죠. 품질은 조금 떨어지지만 4비트 근처까지는 체감 손실이 크지 않다는 게 일반적인 경험칙이에요. 다만 모델이 작을수록 양자화에 더 민감하게 반응한다는 점은 알아두세요.
두 번째는 애초에 작은 모델을 고르는 것이에요. 허깅페이스의 SmolLM 계열, 구글의 Gemma 소형 모델, 마이크로소프트의 Phi, 알리바바 Qwen의 소형 버전처럼 수억에서 수십억 파라미터 규모의 모델이 꾸준히 나오고 있어요. 범용 대화 능력은 큰 모델에 못 미치지만 요약, 분류, 간단한 질의응답, 정해진 형식으로 값 뽑아내기 같은 좁은 작업에서는 꽤 쓸 만해요.
세 번째는 실행 방식의 최적화예요. 모델 파일을 통째로 램에 복사하지 않고 디스크에서 필요한 부분만 바로 매핑해 쓰는 mmap, 한 번에 기억하는 문맥 길이 줄이기, 앞에서 계산한 중간 결과를 다시 쓰는 KV 캐시 관리 같은 것들이 여기에 들어가요. 하나하나는 소박해 보여도, 램 몇백 MB가 아쉬운 환경에서는 이런 차이가 '돌아간다'와 '안 돌아간다'를 갈라요.
비슷한 시도들과 비교하면
이 분야의 사실상 표준은 llama.cpp예요. C/C++로 작성돼 의존성이 거의 없고, GGUF라는 파일 형식과 다양한 양자화 옵션을 지원해서 라즈베리 파이부터 맥북까지 폭넓게 돌아가요. 모바일 쪽에는 메타의 ExecuTorch, 구글의 LiteRT(예전 TensorFlow Lite), MLC LLM 같은 런타임이 있고요. 다만 이 도구들의 무게중심은 대체로 '요즘 기기에서 잘 돌리기'에 있어요. 최신 칩의 NPU와 GPU를 얼마나 잘 활용하느냐가 경쟁 포인트죠.
'정말 낡은 기기'는 그동안 취미 개발자들의 놀이터였어요. 안드레이 카파시가 C 파일 하나로 작은 모델을 돌리는 llama2.c를 공개한 뒤로, 윈도 98이 깔린 펜티엄 II PC나 마이크로컨트롤러에 아주 작은 모델을 올려보는 실험이 이어졌거든요. smolmaxxing은 이런 흐름을 하나의 프로젝트로 꾸준히 밀어보려는 시도로 읽혀요. 실용성만 따지면 물음표가 붙을 수 있지만, 극단적인 제약 아래에서 쌓인 최적화 노하우는 결국 평범한 기기의 효율로 돌아와요.
한국 개발자에게 주는 시사점
실무와 맞닿는 지점이 몇 가지 있어요. 먼저 망분리 환경이나 개인정보를 다루는 서비스에서는 데이터를 외부 API로 보내지 않는 온디바이스·온프레미스 추론이 꾸준한 관심사예요. 어떤 작업까지가 고성능 서버 없이 가능한지 가늠해 보는 데 이런 프로젝트가 좋은 기준점이 돼요. 키오스크, 공장 설비, 차량용 단말처럼 사양이 낮고 교체 주기가 긴 임베디드 기기를 다루는 분들에게도 마찬가지고요.
주의할 점은 한국어예요. 소형 모델은 학습 데이터에서 한국어 비중이 작아 영어보다 품질이 눈에 띄게 떨어지는 경우가 많아요. 네이버의 HyperCLOVA X SEED, LG의 EXAONE, 카카오의 Kanana처럼 국내 기업이 공개한 소형 모델도 함께 비교해 보되, 라이선스 조건이 모델마다 다르니 상업적으로 쓰기 전에 꼭 확인하세요.
공부 목적이라면 더할 나위 없어요. 안 쓰는 폰이나 라즈베리 파이에 양자화된 모델을 올려보면, 토큰이 한 조각씩 느릿느릿 나오는 걸 보면서 '추론 비용'이라는 말이 숫자가 아니라 감각으로 이해되거든요.
마무리
한 줄로 정리하면, LLM을 작은 기기에 올리는 일은 결국 메모리와의 싸움이고, 양자화·소형 모델·실행 최적화를 얼마나 잘 조합하느냐의 문제예요.
여러분은 서랍 속 구형 기기에 LLM을 올린다면 어떤 용도로 써보고 싶으신가요? 그리고 온디바이스 소형 모델이 클라우드 API를 실제로 대체할 수 있는 업무는 어디까지라고 보시나요?
🔗 출처: Hacker News