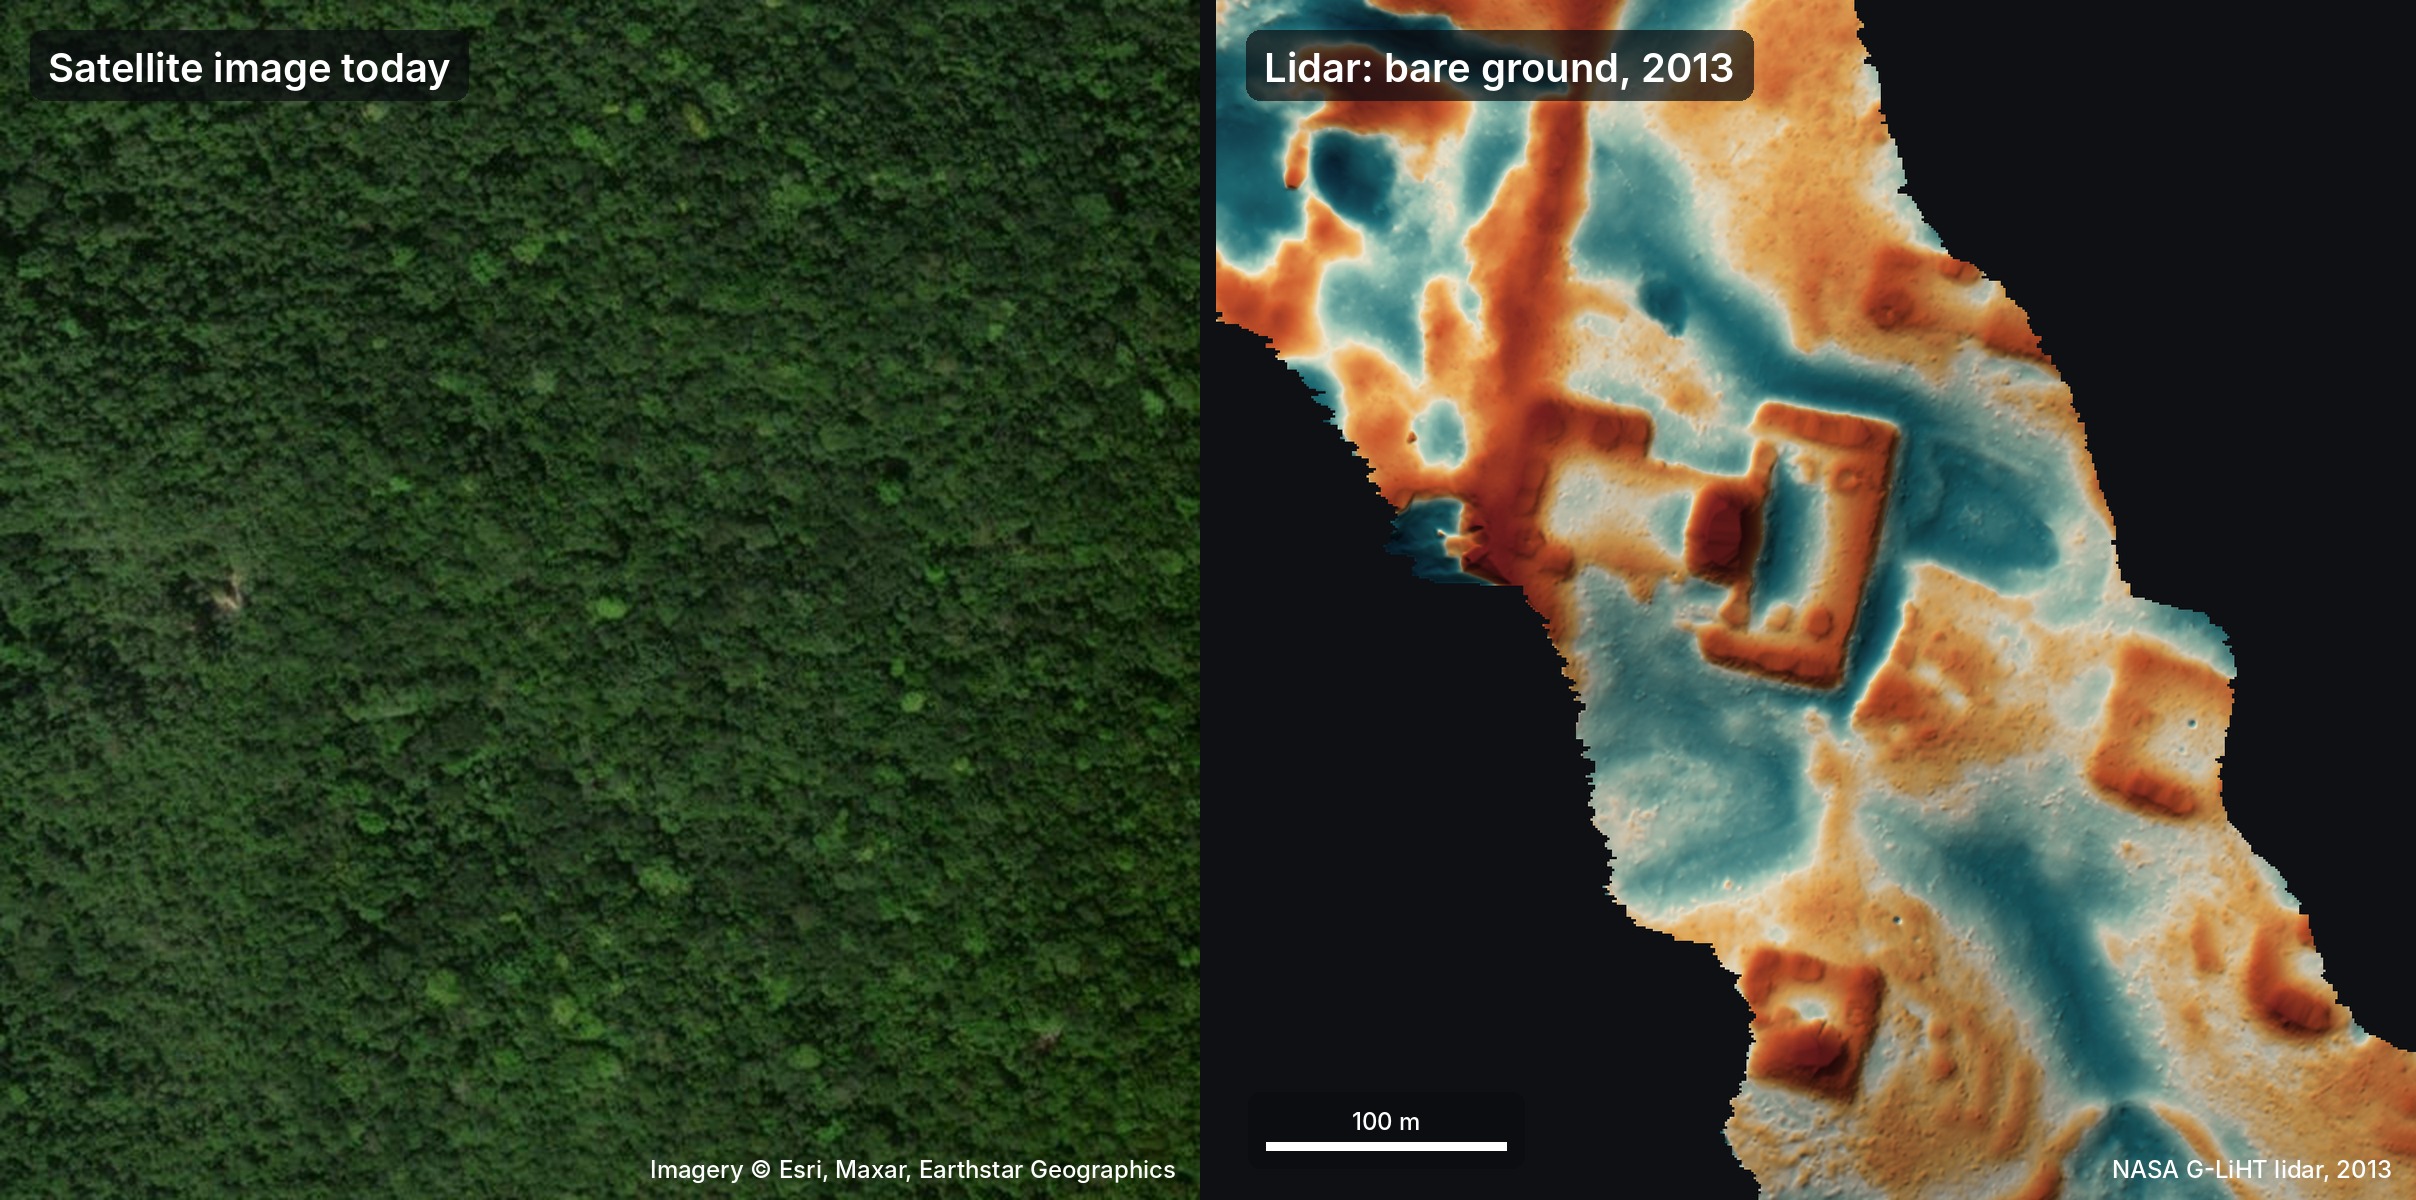
구글에서 일하는 한 소프트웨어 엔지니어가 흥미로운 작업 기록을 공개했어요. NASA가 공개한 라이다(LiDAR) 데이터에 AI 에이전트 48개를 붙여 돌렸고, 72시간 만에 기존 지도에 없던 마야 피라미드로 보이는 구조물을 찾아냈다는 내용이에요. 정글을 헤치고 들어간 탐사대가 아니라, 공개 데이터와 에이전트를 다루는 개발자 한 명이 해낸 일이라는 점에서 눈여겨볼 만해요.
라이다가 뭐길래 정글 속 유적을 찾나요
이게 뭐냐면, 비행기에서 레이저를 아주 촘촘하게 쏘고 반사되어 돌아오는 시간을 재서 거리를 구하는 측량 기술이에요. 정글 위에서 쏘면 대부분은 나뭇잎에 맞고 돌아오지만, 일부는 잎 사이 틈을 지나 땅바닥까지 닿거든요. 이렇게 모인 수억 개의 점(포인트 클라우드)에서 땅에 닿은 점만 골라내면, 숲을 통째로 걷어낸 것 같은 맨땅 지형도가 만들어져요. 두꺼운 이불을 덮고 누운 사람의 윤곽을, 이불만 투명하게 만들어서 보는 것과 비슷해요.
마야 유적은 이 방식과 궁합이 좋아요. 피라미드나 광장, 둑길은 수백 년 동안 흙과 나무에 덮여 겉보기엔 그냥 언덕이지만, 맨땅 지형도에서는 자연에서 잘 나오지 않는 직각 모서리와 대칭 구조가 그대로 드러나거든요.
데이터는 이미 공개돼 있었어요
재미있는 건 이런 데이터가 원래 고고학용이 아니라는 점이에요. NASA 같은 기관은 숲이 탄소를 얼마나 저장하는지 연구하려고 중남미 숲을 라이다로 촬영해 왔고, 결과물을 누구나 내려받을 수 있게 열어 뒀어요. 예를 들어 NASA 고다드 연구소의 G-LiHT는 숲 생태 연구용 항공 라이다인데, 고고학자들이 이 데이터를 다시 분석해 마야 정착지 흔적을 찾아낸 연구가 이미 여러 편 나와 있어요. 이번 작업이 정확히 어떤 데이터셋을 썼는지는 원문에서 확인하실 수 있어요.
에이전트 48개는 무슨 일을 했을까요
에이전트를 어떻게 구성했는지는 작성자의 글에 정리돼 있으니 직접 읽어보시길 권해요. 여기서는 이 문제가 왜 에이전트를 여러 개 돌리기 좋은 구조인지만 짚어볼게요.
라이다 분석은 보통 이런 순서로 흘러가요. 원시 포인트 클라우드를 내려받고, 땅에 닿은 점을 분류하고, 그걸로 수치표고모델(DEM, 격자 칸마다 높이 값을 적어 둔 지형 데이터)을 만들어요. 그다음 음영기복도처럼 굴곡이 눈에 잘 보이는 그림으로 바꾸고, 인공 구조물처럼 보이는 후보를 표시하죠. 마지막으로 그 후보가 이미 알려진 유적인지 기존 목록과 논문을 대조해요.
중요한 성질은 지역을 타일로 쪼개면 타일끼리 서로 독립적이라는 거예요. A 구역을 보는 일이 B 구역 결과를 기다릴 필요가 없으니, 에이전트 수십 개가 동시에 서로 다른 구역을 훑을 수 있어요. 사람 한 명이 몇 달 동안 화면을 넘겨가며 볼 분량을 병렬로 밀어붙이는 셈이에요. 개인적으로는 72시간이라는 숫자가 모델이 특별히 똑똑해서라기보다 이 병렬성 덕분이라고 봐요.
'발견'이라는 말은 조심해서 읽어야 해요
라이다에서 피라미드처럼 보인다고 해서 피라미드로 확정되는 건 아니에요. 자연 언덕이나 현대에 만든 구조물, 데이터 처리 과정에서 생긴 잡음일 수도 있거든요. 고고학에서는 현장에 직접 가서 확인하는 절차를 거쳐야 비로소 유적으로 인정해요.
'지도에 없다'는 표현도 마찬가지예요. 공개된 목록에 없다는 뜻이지, 현지 주민이나 지역 연구자가 모른다는 뜻은 아닐 수 있어요. 또 정확한 좌표를 공개하면 도굴 위험이 생겨서, 학계는 위치 공개에 꽤 신중한 편이에요. 무엇보다 AI 에이전트는 그럴듯한 후보를 자신 있게 보고하는 경향이 있어서, 결과를 걸러내는 검증 단계가 탐색 단계만큼 중요해요.
업계 흐름에서 보면
2018년 과테말라 북부에서 진행된 PACUNAM 라이다 조사는 약 2,100㎢를 촬영해 6만 개가 넘는 구조물을 찾아냈어요. 여러 기관이 참여한 큰 프로젝트였죠. 2024년에는 미국의 한 박사과정생이 산림 모니터링용으로 찍어 둔 공개 라이다 데이터를 인터넷에서 찾아 분석했고, 멕시코 캄페체에서 '발레리아나'라는 마야 도시를 보고했어요. 그리고 이번에는 엔지니어 한 명과 에이전트 수십 개예요.
흐름이 보이시죠. 병목이 '데이터를 찍을 예산'에서 '데이터를 들여다볼 사람 손'으로, 이제는 '후보를 검증할 전문가'로 옮겨 가고 있어요. 기존에는 유적 탐지 전용 딥러닝 모델을 따로 학습시키는 접근이 많았는데, 그러려면 정답이 표시된 학습 데이터가 필요해요. 범용 에이전트는 학습 데이터 없이 바로 시작할 수 있는 대신 판단의 일관성이 떨어질 수 있어서, 두 방식은 경쟁보다 보완 관계에 가까워요.
한국 개발자에게 주는 시사점
유적 탐사가 본업인 분은 드물겠지만, 이 패턴은 그대로 가져다 쓸 수 있어요. 공개 데이터, 잘게 쪼갤 수 있는 탐색 문제, 병렬 에이전트, 그리고 검증 단계. 위성 영상에서 변화 찾기, 대량 로그에서 이상 징후 찾기, 논문 수천 편 선별하기가 다 같은 구조예요.
국내에도 재료는 있어요. 국토지리정보원이 수치표고모델 같은 공간정보를 공개하고 있고, 숲에 가려진 산성이나 고분 지형을 파악하는 데 항공 라이다를 활용한 조사 사례도 있거든요. PDAL이나 QGIS 같은 오픈소스 도구만으로도 포인트 클라우드를 지형도로 바꾸는 과정까지는 주말에 따라 해볼 수 있어요.
다만 비용은 미리 계산해 보세요. 에이전트 수십 개를 며칠씩 돌리면 토큰 요금이 만만치 않아요. 작은 구역 몇 개로 먼저 시험해서 한 구역당 비용과 오탐 비율을 재본 다음에 규모를 키우는 게 안전해요.
마무리
한 줄로 정리하면, 탐색은 에이전트가 값싸게 대신해 주는 시대가 됐고, 사람의 몫은 무엇이 진짜인지 가려내는 검증으로 옮겨 가고 있어요.
여러분이 다루는 데이터 중에도 '누가 다 들여다볼 시간만 있으면 뭔가 나올 텐데' 싶은 게 있나요? 에이전트 수십 개를 붙인다면 어떤 문제에 가장 먼저 써보고 싶으신가요?
🔗 출처: Hacker News