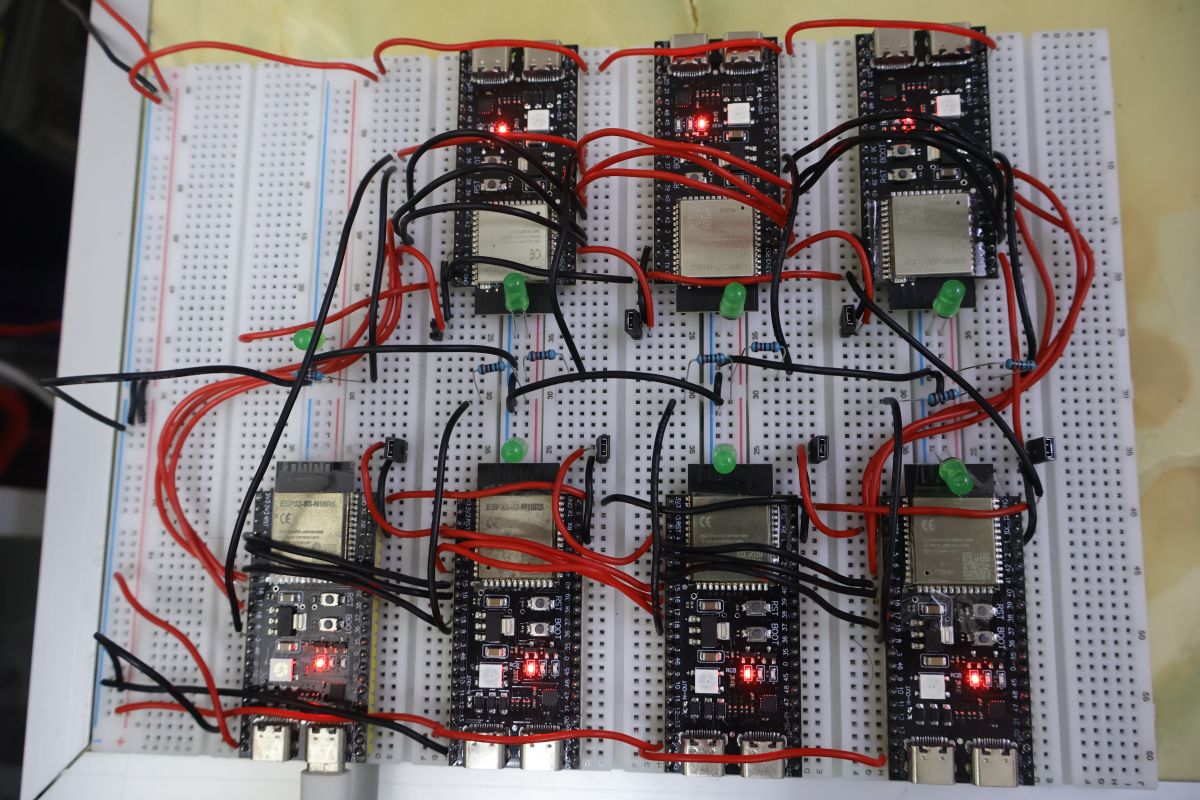
몇천 원짜리 칩 위에서 LLM이 돈다고요?
LLM 하면 보통 수백만 원짜리 GPU나 클라우드 API가 먼저 떠오르잖아요. 그런데 이번에 공개된 오픈소스 프로젝트는 방향이 완전히 반대예요. IoT 기기에 흔히 들어가는 ESP32-S3 마이크로컨트롤러 여러 개를 묶어서 언어 모델을 돌리거든요. 게다가 모델은 가중치 하나를 1.58비트로 표현하는 BitNet 계열이에요.
처음 들으면 장난 같은데, 사실 요즘 엣지 AI 쪽에서 제일 뜨거운 두 가지가 딱 만난 프로젝트예요. 하나는 극단적인 양자화, 다른 하나는 작은 장치 여러 개로 분산 추론하기예요. 둘 다 앞으로 계속 듣게 될 주제라서 한번 차근차근 풀어볼게요.
ESP32-S3가 어떤 칩이냐면
ESP32-S3는 Espressif에서 만든 와이파이/블루투스 내장 마이크로컨트롤러예요. 스마트 플러그나 센서 보드 같은 데 많이 들어가고, 개발 보드도 만 원 안팎이면 사요. 사양은 240MHz 듀얼코어 CPU에 내장 SRAM은 512KB 정도고, 보드에 따라 외부 PSRAM을 몇 MB 붙일 수 있어요. 노트북 RAM이 16GB라고 치면 수천 분의 일 수준이죠.
재밌는 건 S3에 간단한 벡터 연산 명령어가 들어 있다는 거예요. 원래는 음성 인식이나 이미지 분류 같은 작은 AI 작업을 위해 넣은 건데, 이런 실험에서 꽤 쓸모가 있어요.
1.58비트 BitNet이 뭐냐면
일반적인 모델은 가중치 하나를 16비트나 32비트 실수로 저장해요. 흔히 쓰는 양자화는 이걸 8비트나 4비트로 줄이는 거고요. BitNet b1.58은 더 나가서 가중치를 -1, 0, +1 세 가지 값만 쓰게 해요. 값이 세 개니까 정보량이 log2(3), 약 1.58비트라서 이런 이름이 붙었어요.
이게 왜 대단하냐면 곱셈이 사라지거든요. 행렬 곱셈은 원래 입력값에 가중치를 곱해서 더하는 연산의 반복이에요. 그런데 가중치가 +1이면 그냥 더하고, -1이면 빼고, 0이면 건너뛰면 끝이에요. 곱셈기가 약한 작은 칩에서 이 차이는 엄청 커요. 메모리도 16비트 대비 10분의 1 수준으로 줄어들고요.
중요한 포인트 하나는, BitNet은 이미 학습된 모델을 나중에 깎아내는 방식이 아니라 처음부터 3값 가중치로 학습하는 방식이라는 거예요. 그래서 같은 비트 수로 억지로 양자화한 모델보다 품질 손실이 훨씬 적어요. 마이크로소프트가 공개한 bitnet.cpp 같은 추론 엔진도 이 특성을 활용해서 CPU만으로 꽤 빠른 속도를 내요.
여러 칩으로 나눠 돌리는 방식
아무리 1.58비트라도 칩 하나 메모리로는 금방 한계가 와요. 그래서 이 프로젝트는 모델을 여러 ESP32-S3에 나눠 싣는 클러스터 구조를 택했어요. 분산 추론은 보통 두 가지 방식이 있는데요.
- 파이프라인 병렬: 레이어 1~4는 A 칩, 5~8은 B 칩, 이런 식으로 층을 나눠서 결과를 다음 칩에 넘기는 방식이에요. 공장 컨베이어 벨트를 떠올리면 돼요.
- 텐서 병렬: 한 레이어의 큰 행렬을 쪼개서 여러 칩이 동시에 계산하고 결과를 합치는 방식이에요. 계산은 빨라지지만 칩끼리 주고받는 데이터가 많아져요.
솔직히 말하면 여기서 돌아가는 모델은 수십억 파라미터짜리 챗봇이 아니에요. 아주 작은 모델이고 속도도 실용적이라기보다는 가능성을 보여주는 수준이에요. 그래도 GPU도 운영체제도 없는 칩에서 트랜스포머가 돈다는 사실 자체가 의미가 있어요.
업계 흐름에서 보면
비슷한 시도는 꽤 있었어요. 카파시의 llama2.c를 마이크로컨트롤러로 포팅한 프로젝트들, 라즈베리파이 여러 대로 대형 모델을 나눠 돌리는 distributed-llama, 맥북 여러 대를 묶는 exo 같은 것들이요. 이번 프로젝트는 그 흐름을 가장 작은 하드웨어 쪽 끝까지 밀어붙인 사례라고 볼 수 있어요. 여기에 BitNet 같은 초저비트 모델이 합쳐지면서 불가능해 보이던 조합이 현실이 된 거죠.
한국 개발자에게 주는 시사점
임베디드나 IoT 쪽 일을 하신다면 눈여겨볼 만해요. 당장 이걸 제품에 넣기는 어렵지만, 네트워크 없이 기기 안에서 간단한 자연어 처리를 하는 시대가 생각보다 빨리 올 수 있다는 신호거든요. 스마트홈 기기가 짧은 명령어를 로컬에서 이해한다든지, 공장 센서가 이상 로그를 요약한다든지 하는 식으로요.
백엔드나 웹 개발자라도 공부할 가치는 충분해요. 양자화, 파이프라인 병렬, 통신 병목 같은 개념은 GPU 클러스터에서도 똑같이 나오거든요. 오히려 자원이 극단적으로 적은 환경에서 보면 원리가 더 선명하게 보여요. ESP32-S3 보드 두세 개면 주말 프로젝트로 직접 재현해 볼 수도 있어요.
마무리
한 줄 정리: 1.58비트 모델은 곱셈을 덧셈으로 바꿔주고, 그 덕분에 몇천 원짜리 칩 여러 개로도 언어 모델을 돌릴 수 있게 됐어요.
여러분은 초소형 기기에서 도는 언어 모델이 실제로 쓸모 있어질 곳이 어디라고 보시나요? 그리고 BitNet 같은 초저비트 모델이 언젠가 일반 서버 추론의 표준이 될 수 있을까요?
🔗 출처: Hacker News