요즘 AI 커뮤니티에서는 텍스트를 생성하지 않는 새로운 형태의 모델이 화제다. 자기회귀(autoregressive) 방식으로 토큰을 하나씩 뱉는 대신, 정형화된 스키마 위에서 확률값을 한 번의 순전파로 즉시 내놓는 구조다. 흥미로운 점은 이 개념을 대형 연구소보다 앞서 개인 개발자가 먼저 구현하고 공개했다고 주장한다는 것이다. 이 글에서 다루는 Laya 프로젝트가 그 사례로, 개발자 본인의 서술을 토대로 기술의 실체와 실무적 함의, 그리고 걸러 읽어야 할 지점을 짚는다.
1년 앞선 개발과 뒤늦은 화제
개발자의 설명에 따르면 그는 2025년 3월에 이미 이 방향의 모델을 만들어 arXiv 논문(arXiv:2503.23303)과 허깅페이스 가중치(sales-conversion-model-reinf-learning), 공개 데이터셋(saas-sales-conversations), PyPI 패키지, 그리고 r/LocalLLaMA 토론까지 공개했다. 초기 모델은 PPO(근접 정책 최적화)를 시퀀스 표현 위에 적용해, 세로형 영업 대화에서 턴마다 전환 확률(0.0~1.0)의 궤적을 출력하는 방식이었다. 이후 2025년 9월에는 강화학습으로 스키마 기반 결정을 유도하는 프레임워크를 정식화한 두 번째 논문(arXiv:2510.01237)을 냈다.
그런데 2026년 9월, OpenAI에서 ChatGPT 공동 개발에 참여했던 Diogo Almeida가 창업한 TypeSafe AI가 동일한 비자기회귀 결정 개념을 'Jev'라는 이름으로 출시했다. 개발자는 Jev가 마치 완전히 새로운 과학적 돌파구인 것처럼 발표되었지만 기술 논문도, 공개 가중치도, 공개 학습 데이터셋도 없었다고 지적한다. Jev는 RLCD(Reinforcement Learning for Calibrated Decisions)라 부르는 병렬 샘플링으로 신뢰도 분포와 스키마 선택을 가로 방향으로 출력하며, 입력 100만 토큰당 0.042달러, 응답 시간은 약 150ms 수준이라고 한다. 이 대목이 프로젝트의 감정적 출발점이자, 경쟁 구도를 전제로 서술이 흐른다는 점을 염두에 둘 필요가 있다.
생성형 LLM이 반사적 판단에 과한 이유
Laya가 겨냥하는 문제는 분명하다. 고객 지원 티켓 분류, 이메일 라우팅, 프롬프트 사전 검사처럼 단순하고 정형화된 질문에까지 8B·70B급이나 프런티어 생성형 LLM을 호출하는 것은 과잉이라는 것이다. 이 경우 토큰이 스트리밍되기까지 500~2,000ms를 기다리고, 추론 비용을 지불하며, 자유 형식 텍스트에서 깔끔한 라벨을 뽑기 위해 정규식이나 JSON 파서를 붙여야 한다. 무엇보다 LLM이 'confidence: 0.95'라고 출력해도 그것은 자신 있어 보이는 토큰을 예측한 결과일 뿐, 수학적으로 보정(calibration)된 값이 아니다.
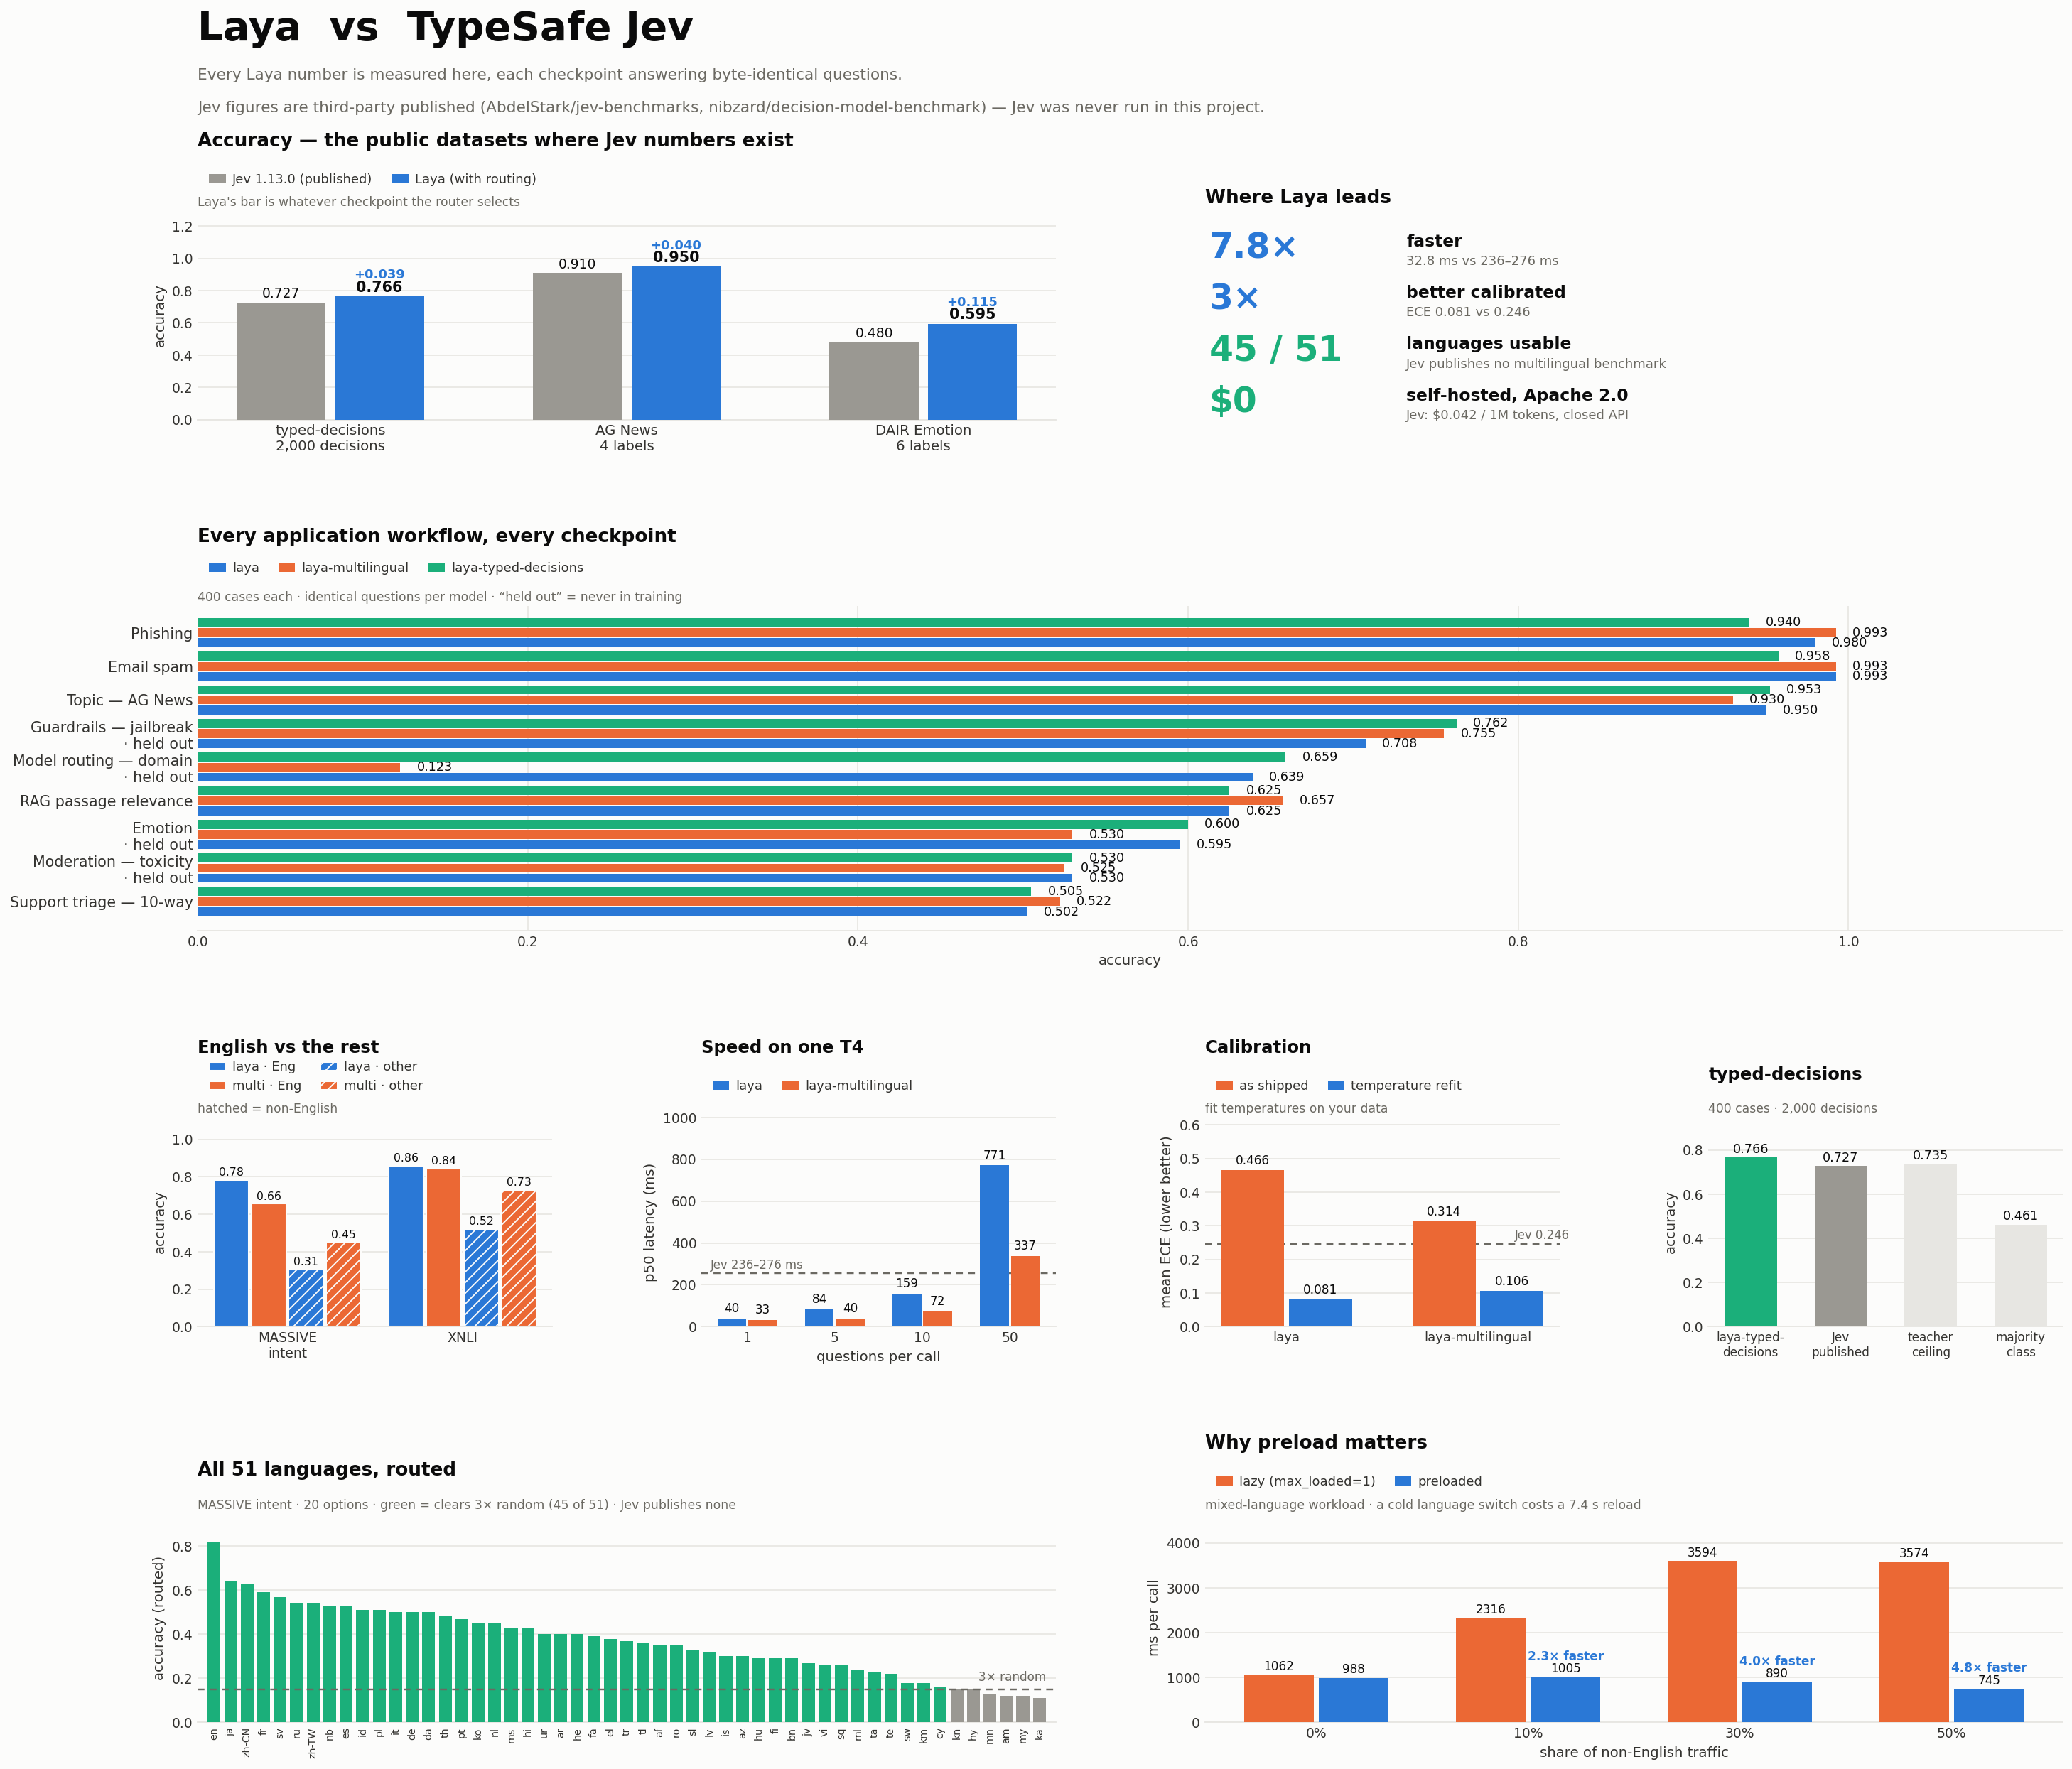
Laya는 인간 두뇌의 'System 1', 즉 즉각적 반사 판단에 해당하는 역할을 노린다. 양방향 인코더 위에 세 가지 기본 결정 유형(choice, score, noul)을 얹어, 원문 텍스트·이메일·티켓·JSON 문서 같은 임의의 상태를 한 번의 순전파로 평가한다. 출력 공간이 확률과 숫자로만 구성되기 때문에 모델은 텍스트를 생성하지 않고, 원리상 환각이나 스키마 위반, 깨진 JSON이 발생할 수 없다. 개발자는 이 구조 덕분에 단일 GPU에서 32.8ms(배치 처리 시 질문당 7.2ms)로 동작해 Jev보다 6~8배 빠르며, 100개 이상 언어를 지원하고, 구독 비용 없이 Apache 2.0으로 가중치를 전면 공개했다고 밝힌다.
다국어의 함정과 내장 라우터
가장 실무적으로 눈여겨볼 발견은 다국어 처리에서 나온다. MASSIVE 벤치마크의 51개 언어 스윕(선택지 20개, 무작위 기준 0.050)에서, ModernBERT-large의 5만 토큰짜리 영어 BPE 어휘는 비라틴 문자를 제대로 처리하지 못했다. 문제는 정확도가 82%든 0%든 영어 체크포인트의 평균 신뢰도가 0.885 아래로 내려가지 않았다는 점이다. 즉 모델이 입력 문자를 읽지 못할 때조차 신뢰도는 경고를 주지 않았고, 따라서 신뢰도 게이팅만으로는 안전을 보장할 수 없다. 어떤 모델을 쓸지는 순전파 이전에 결정되어야 한다.
그래서 Laya에는 데바나가리, 한중일 한자, 키릴, 아랍, 히브리, 타밀, 태국 문자 등 22개 문자 체계의 유니코드 스크립트와 라틴 불용어 분포를 검사하는 라우터가 들어 있다. 라우팅 오버헤드는 33ms 순전파 대비 2% 미만이며, Router(preload=True)로 필요한 모델을 VRAM·RAM에 상주시키면 언어가 번갈아 들어올 때 발생하는 7~10초의 콜드 스왑 지연을 없앨 수 있다. 세 개의 특화 체크포인트는 convaiinnovations/laya 저장소로 통합돼, 허깅페이스의 allow_patterns로 필요한 하위 폴더만 내려받도록 했다.
실무자가 걸러 읽을 지점
분류, 가드레일, 라우팅, 트리아지처럼 대량으로 반복되는 판단 작업이라면 35ms 미만의 양방향 결정 모델은 분명 매력적이다. 환각이 구조적으로 불가능하고, 신뢰도를 코드 분기에 실제로 쓸 수 있으며, API 종속 없이 자체 인프라에 올릴 수 있다는 점은 비용과 지연에 민감한 파이프라인에 실질적 이득이다. 다만 벤치마크 해석에는 주의가 필요하다. 개발자 스스로 밝혔듯 Laya 수치는 자체 측정값이고 Jev 수치는 제3자 연구(AbdelStark, nibzard)와 TypeSafe AI가 공개한 값을 끌어온 것이어서, 동일 조건의 직접 비교로 보기는 어렵다.
또한 전체 서술이 선행성 주장과 경쟁 구도를 중심으로 짜여 있다는 점, 'noul'을 비롯한 일부 기본 유형과 9개 기업 워크플로 평가의 구체적 내용이 이 자료만으로는 충분히 드러나지 않는다는 점도 감안해야 한다. 결국 검증의 열쇠는 공개된 가중치와 논문, 데이터셋을 직접 자사 데이터로 돌려보는 데 있다. 오픈소스로 전부 열려 있다는 것 자체가 이 주장을 재현 가능한 형태로 확인할 통로를 제공한다는 점에서, 도입을 고민하는 팀이라면 마케팅 문구가 아니라 자체 재현 결과로 판단하는 편이 안전하다.