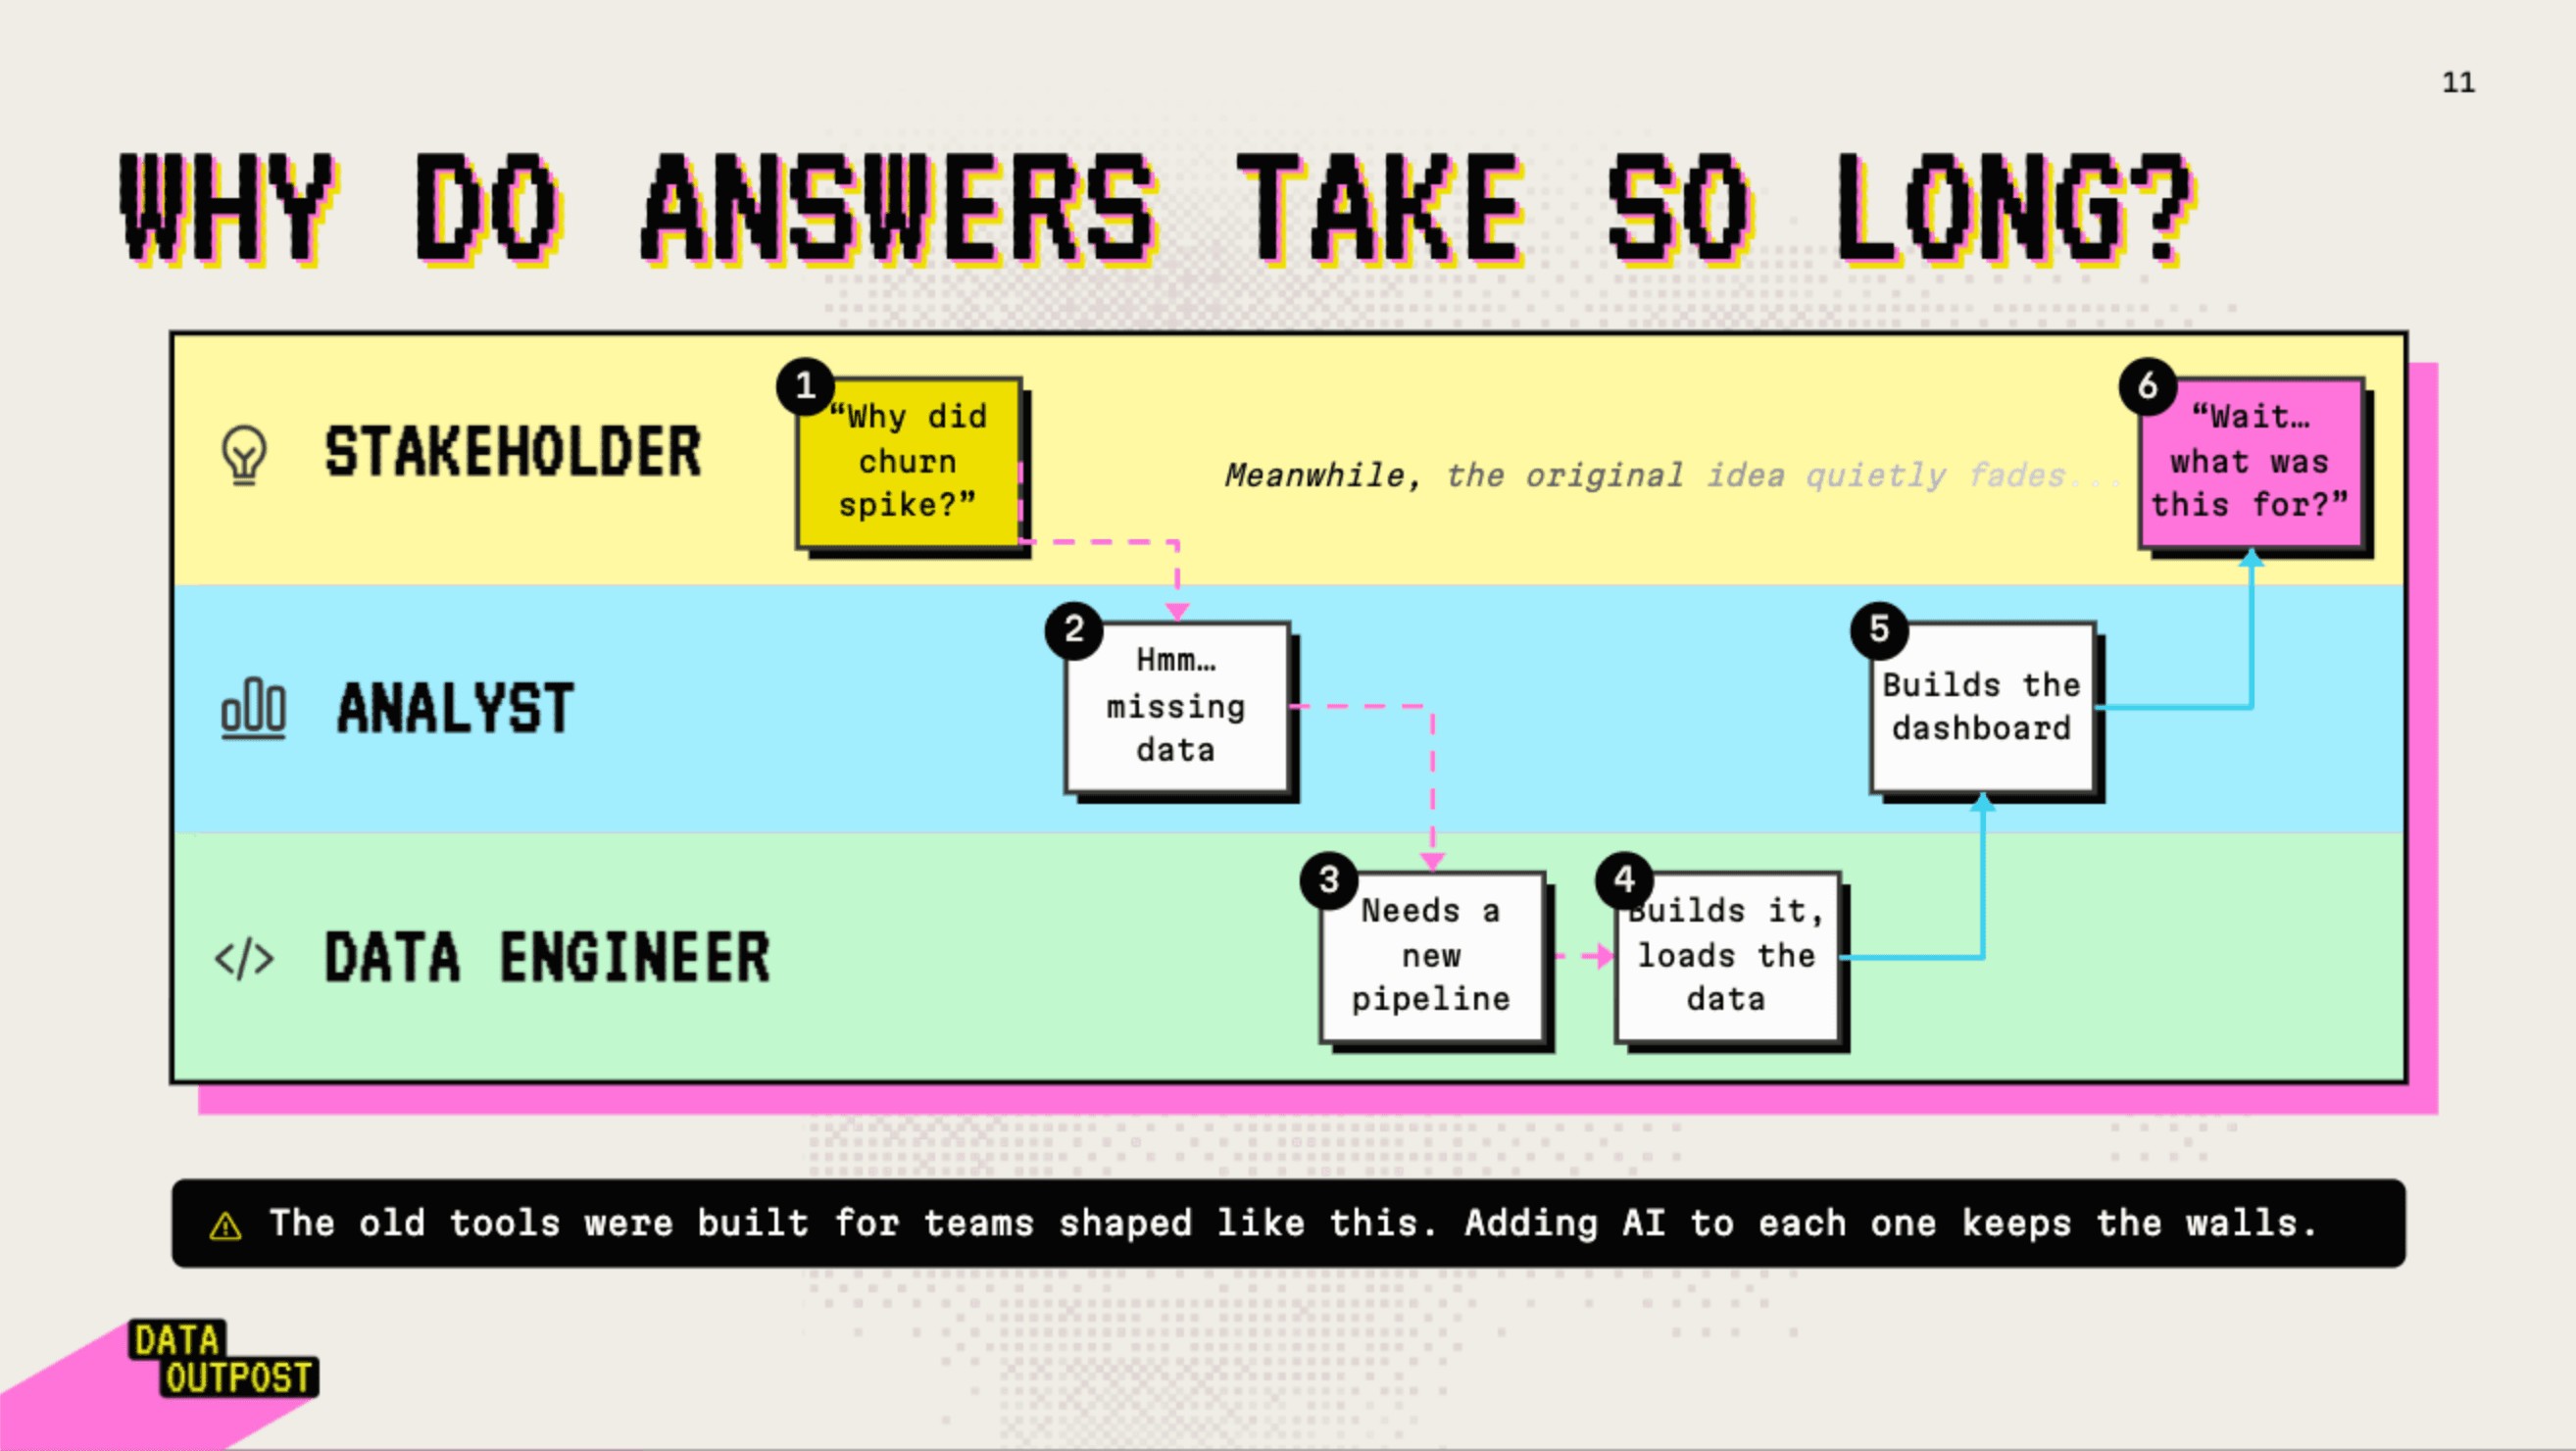
무슨 이야기인가요
DuckDB 기반 클라우드 데이터 웨어하우스를 만드는 MotherDuck이 자사 블로그에 '데이터 인텔리전스 엔지니어의 여명(The Dawn of the Data Intelligence Engineer)'이라는 글을 올렸어요. 제목 그대로 데이터 직군에 새로운 역할이 떠오르고 있다는 이야기예요. 미리 말씀드리면 이 글은 원문을 옮긴 요약이 아니라, 제목이 던진 화두가 왜 지금 나오는지를 배경지식으로 풀어 쓴 해설이에요. MotherDuck이 이 역할을 정확히 어떻게 정의하는지는 원문에서 직접 확인해 주세요.
'또 새 직함이야?' 싶으실 거예요. 그런데 데이터 직무는 도구가 바뀔 때마다 이름이 바뀌어 온 역사가 있어요. 그 흐름을 알면 이번 이야기도 훨씬 잘 읽혀요.
직함은 병목을 따라 움직여요
하둡과 스파크가 뜨던 시절에는 '데이터 엔지니어'가 주인공이었어요. 여기저기 흩어진 데이터를 모아 옮기는 파이프라인을 만드는 일 자체가 어려웠거든요. 그러다 BigQuery, Snowflake 같은 클라우드 웨어하우스가 싸고 빨라지면서 '일단 원본을 다 넣어 두고 그 안에서 SQL로 가공하자'는 방식이 퍼졌어요.
이때 dbt라는 도구와 함께 '애널리틱스 엔지니어'라는 이름이 등장했어요. 이게 뭐냐면, 분석용 SQL을 그냥 짜는 게 아니라 코드처럼 버전 관리하고 테스트하고 문서화하는 사람이에요. 분석가와 엔지니어 사이에 생긴 빈자리를 채운 역할이죠.
패턴이 보이시나요? 도구가 한 병목을 없애면 병목은 다른 곳으로 옮겨 가고, 그 새 병목을 맡는 사람에게 새 이름이 붙어요.
지금 옮겨 가는 병목: SQL 작성에서 '맥락'으로
요즘 LLM은 SQL을 꽤 잘 써요. 문제는 문법이 아니라 의미예요. '지난달 매출 알려줘'라는 질문에 답하려면 환불은 빼는지, 부가세는 포함인지, 테스트 계정은 제외하는지, orders와 orders_v2 중 어느 테이블이 진짜인지 알아야 하거든요. 이런 건 사람도 입사하고 몇 달은 지나야 아는 정보예요.
그래서 필요한 게 몇 가지 있어요. 먼저 시맨틱 레이어예요. 이게 뭐냐면 '매출이란 이 테이블의 이 컬럼을 이런 조건으로 더한 값'이라는 정의를 한곳에 코드로 적어 둔 사전이에요. 다음은 MCP예요. AI 에이전트가 데이터베이스 같은 외부 도구에 접속하는 표준 규격인데, MotherDuck도 자사 서비스용 MCP 서버를 내놓았어요. 마지막으로 평가 세트예요. 정답을 아는 질문을 모아 두고 에이전트가 낸 숫자가 맞는지 계속 확인하는 테스트죠.
여기에 권한과 비용 문제가 따라와요. 에이전트는 사람보다 훨씬 많은 쿼리를 훨씬 빠르게 던지거든요. 읽기 전용 권한, 쿼리 타임아웃, 비용 상한 같은 가드레일이 없으면 사고가 나요. 이렇게 AI가 데이터를 제대로 읽고 답하도록 맥락과 검증과 가드레일을 설계하는 일, 이 흐름에서 보면 '데이터 인텔리전스 엔지니어'라는 이름이 가리키는 곳이 짐작이 가요.
MotherDuck이 이 말을 하는 이유
DuckDB를 모르는 분을 위해 설명하면, 서버를 띄울 필요 없이 프로그램 안에서 바로 도는 분석용 데이터베이스예요. '분석계의 SQLite'라고 많이 불러요. 노트북 한 대로 수억 행짜리 Parquet 파일을 집계할 수 있어요. MotherDuck은 이걸 클라우드로 확장한 회사고, 공동 창업자이자 CEO인 조던 티가니는 2023년 'Big Data is Dead'라는 글에서 대부분 회사의 데이터는 생각보다 작다고 주장해서 널리 알려졌어요.
에이전트가 작은 쿼리를 수없이 던지는 방식은 가볍고 빠른 엔진과 잘 맞아요. 그러니 이 글에는 회사의 포지셔닝도 섞여 있다고 보는 게 공정해요. 벤더가 새 직함을 이야기할 때는 그 직함의 사람이 자기 제품을 쓰길 바라는 마음이 있기 마련이니까요.
업계 맥락: 모두 같은 방향을 보고 있어요
Databricks는 2023년 말부터 '데이터 인텔리전스 플랫폼'이라는 표현을 쓰면서 자연어로 데이터에 질문하는 기능을 밀고 있어요. Snowflake는 시맨틱 모델을 바탕으로 SQL을 생성하는 Cortex Analyst를 내놓았고, dbt Labs도 시맨틱 레이어와 MCP 서버를 제공해요. 방향은 같아요. 데이터 위에 '의미' 계층을 얹고 그 위에 AI 인터페이스를 올리는 거죠. 차이는 무게예요. Databricks와 Snowflake는 한 플랫폼에 다 넣는 쪽이고, DuckDB 진영은 가벼운 부품을 조립하는 쪽이에요.
회의적으로 볼 이유도 있어요. '프롬프트 엔지니어'라는 직함이 얼마나 빨리 식었는지 기억하실 거예요. 직함은 유행을 타요. 하지만 이름이 사라져도 일은 남아요.
한국 개발자에게 주는 시사점
국내에서는 데이터 엔지니어와 분석가의 경계가 흐릿하고, 작은 팀에서는 백엔드 개발자가 겸하는 경우도 많아요. 직함을 기다릴 필요 없이 지금 해볼 수 있는 게 있어요. 핵심 지표 열 개의 정의를 코드나 문서로 고정하고, 테이블과 컬럼에 설명을 채우세요. AI가 읽는 건 결국 그 메타데이터예요. cust_no, ord_dt 같은 사내 약어 사전도 훌륭한 맥락이 돼요. 그다음 읽기 전용 계정으로 에이전트를 붙여 보고, 정답을 아는 질문 스무 개로 채점해 보세요.
DuckDB는 pip install duckdb 한 줄이면 설치되고 SELECT * FROM 'data.parquet'처럼 파일을 바로 조회할 수 있어서 연습용으로 좋아요. 그리고 주니어일수록 SQL 기본기는 놓지 마세요. AI가 쓴 쿼리가 틀렸다는 걸 알아보려면 조인과 집계를 읽을 줄 알아야 하니까요.
마무리
한 줄로 정리하면, SQL을 쓰는 일은 AI와 나눠 갖게 되지만 '무엇이 맞는 숫자인지' 정의하고 검증하는 일은 오히려 더 중요해져요. 여러분 팀에서는 AI에게 데이터 질문을 맡겨 보셨나요? 가장 먼저 막힌 곳은 SQL이었나요, 아니면 지표의 정의였나요?
🔗 출처: Hacker News