대답하는 모델 말고, 판단하는 모델
요즘 AI 에이전트를 만들다 보면 의외로 많은 곳에서 '짧은 판단'이 필요해요. 이 질문은 코딩 질문인가 일반 질문인가, 이 사용자 입력은 위험한가 아닌가, 방금 도구를 실행한 결과가 성공인가 실패인가, 에이전트가 할 일을 다 끝냈나 아직인가. 답은 대부분 예/아니오 아니면 몇 개 중 하나를 고르는 거예요. 그런데 이걸 위해 매번 GPT나 클로드 같은 큰 모델을 부르면 어떻게 될까요? 한 번 판단하는 데 수백 밀리초에서 몇 초가 걸리고, 비용도 쌓여요. 에이전트가 한 작업에 이런 판단을 수십 번 하면 전체 속도와 비용을 여기서 다 잡아먹거든요.
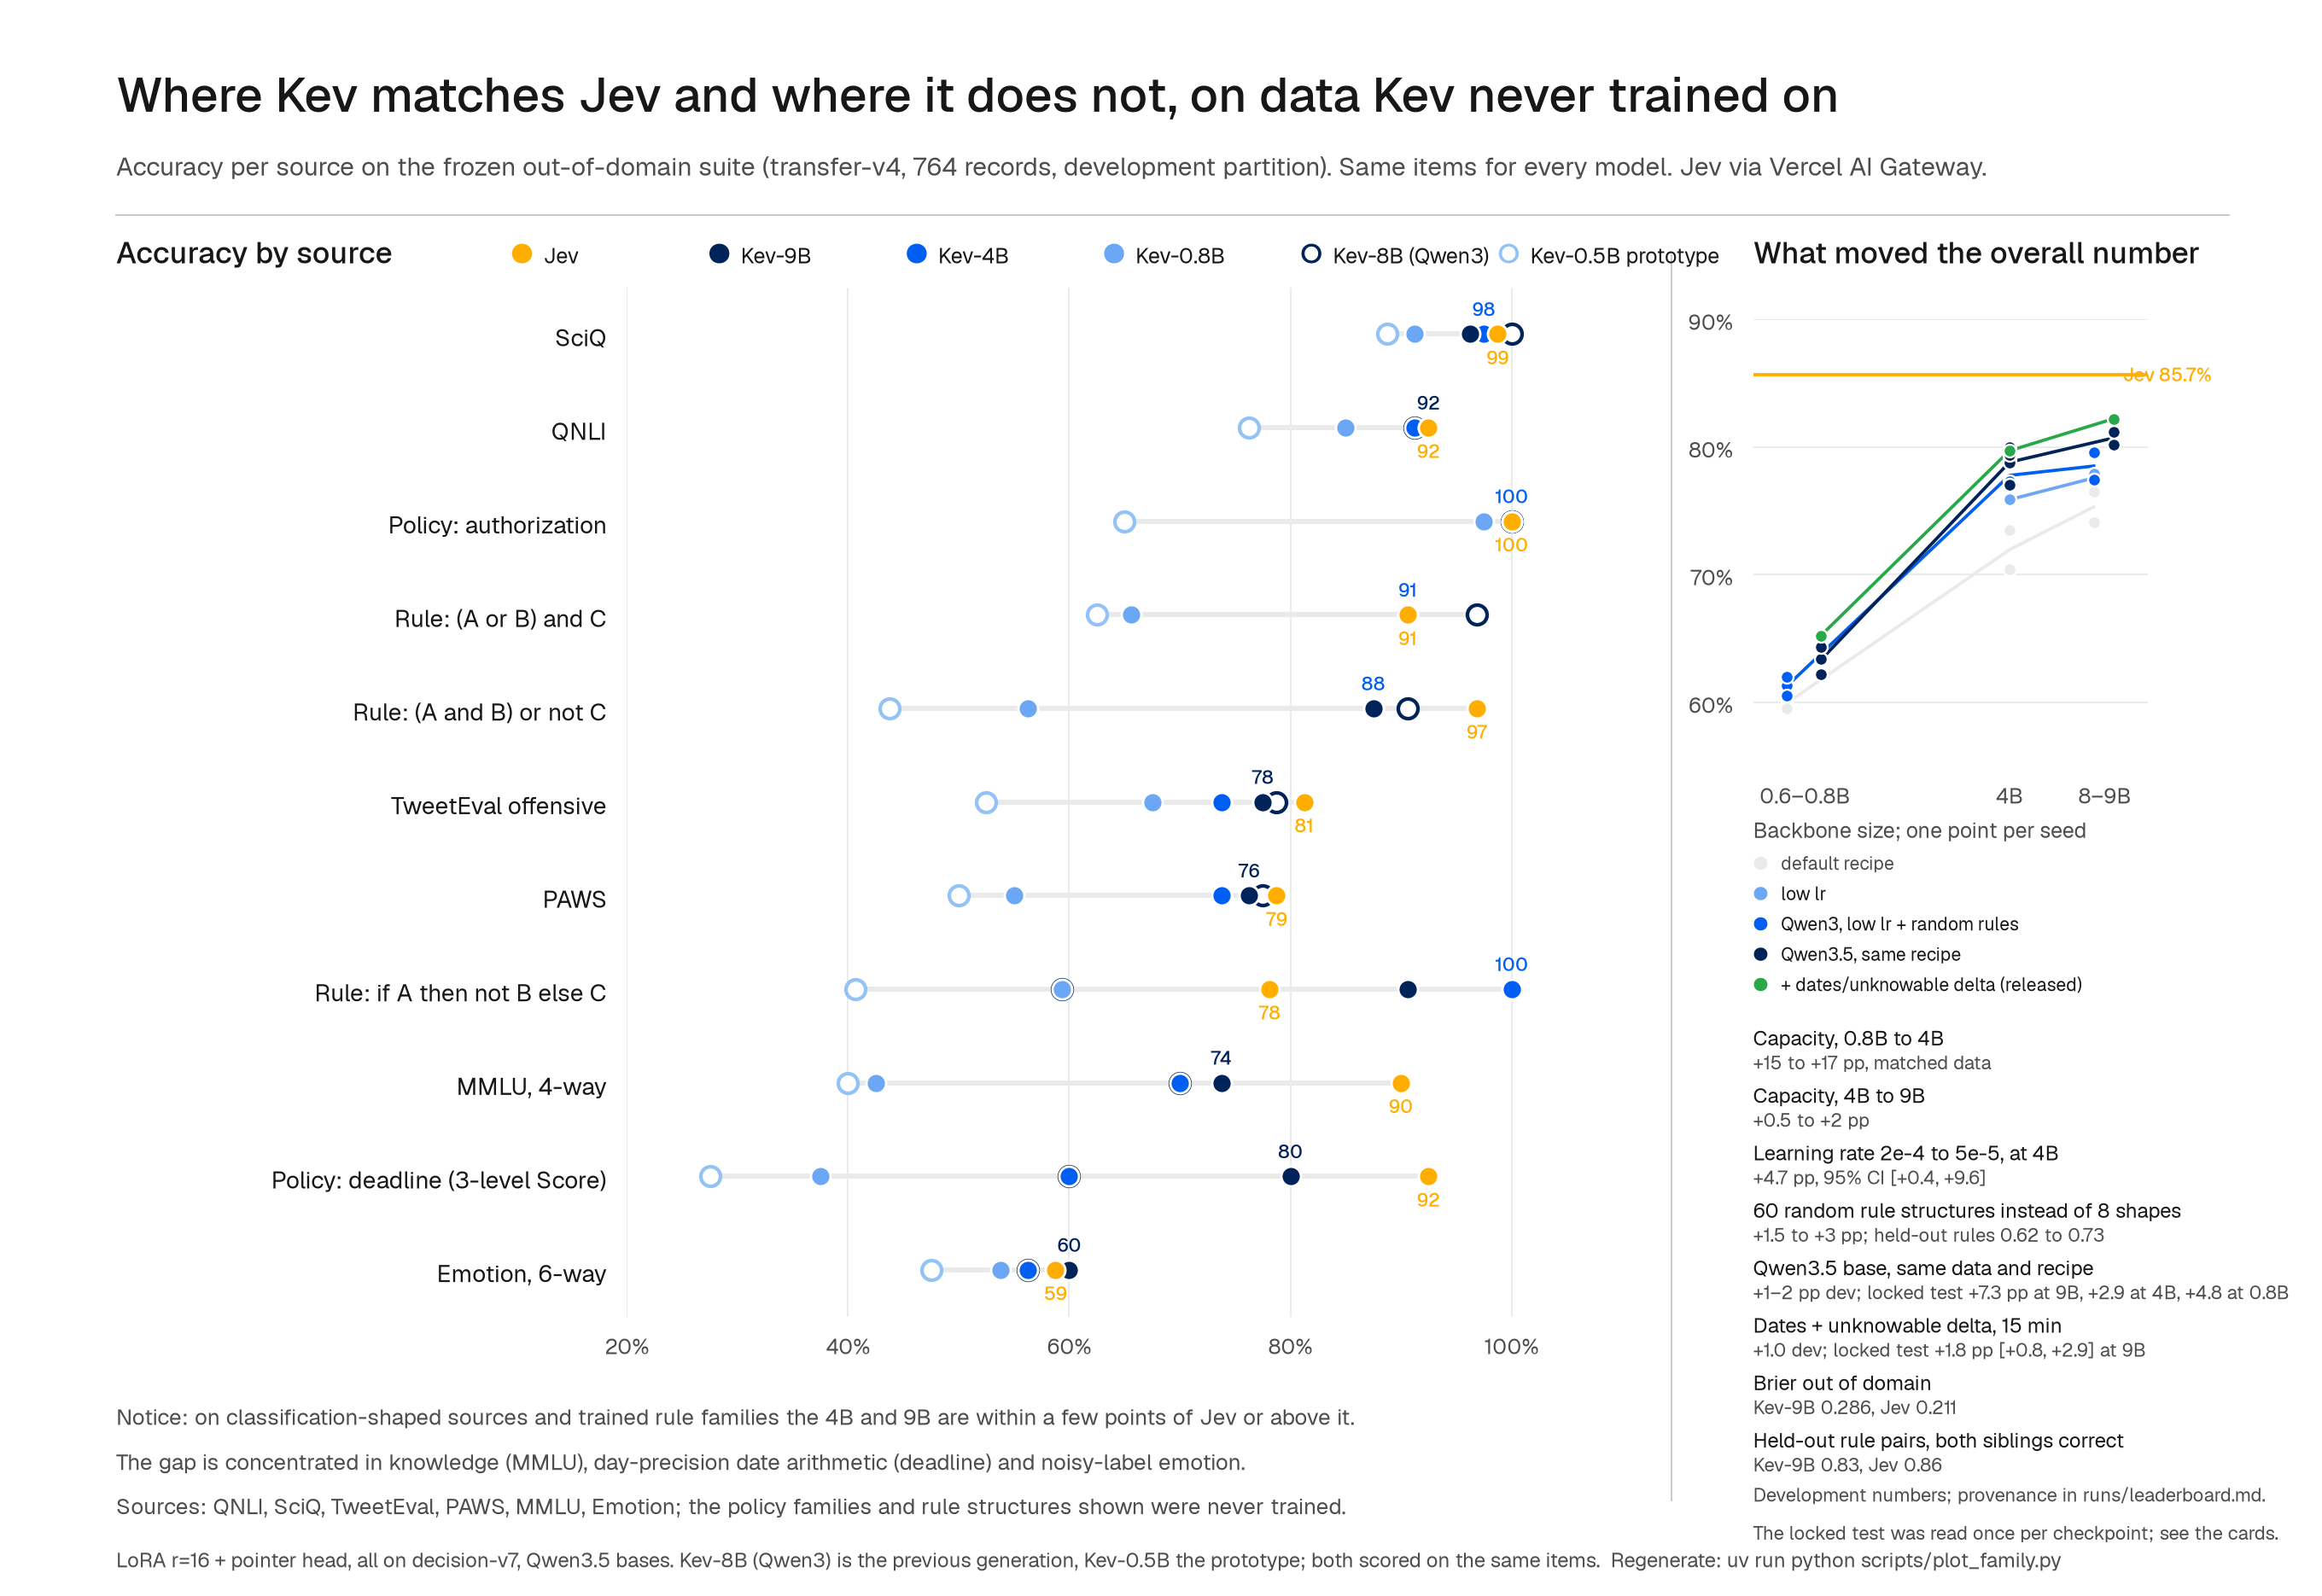
Formik과 Turborepo, 그리고 Vercel AI SDK를 만든 재러드 파머(Jared Palmer)가 공개한 Kev는 정확히 이 문제를 겨냥한 프로젝트예요. 알리바바의 오픈 모델 Qwen3.5의 작은 사이즈를 기반으로, 긴 답변을 생성하는 게 아니라 '판단만 내리는' 초소형 모델 패밀리를 만든 거예요. 이름에 붙은 'Jev-like'는 이런 콘셉트의 앞선 소형 결정 모델 계열을 따랐다는 의미로 보여요.
결정 모델이 뭐냐면
이게 뭐냐면, 보통 LLM은 '다음 단어를 계속 생성'하는 방식으로 동작해요. 질문을 주면 문장을 쭉 써 내려가죠. 결정 모델(decision model)은 이 생성 능력을 일부러 좁혀요. 입력을 읽고 나서 정해진 선택지 중 하나만 내놓도록 학습시키는 거예요. 예를 들어 '이 코드 리뷰 코멘트는 반드시 고쳐야 하는 문제인가?'라는 질문에 yes 또는 no 하나만 답하게 하는 식이죠.
이렇게 하면 몇 가지가 좋아져요. 첫째, 출력 토큰이 한두 개라서 응답이 거의 즉시 나와요. 둘째, 모델이 작아서 GPU 없이 CPU나 노트북에서도 돌아가요. 셋째, 출력이 선택지로 고정되니까 파싱이 쉽고, 선택지별 확률(로짓)을 꺼내보면 '얼마나 확신하는지'까지 숫자로 얻을 수 있어요. 예를 들어 yes 확률이 0.95면 자동으로 넘기고, 0.55면 큰 모델에게 다시 물어보는 식의 설계가 가능해지는 거죠.
왜 Qwen3.5 위에 만들었을까요? 아주 작은 크기의 오픈 모델 중에서 지시를 잘 따르고 다국어 성능이 괜찮은 게 Qwen 계열이거든요. 예전 방식인 BERT 계열 분류기는 빠르긴 하지만, 새로운 종류의 판단을 시키려면 매번 데이터를 모아 다시 학습해야 했어요. 반면 LLM 기반 결정 모델은 프롬프트로 '이런 기준으로 판단해'라고 설명만 해줘도 어느 정도 따라오기 때문에, 분류기의 속도와 LLM의 유연함을 절충한 위치에 있어요.
어떻게 만드는 걸까
이런 결정 모델은 보통 '증류(distillation)' 방식으로 만들어요. 큰 모델에게 수만 개의 사례를 판단시켜 정답 라벨을 만든 다음, 작은 모델이 그 판단을 흉내 내도록 파인튜닝하는 거예요. 큰 모델의 판단력을 작은 몸집에 눌러 담는다고 생각하면 돼요. 여기에 판단 결과가 맞았는지에 따라 보상을 주는 강화학습을 얹기도 해요. 핵심은 '모든 걸 잘하는 모델'이 아니라 '한 종류의 판단을 빠르고 일관되게 하는 모델'을 목표로 한다는 점이에요.
실제 에이전트 파이프라인에 넣으면 이런 그림이 돼요.
1. 사용자 입력이 들어오면 Kev가 먼저 '위험한 입력인가?'를 판단해요. 아니라면 통과.
2. 다음 Kev가 '어떤 에이전트로 보낼까?'를 판단해요. 예를 들어 coding.
3. 여기서만 큰 모델이 실제 작업을 수행해요.
4. 마지막으로 Kev가 '작업이 끝났나?'를 판단하고, 끝났으면 결과를 반환해요.
큰 모델은 진짜 생성이 필요한 한 군데에서만 쓰고, 나머지 분기점은 전부 밀리초 단위의 작은 모델이 처리하는 구조예요.
업계 맥락: 작은 판단 모델의 유행
이 방향은 파머 혼자만의 아이디어는 아니에요. 메타의 Llama Guard나 구글의 ShieldGemma는 '이 입력이 안전한가'라는 한 가지 판단만 하는 소형 모델이고, RouteLLM이나 Katanemo의 Arch-Router 같은 프로젝트는 '어떤 모델로 보낼까'라는 라우팅 판단에 집중해요. 그리고 요즘 흔히 쓰는 'LLM-as-a-judge'라는 평가 방식도 사실상 큰 모델을 결정 모델처럼 쓰는 거예요. Kev가 다른 점은 특정 용도 하나가 아니라 여러 종류의 판단을 위한 소형 모델을 패밀리로 묶고, 프론트엔드와 풀스택 개발자에게 익숙한 방식으로 쓰기 쉽게 풀어냈다는 점이에요. Vercel AI SDK를 만든 사람답게, 에이전트 개발자가 실제로 겪는 지점에서 출발한 거죠.
큰 흐름으로 보면 이건 '모든 걸 하나의 거대 모델에게 맡기는 시대'에서 '큰 모델 하나와 작은 모델 여러 개를 조합하는 시대'로 가는 신호이기도 해요. CPU 아키텍처에서 고성능 코어와 저전력 코어를 섞어 쓰는 것처럼요.
한국 개발자에게
한국에서 에이전트 서비스를 만드는 팀이라면 당장 적용해 볼 만한 이야기예요. 특히 토큰 비용이 원화로 환산되면 꽤 부담스러운데, 판단 단계를 소형 모델로 바꾸면 비용과 지연 시간을 동시에 줄일 수 있거든요. Qwen 계열은 한국어 성능도 준수한 편이라 한국어 입력에 대한 판단도 시도해 볼 만해요. 다만 도메인이 특수하다면 자기 데이터로 추가 파인튜닝이 필요할 수 있고, 판단 정확도를 큰 모델과 비교하는 평가 세트를 먼저 만들어두는 게 중요해요. 작은 모델이 틀리면 그 뒤의 파이프라인 전체가 엉뚱한 길로 가니까요.
한줄 정리: Kev는 Qwen3.5 기반으로 '생성 대신 판단'만 하는 초소형 모델 패밀리이고, 에이전트의 분기점을 싸고 빠르게 만드는 접근이에요.
여러분의 에이전트 파이프라인에서 큰 모델이 하고 있는 일 중 '사실은 예/아니오면 충분한' 판단은 얼마나 되나요?
🔗 출처: Hacker News