무슨 일이 있었나요
AI 워크로드 실행 플랫폼 SkyPilot 팀이 “그레이스 블랙웰(Grace Blackwell)에는 새로운 스케줄러가 필요하다”는 글을 공개했어요. 핵심 주장은 GPU 랙을 더 사지 않아도 스케줄링 방식만 바꾸면 실제로 쓸 수 있는 GPU가 27% 늘어난다는 거예요.
GPU 한 장에 수천만 원씩 하는 시대에 27%면 엄청난 숫자예요. 그런데 스케줄러 하나로 왜 이렇게 차이가 날까요? 이걸 이해하려면 엔비디아의 GB200 NVL72가 기존 GPU 서버와 뭐가 다른지부터 알아야 해요.
GB200 NVL72는 ‘랙 전체가 한 대의 컴퓨터’예요
DGX H100 같은 기존 GPU 서버는 한 대에 GPU 8장이 들어가고, 이 8장끼리만 NVLink라는 초고속 전용 통로로 연결돼 있었어요. 서버끼리는 InfiniBand나 이더넷 같은 네트워크로 통신했고요. NVLink가 고속도로라면 서버 간 네트워크는 국도쯤 되는 셈이에요.
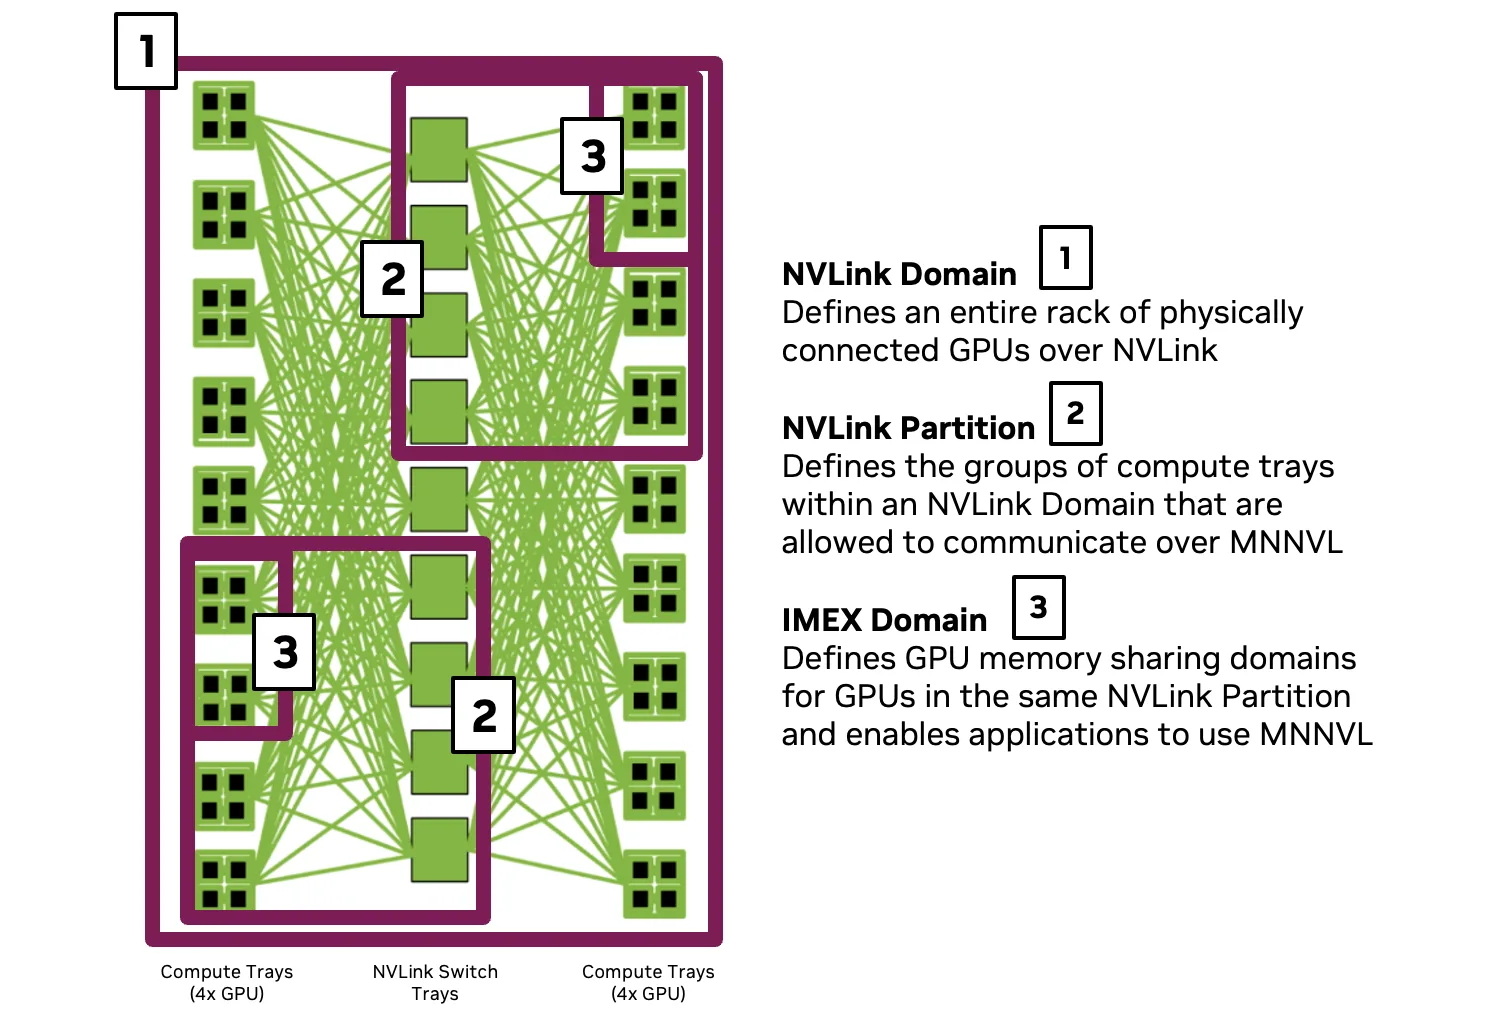
GB200 NVL72는 이 경계를 랙 단위까지 넓혔어요. 랙 하나에 Grace CPU 36개와 Blackwell GPU 72장이 들어가는데, 이 72장이 전부 NVLink로 연결된 하나의 도메인이에요. 물리적으로는 GPU가 4장씩 들어간 컴퓨트 트레이 18개로 나뉘어 있지만, NVLink 스위치 트레이를 거쳐 72장이 모두 고속도로로 이어져 있어요. 큰 모델을 학습하거나 추론할 때는 GPU끼리 주고받는 데이터가 어마어마해서, 작업이 이 고속도로 안에 들어가느냐 아니냐가 성능을 크게 좌우해요.
기존 스케줄러가 뭐가 문제냐면
쿠버네티스 같은 기존 스케줄러는 기본적으로 노드(서버) 단위로 생각해요. NVL72에서는 보통 컴퓨트 트레이 하나가 노드 하나로 보이니까, 랙 하나가 GPU 4장짜리 노드 18개로 보이는 거예요. 스케줄러는 이 노드들이 같은 NVLink 도메인에 있다는 사실을 기본적으로 몰라요.
그래서 생기는 문제가 단편화(fragmentation)예요. 테트리스를 떠올려 보세요. 빈칸을 다 합치면 충분한데 모양이 안 맞아서 블록을 못 넣는 상황이요. 예를 들어 랙 A에 빈 노드가 3개, 랙 B에 2개 있으면 빈 GPU는 모두 20장이에요. 그런데 같은 NVLink 도메인 안에서 GPU 16장(노드 4개)이 필요한 작업이 들어오면 어느 랙에도 못 들어가요. 결국 GPU 20장이 그냥 놀게 되죠. 반대로 스케줄러가 토폴로지(GPU들이 어떻게 연결돼 있는지)를 모른 채 작업을 두 랙에 걸쳐 배치하면, 작업은 돌아가지만 랙 사이 통신이 느린 국도를 타서 성능이 떨어져요.
장애 문제도 겹쳐요. 랙 안의 트레이 하나가 고장 나면 그 랙은 72장이 아니라 68장짜리 도메인이 돼요. 이렇게 일부가 빠진 랙까지 고려해서 작업을 잘 채워 넣어야 버려지는 GPU가 줄어들어요.
SkyPilot이 말하는 27%는 이런 낭비를 줄여서, 같은 랙에서 실제 작업에 쓰이는 GPU 비율을 끌어올린 결과라고 이해하면 돼요. 구체적인 실험 조건과 알고리즘은 원문에서 확인해 보세요.
업계 흐름: 스케줄러가 ‘토폴로지’를 알아야 하는 시대
이 문제를 고민하는 건 SkyPilot만이 아니에요. 엔비디아는 쿠버네티스 DRA(Dynamic Resource Allocation, GPU 같은 특수 자원을 더 세밀하게 나눠주는 기능)용 드라이버에서 여러 노드를 묶어 하나의 NVLink 도메인처럼 쓰는 ‘ComputeDomain’ 개념을 내놨어요. Run:ai를 인수한 뒤 오픈소스로 공개한 KAI Scheduler도 토폴로지를 인식해 배치하는 방향으로 가고 있고요. HPC 쪽 강자인 Slurm도 블록 단위 토폴로지 배치를 지원하기 시작했어요. Kueue나 Volcano 같은 프로젝트는 여러 파드를 ‘다 같이 뜨거나 아예 안 뜨게’ 만드는 갱 스케줄링(gang scheduling)을 제공해요.
흐름은 분명해요. GPU가 몇 장 남았는지가 아니라 어떤 GPU들이 어떻게 연결돼 있는지를 보고 배치해야 한다는 거예요. 하드웨어가 랙 단위로 진화하고, 소프트웨어가 그걸 따라가는 중이라고 보면 돼요.
한국 개발자에게 주는 시사점
국내에서도 대규모 GPU 도입 소식이 이어지고 있어요. 정부의 AI 컴퓨팅 인프라 사업이나 대기업, 클라우드 사업자의 블랙웰 도입 계획이 현실화되면 이런 랙 단위 시스템을 운영하는 팀도 늘어날 거예요. 비싼 GPU를 사 놓고 스케줄링 때문에 4분의 1을 놀린다면 그만큼 고스란히 손해니까요.
MLOps나 인프라 엔지니어라면 쿠버네티스 DRA, 토폴로지 인식 스케줄링, 갱 스케줄링 개념은 지금 공부해 둘 가치가 충분해요. 모델 개발자라도 “내 학습 작업이 NVLink 도메인 하나 안에 들어가는 크기인가?”를 생각하면서 작업 크기를 정하면 대기 시간과 성능 양쪽에서 이득을 볼 수 있어요.
마무리
한줄 정리: GPU가 랙 단위로 묶이는 시대에는 ‘몇 장 남았나’보다 ‘어떻게 연결돼 있나’를 아는 스케줄러가 곧 비용 절감이에요.
여러분 팀은 GPU 클러스터 스케줄링을 어떻게 하고 계세요? 쿠버네티스 기본 스케줄러로 충분했나요, 아니면 따로 도구를 쓰고 계신가요?
🔗 출처: Hacker News